現在我們已經準備好評估資料集,是時候建構核心評估流程了。這包括取出每個測試案例,將其與我們的提示合併,餵給 Claude,然後對結果進行評分。
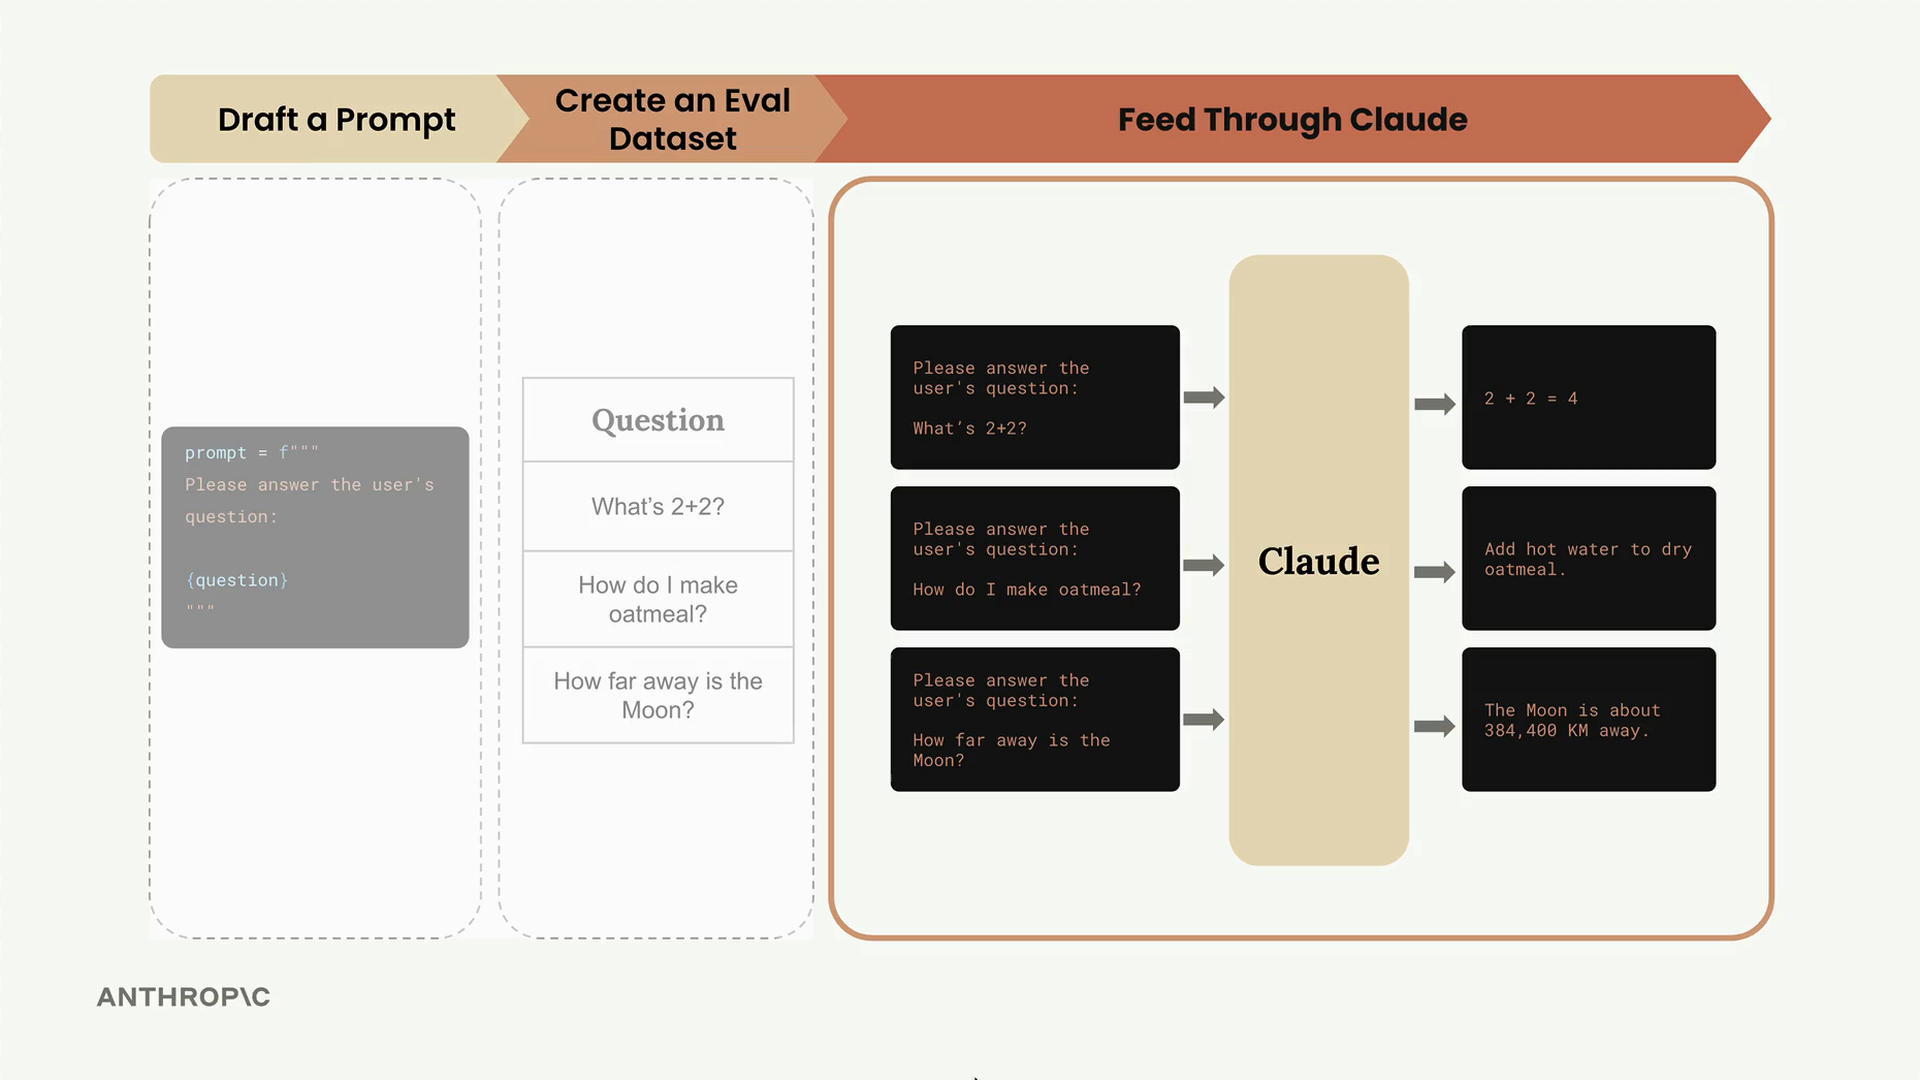
評估流程遵循一個清晰的工作流程:我們取得測試案例資料集,將每個案例與我們的提示範本結合,傳送給 Claude 處理,然後使用評分系統評估輸出結果。
建構核心函式
評估流程由三個主要函式組成,每個函式都有特定的職責。讓我們從最簡單的開始——處理個別提示的函式。
run_prompt 函式
此函式取一個測試案例,並將其與我們的提示範本合併:
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
目前,我們將提示保持極為簡單。我們沒有包含任何格式指示,因此 Claude 很可能會回傳比我們需要的更冗長的輸出。我們稍後在迭代提示設計時會加以改進。
run_test_case 函式
此函式協調執行單一測試案例並對結果進行評分:
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # 待辦 - 評分
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
目前,我們使用硬編碼的分數 10。評分邏輯是我們在後續章節中會花費大量時間的部分,但這個佔位符讓我們可以測試整體流程。
run_eval 函式
此函式協調整個評估流程:
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
此函式處理資料集中的每一個測試案例,並將所有結果收集到單一清單中。
執行評估
要執行我們的評估流程,我們載入資料集並透過我們的函式執行:
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
第一次執行時,預期會花費一些時間——即使使用 Claude Haiku,處理完整資料集也可能需要大約 30 秒。我們稍後會介紹優化技巧。
檢視結果
評估會回傳一個結構化的 JSON 陣列,其中每個物件代表一個測試案例的結果:
print(json.dumps(results, indent=2))
每個結果包含三項關鍵資訊:
- output:Claude 的完整回應
- test_case:被處理的原始測試案例
- score:評估分數(目前為硬編碼)
正如您在輸出中看到的,由於我們尚未提供具體的格式指示,Claude 生成的回應相當冗長。這正是我們在改進提示時要處理的問題。
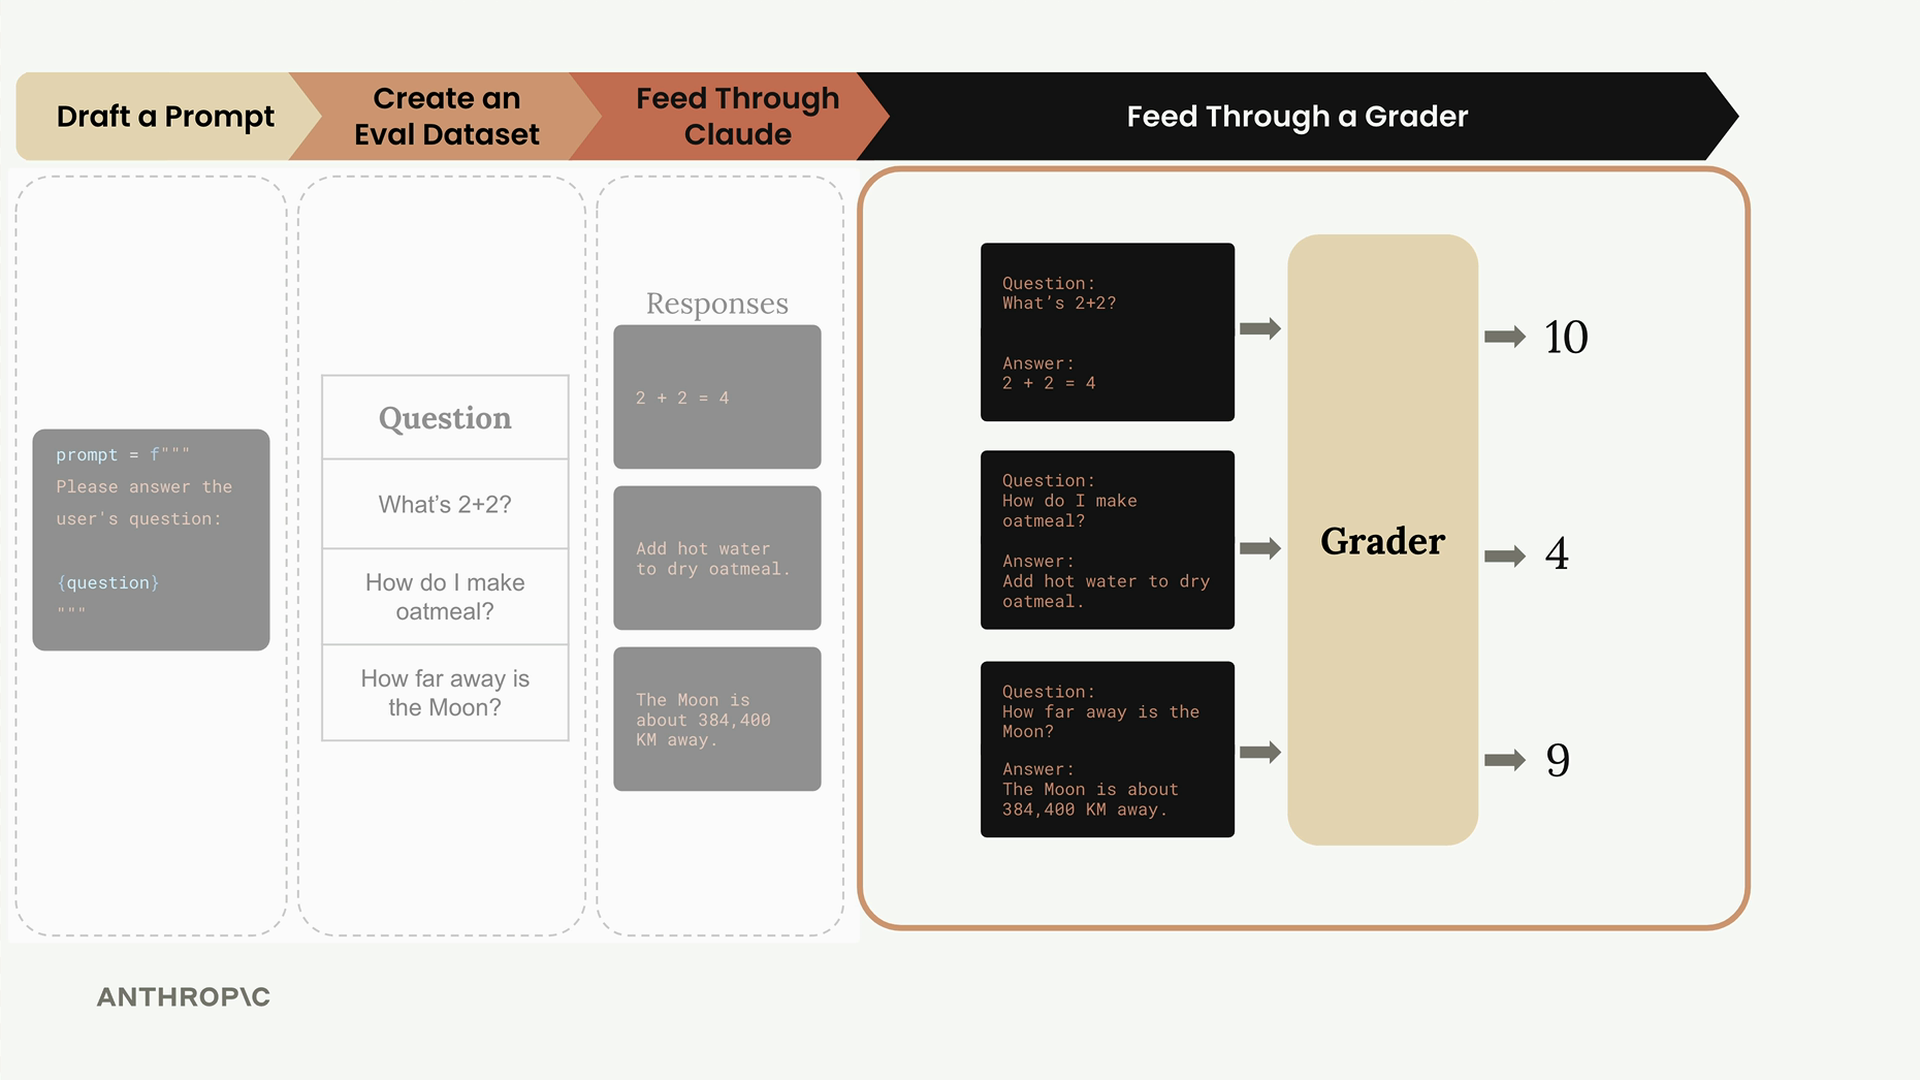
我們已完成的工作
到目前為止,我們已成功建構了核心評估流程。我們可以取得資料集,透過 Claude 處理,並收集結構化的結果。目前缺少的主要部分是評分系統——那個硬編碼的分數 10 需要用實際的評估邏輯來取代。
這個流程代表了大多數 AI 評估系統的基礎。雖然它看起來很簡單,但您剛剛已經建構了評估流程實際運作中的大部分內容。複雜之處在於細節——更好的提示、更精密的評分,以及效能優化。
接下來,我們將深入探討評分器這個關鍵主題,它會將我們硬編碼的分數轉變為對 Claude 表現有意義的評估。