載入中
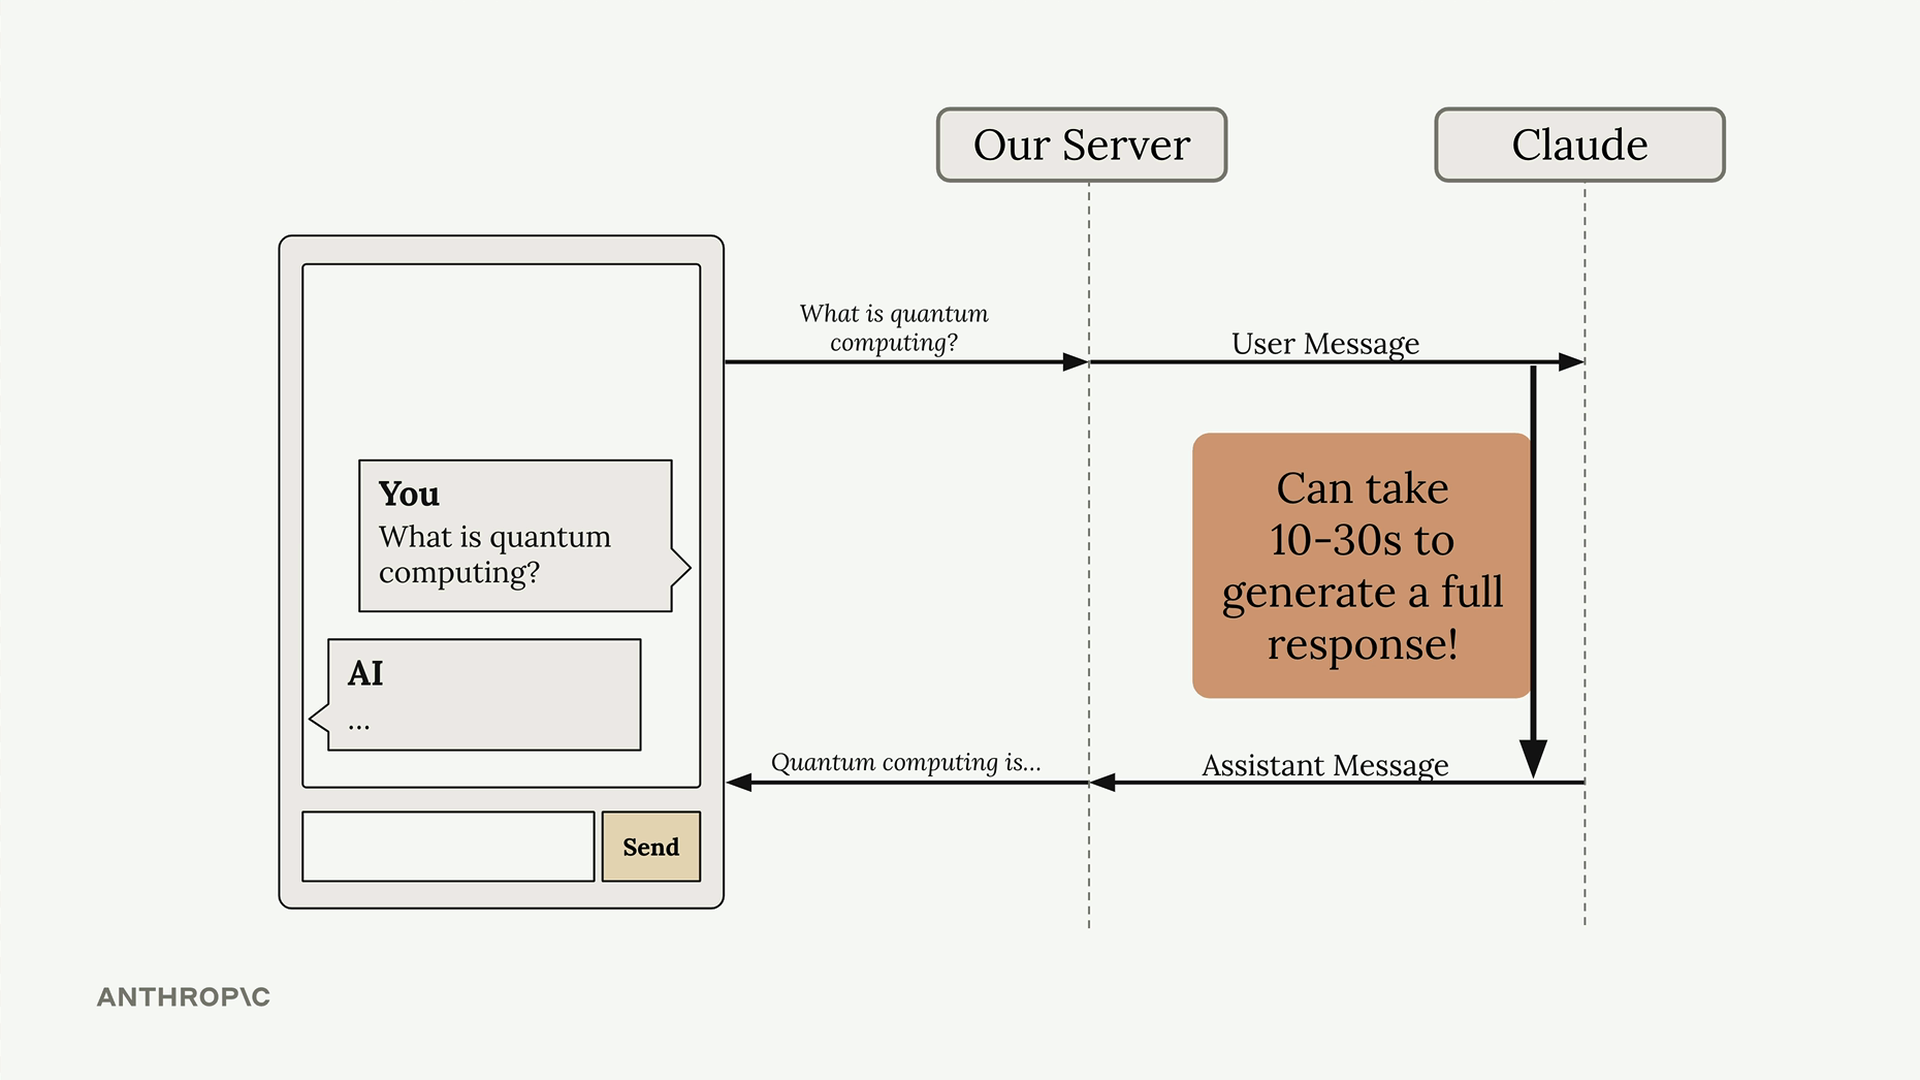
在使用 Claude 建構聊天應用程式時,存在一個重大的使用者體驗挑戰:回應可能需要 10 到 30 秒才能生成,讓使用者只能盯著載入圖示等待。解決方案是回應串流,這讓使用者能夠看到文字隨著 Claude 生成時一塊一塊地出現,創造出更具回應性的體驗。
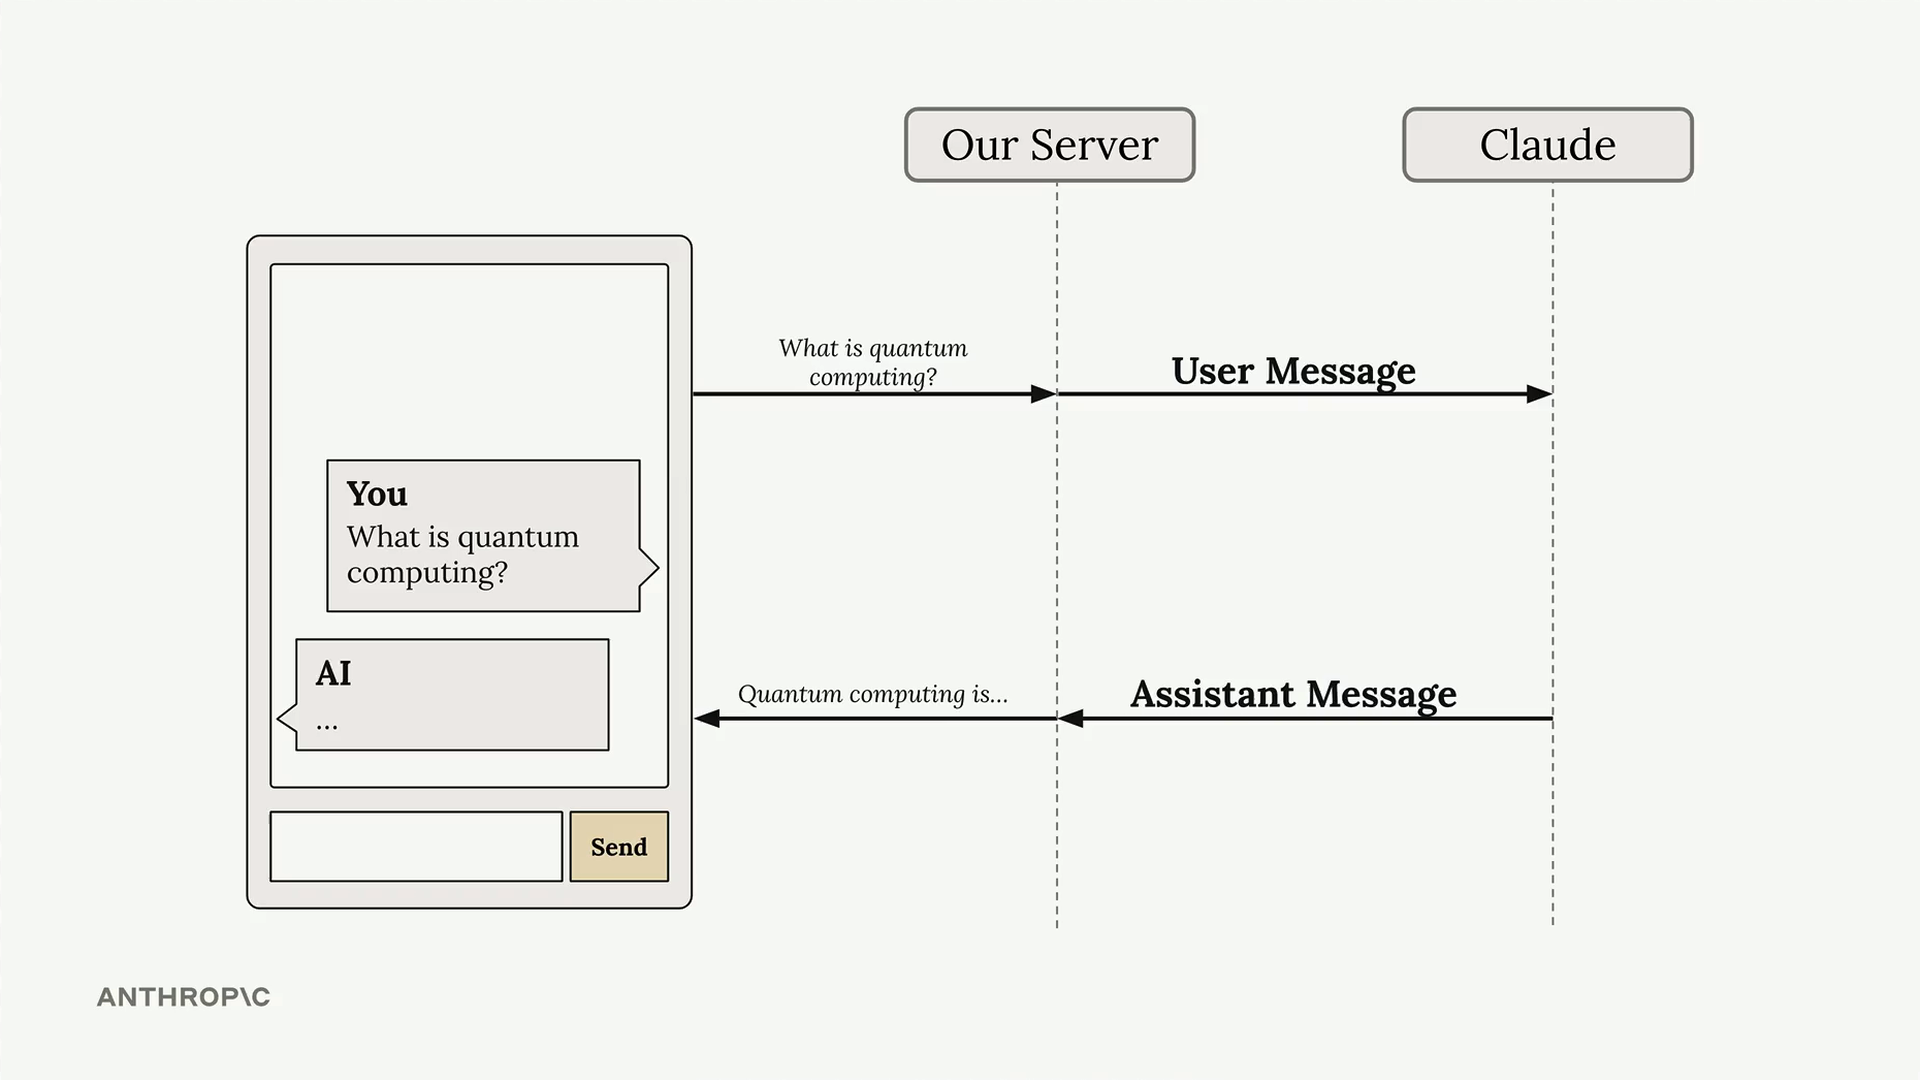
標準回應的問題
在典型的聊天設定中,您的伺服器將使用者訊息傳送給 Claude,並等待完整回應後才將任何內容傳回客戶端。這會造成令人不自在的延遲,使用者在此期間完全沒有任何事情正在發生的回饋。
串流的運作方式
啟用串流後,Claude 會立即傳回一個初始回應,表示已收到您的請求並開始生成文字。接著您會收到一系列事件,每個事件都包含整體回應的一小部分。
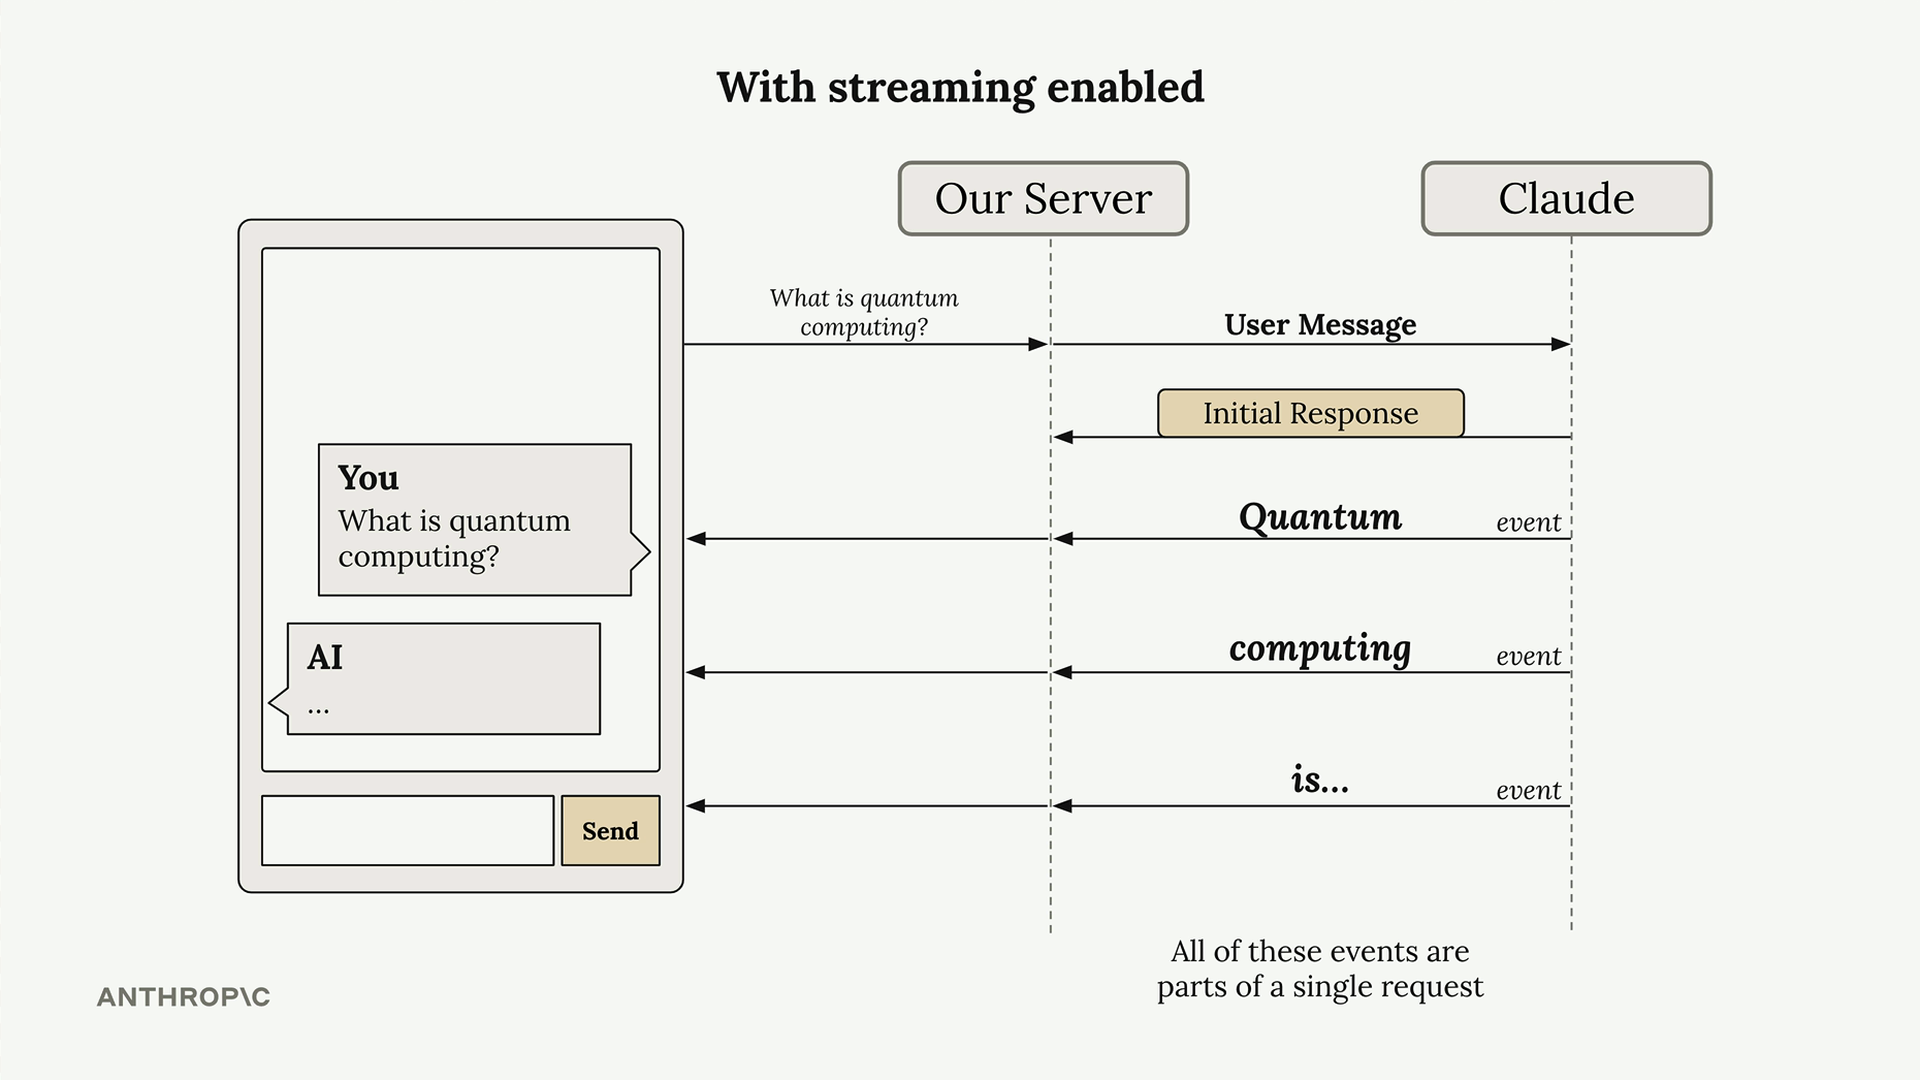
您的伺服器可以在這些文字區塊到達時將其轉發給您的客戶端應用程式,讓使用者能夠逐字看到回應逐漸建構出來。所有這些事件都屬於對 Claude 的單一請求的一部分。
理解串流事件
當您啟用串流時,Claude 會傳回多種類型的事件:
- MessageStart - 正在傳送新訊息
- ContentBlockStart - 包含文字、工具使用或其他內容的新區塊的開始
- ContentBlockDelta - 實際生成文字的區塊
- ContentBlockStop - 目前內容區塊已完成
- MessageDelta - 目前訊息已完成
- MessageStop - 目前訊息相關資訊的結束
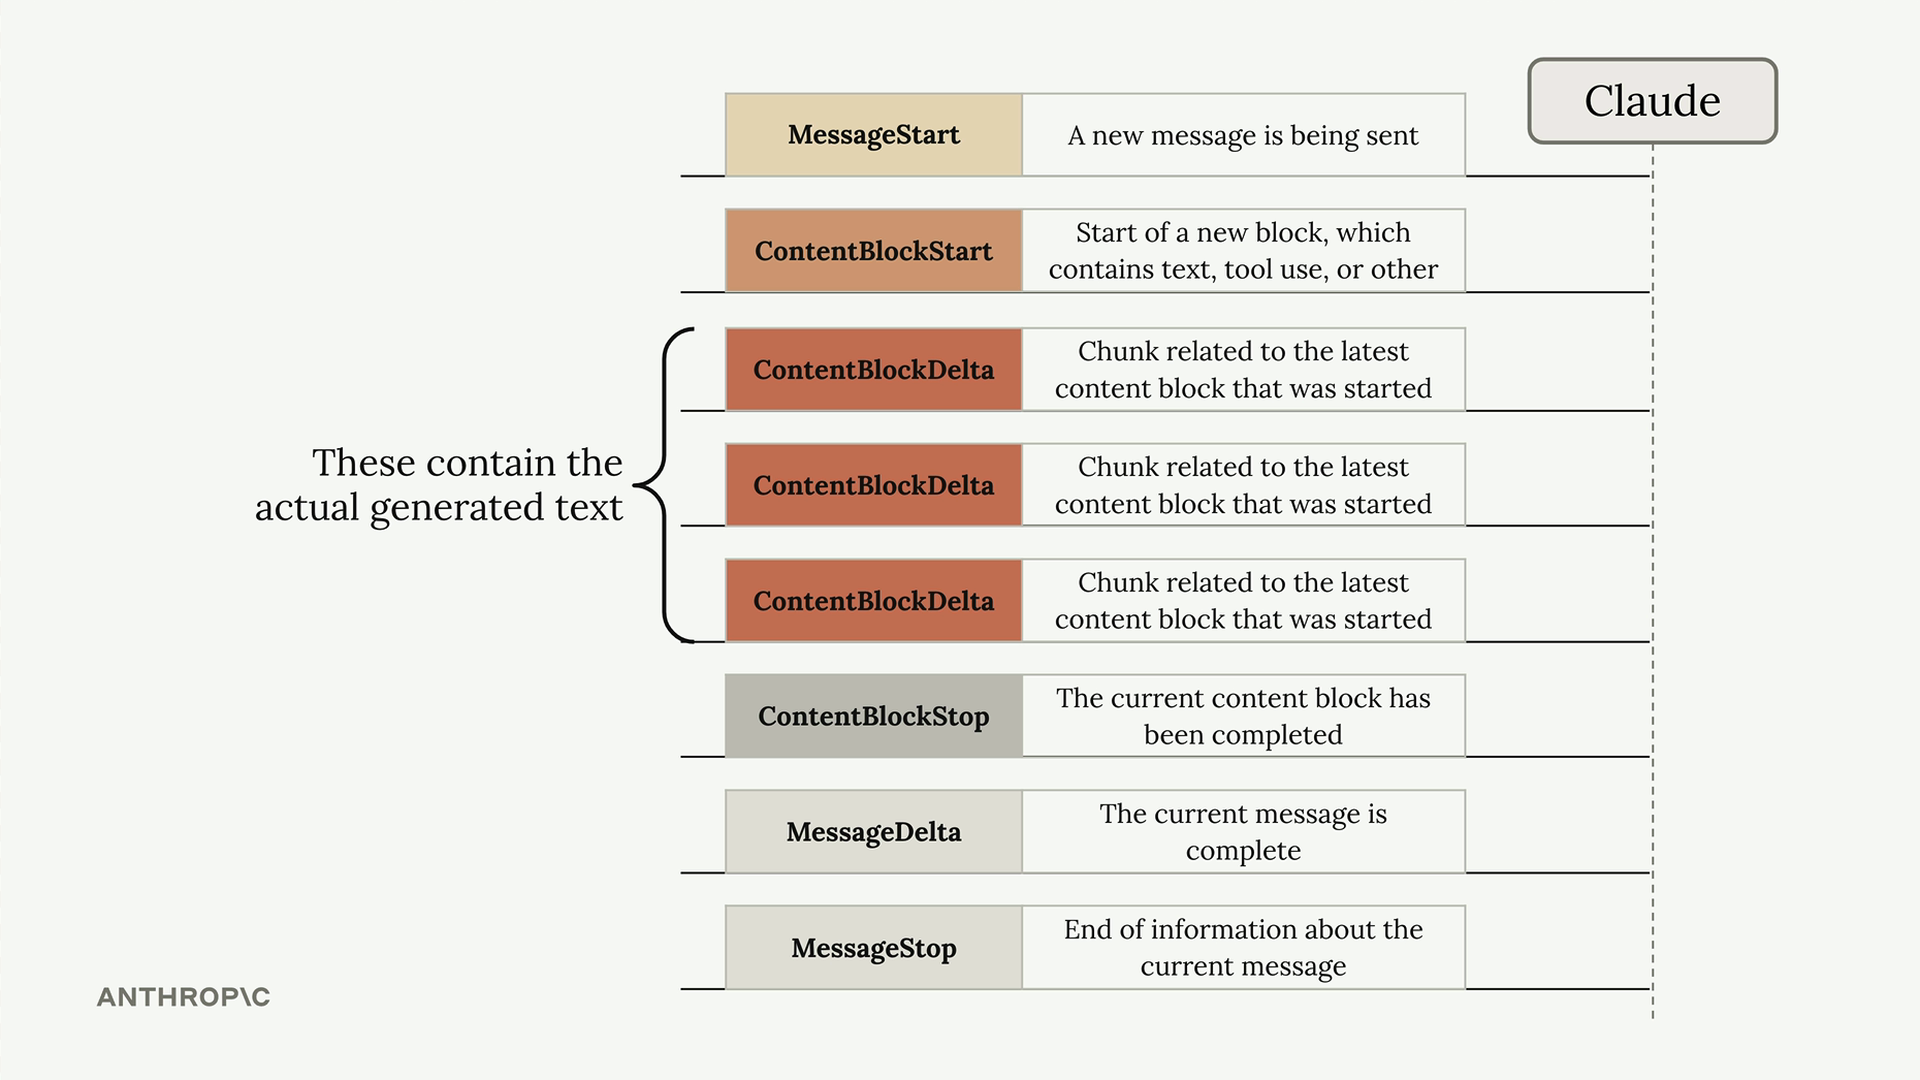
ContentBlockDelta 事件包含您想要顯示給使用者的實際生成文字。
基本串流實作
若要啟用串流,請在您的 messages.create 呼叫中新增 stream=True:
python
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")

stream = client.messages.create(
    model=model,
    max_tokens=1000,
    messages=messages,
    stream=True
)

for event in stream:
    print(event)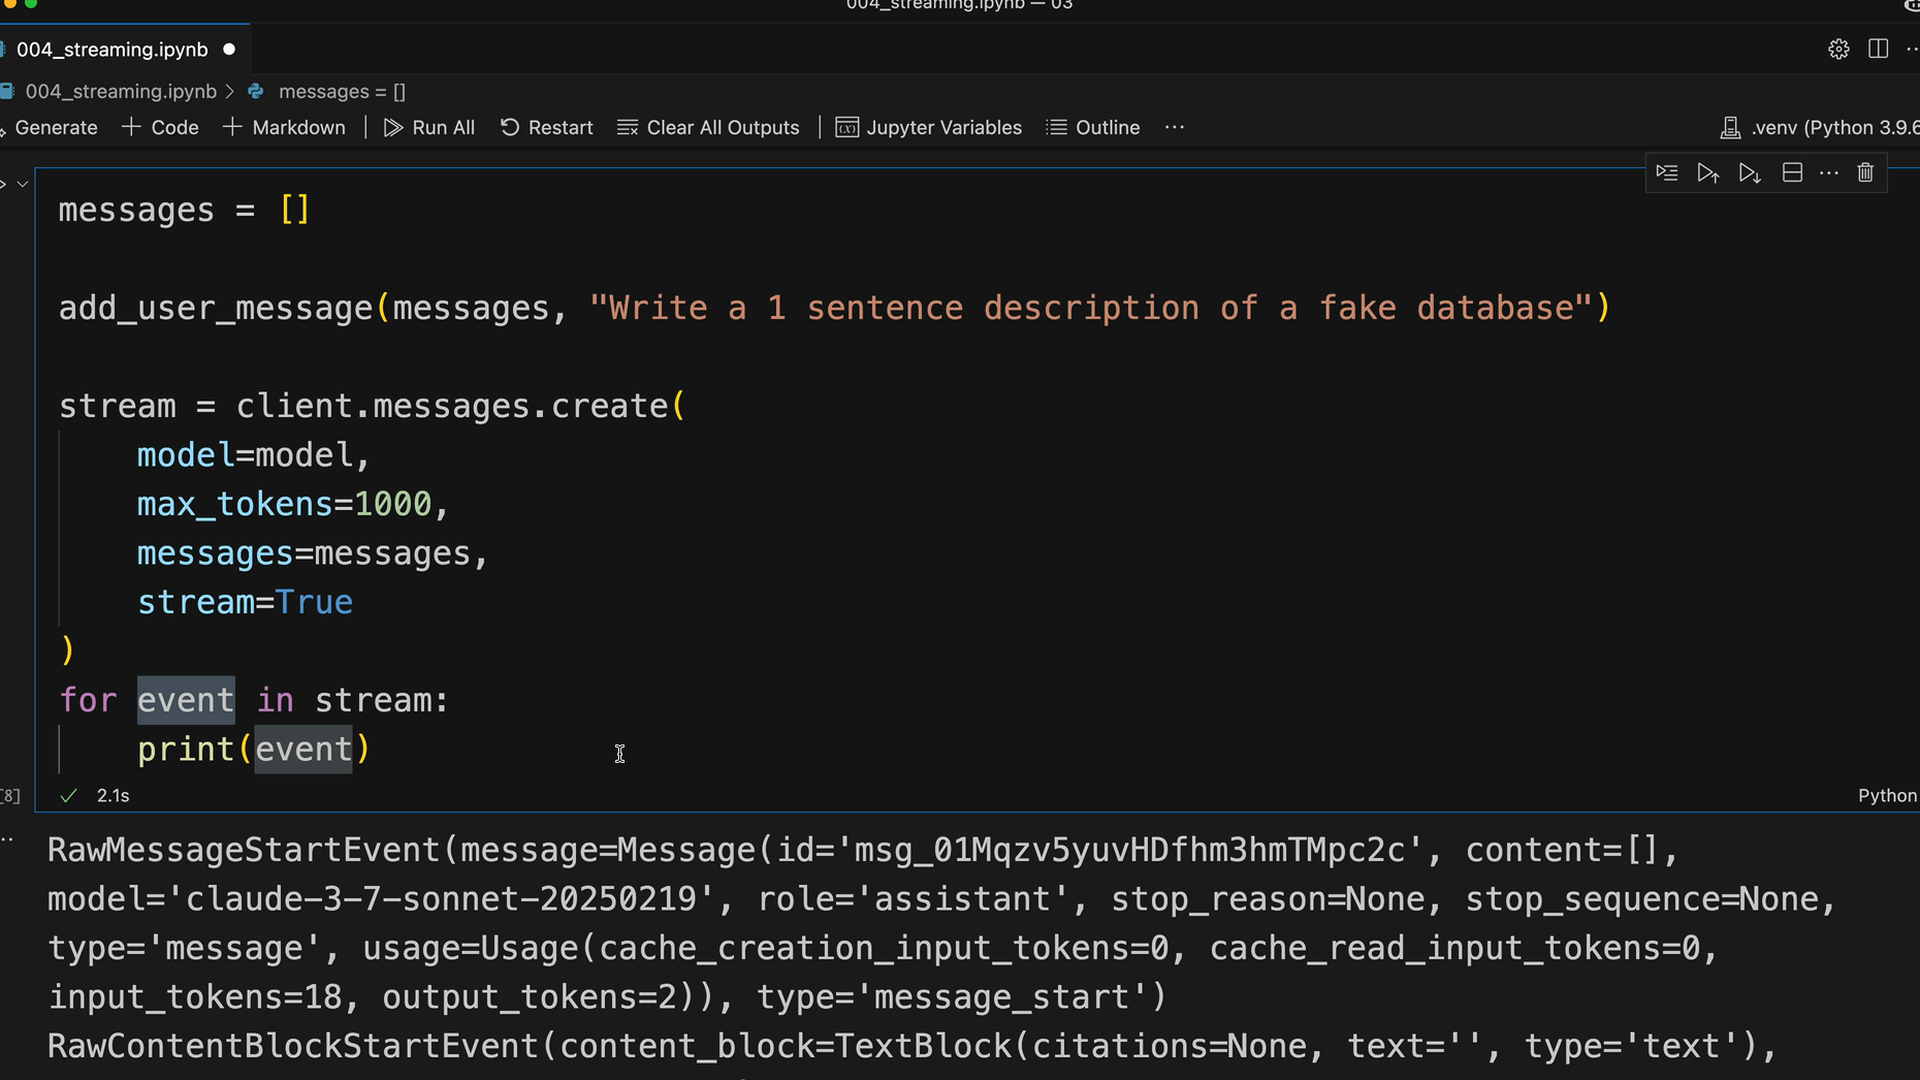
簡化的文字串流
與其手動解析事件,您可以使用 SDK 提供的簡化串流介面,它只會擷取實際的文字內容:
python
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        print(text, end="")
此方法會自動篩除除實際文字內容以外的所有內容,而這通常正是您在向使用者顯示回應時所需要的。
取得完整訊息
雖然串流個別區塊對使用者體驗來說非常好,但您通常需要完整的訊息以進行儲存或進一步處理。串流完成後,您可以取得組合完成的最終訊息:
python
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        # 將每個區塊傳送給您的客戶端
        pass

    # 取得完整訊息以供資料庫儲存
    final_message = stream.get_final_message()
這讓您兩全其美:為使用者提供即時串流,同時也為您的應用程式邏輯提供完整的訊息物件。