載入中
Claude 可以直接讀取和分析 PDF 檔案,使其成為文件處理的強大工具。這項功能的運作方式與圖像處理類似,但在程式碼結構上有幾個關鍵差異。
設定 PDF 處理
若要使用 Claude 處理 PDF 檔案,您會使用幾乎與處理圖像相同的程式碼。主要差異在於檔案類型規格以及為了清楚起見所使用的變數名稱。
以下說明如何修改您現有的圖像處理程式碼以處理 PDF:
python
with open("earth.pdf", "rb") as f:
    file_bytes = base64.standard_b64encode(f.read()).decode("utf-8")

messages = []

add_user_message(
    messages,
    [
        {
            "type": "document",
            "source": {
                "type": "base64",
                "media_type": "application/pdf",
                "data": file_bytes,
            },
        },
        {"type": "text", "text": "Summarize the document in one sentence"},
    ],
)

chat(messages)
與圖像處理的主要差異
在為 PDF 調整您的圖像處理程式碼時,您需要更新幾個元素:
- 將副檔名從
.png改為.pdf - 為了清楚起見,將變數名稱從
image_bytes改為file_bytes - 將類型設定為
"document"而非"image" - 將媒體類型改為
"application/pdf"而非"image/png"
Claude 可以從 PDF 中擷取什麼
Claude 的 PDF 處理能力不僅止於簡單的文字擷取。它可以分析和理解:
- 整份文件中的文字內容
- 嵌入在 PDF 中的圖像和圖表
- 表格及其資料關係
- 文件結構與格式
這使得 Claude 基本上成為從 PDF 文件中擷取任何類型資訊的一站式解決方案,無論您需要的是摘要、資料分析,還是特定內容擷取。
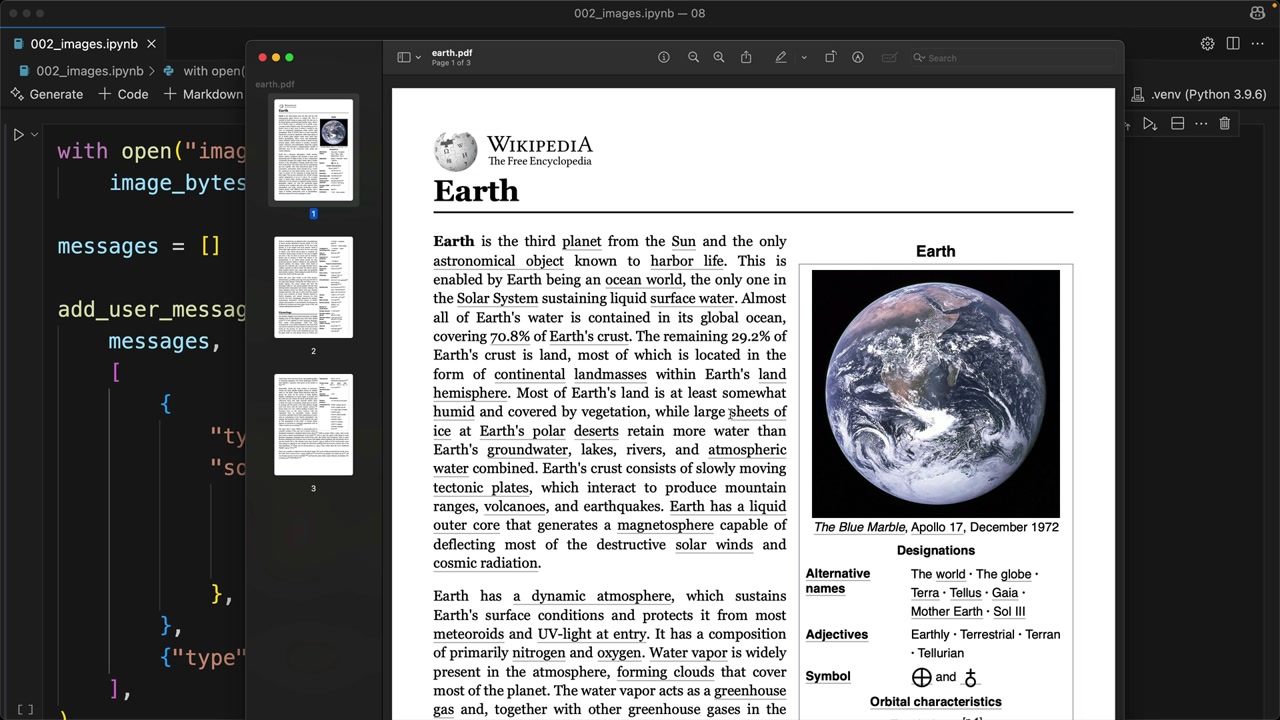
上面的範例顯示 Claude 成功處理了一篇以 PDF 格式儲存、關於地球的維基百科文章,展示了它如何在一句話中理解並摘要複雜的文件內容。