我們已經為語義搜尋(使用向量嵌入)和詞彙搜尋(使用 BM25)建立了獨立的實作。現在是時候將它們結合成一個統一的搜尋管線,充分利用這兩種方法的優勢了。
多索引架構
我們的 VectorIndex 和 BM25Index 類別共享幾乎相同的 API——它們都有 add_document() 和 search() 方法。這種一致性使得將它們包裝在一起成為一個名為 Retriever 的新類別變得很簡單。
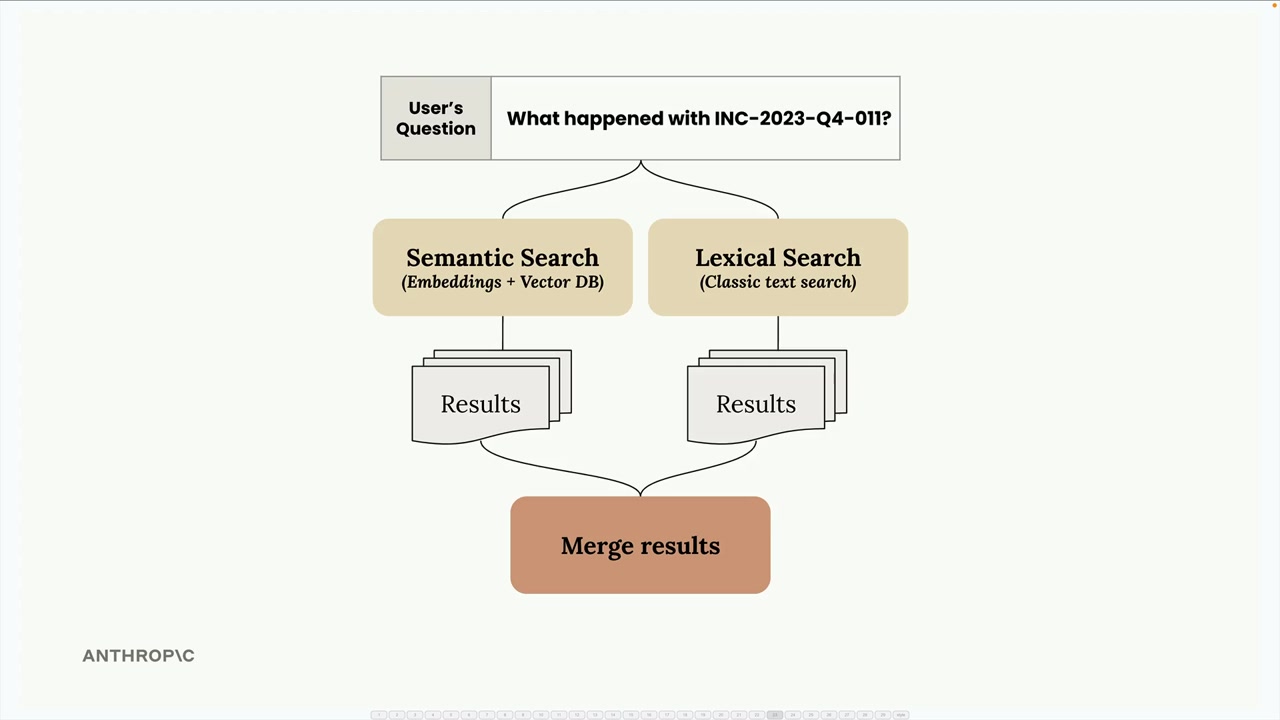
Retriever 扮演協調者的角色,將使用者查詢轉發給兩個索引,收集它們的結果,並使用一種稱為倒數排名融合(reciprocal rank fusion)的技術將結果合併。
理解倒數排名融合
合併不同搜尋方法的結果並不像簡單地串接清單那麼簡單。每種方法使用不同的評分系統,因此我們需要一種方法來公平地標準化並結合它們的排名。
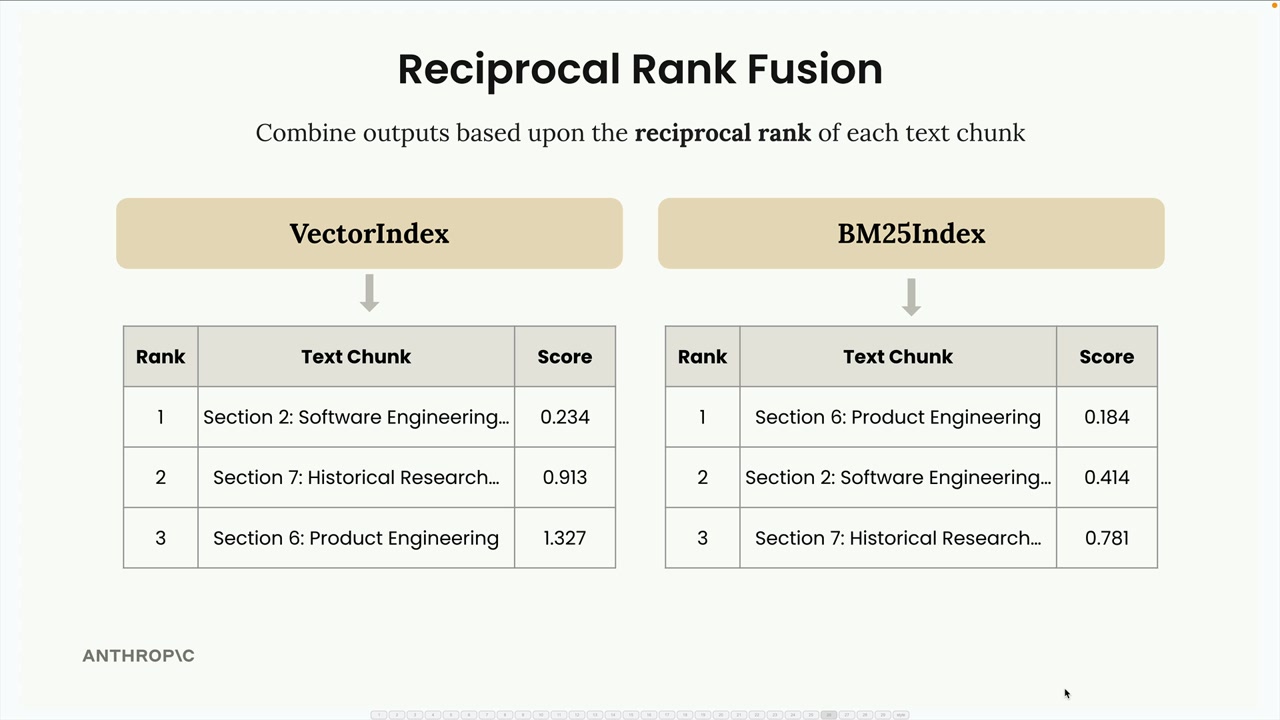
以下是一個範例,說明倒數排名融合的運作方式。假設我們搜尋有關「INC-2023-Q4-011」的資訊,得到以下結果:
- VectorIndex 回傳:第 2 節(排名 1)、第 7 節(排名 2)、第 6 節(排名 3)
- BM25Index 回傳:第 6 節(排名 1)、第 2 節(排名 2)、第 7 節(排名 3)
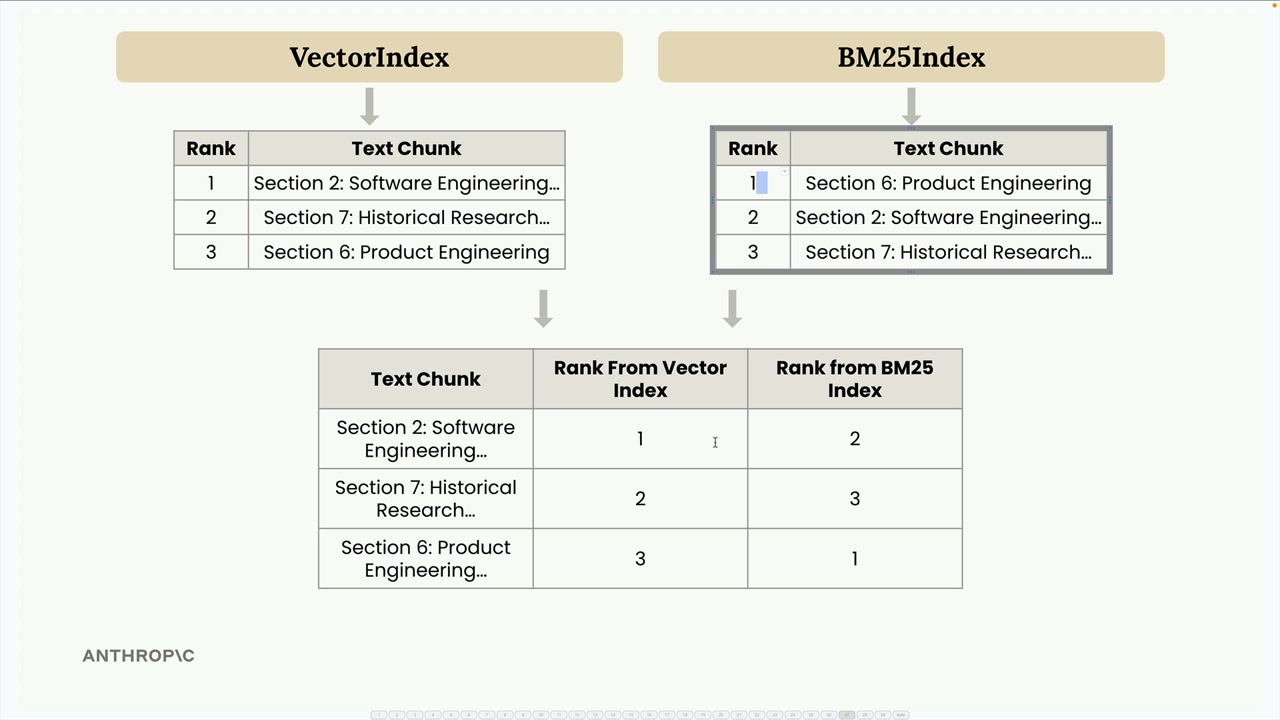
我們將這些結果合併成一個單一表格,顯示每個文字區塊在兩個索引中的排名,然後套用 RRF 公式:
RRF_score(d) = Σ(1 / (k + rank_i(d)))其中 k 是一個常數(通常為 60,但我們將使用 1 以獲得更清楚的結果),而 rank_i(d) 是文件 d 在第 i 個排名中的排名。
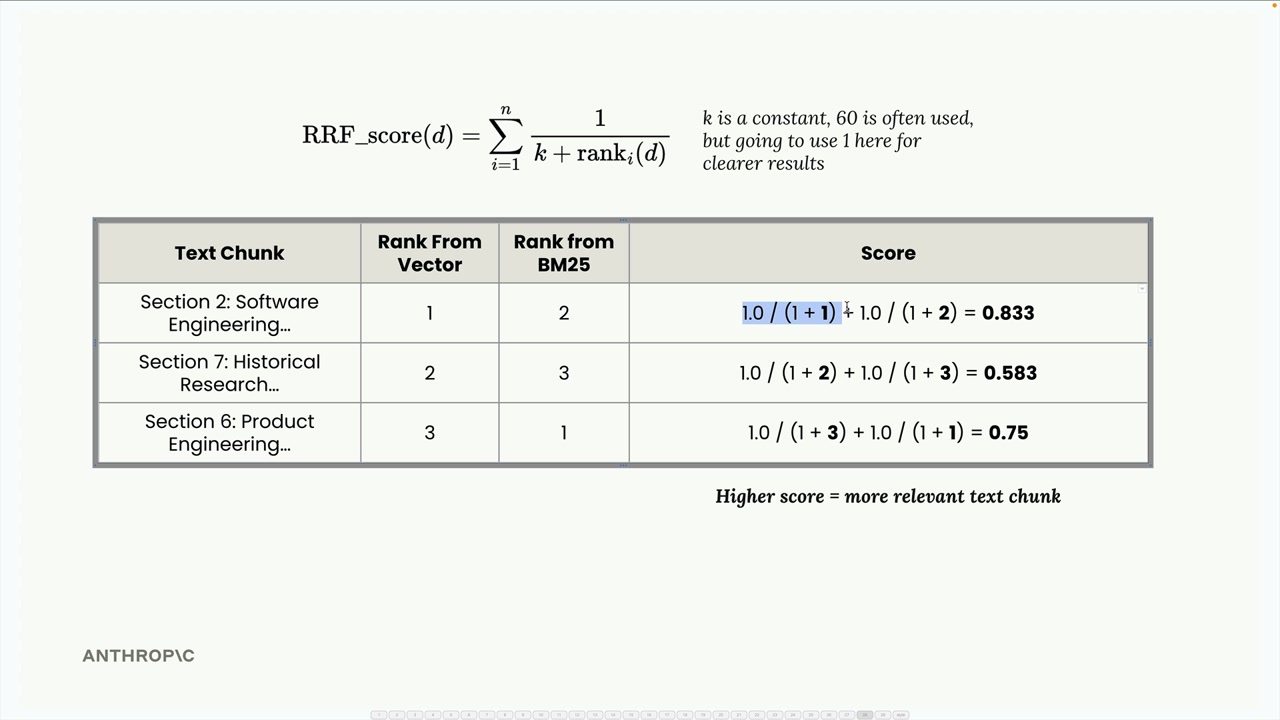
以我們的範例為例:
- 第 2 節:1.0/(1+1) + 1.0/(1+2) = 0.833
- 第 7 節:1.0/(1+2) + 1.0/(1+3) = 0.583
- 第 6 節:1.0/(1+3) + 1.0/(1+1) = 0.75
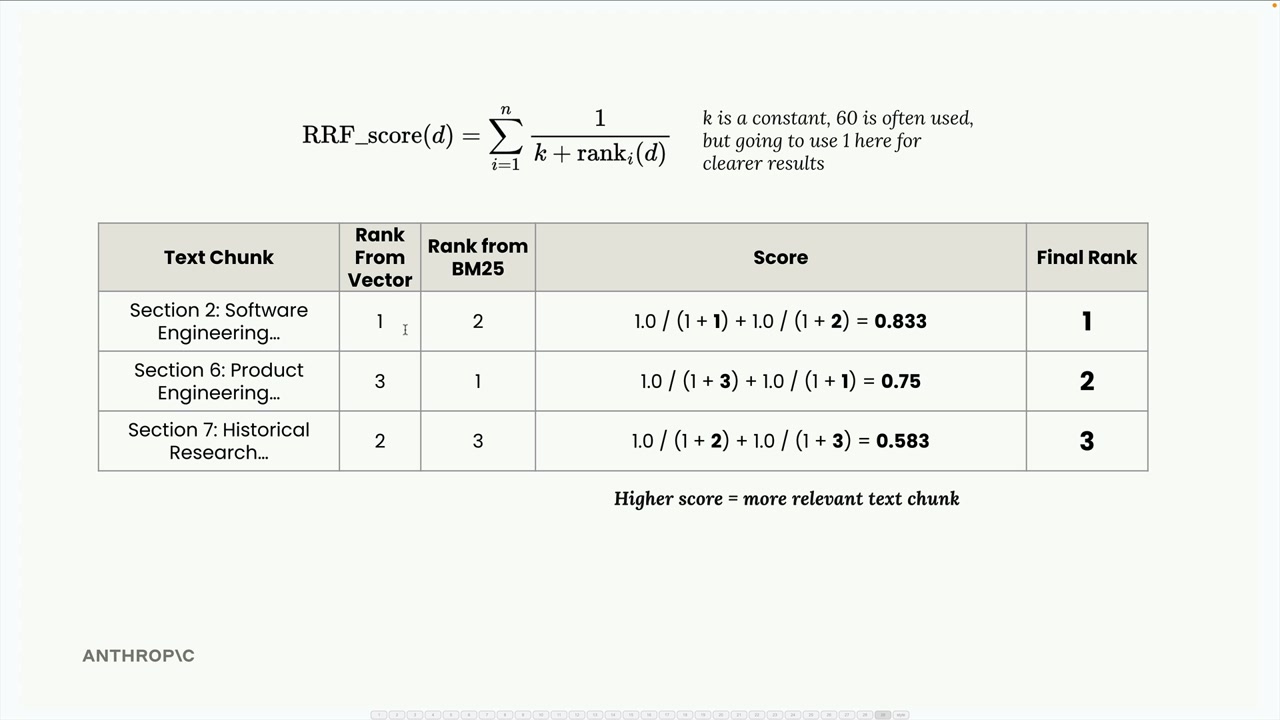
最終排名為:第 2 節(0.833)、第 6 節(0.75)、第 7 節(0.583)。這符合直覺——第 2 節在兩個索引中表現都很好,因此它脫穎而出,排名最高。
實作細節
Retriever 類別包裝了多個搜尋索引,並提供統一的介面:
class Retriever:
    def __init__(self, *indexes: SearchIndex):
        if len(indexes) == 0:
            raise ValueError("At least one index must be provided")
        self._indexes = list(indexes)

    def add_document(self, document: Dict[str, Any]):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text: str, k: int = 1, k_rrf: int = 60):
        # 從所有索引取得結果
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # 追蹤各索引間的文件排名
                # 套用 RRF 評分公式
        # 回傳合併並排序後的結果
關鍵的洞察在於,透過在不同搜尋實作之間維持一致的 API,我們可以輕鬆地將它們結合在一起,而不會產生緊密耦合。
測試混合方法
還記得我們之前的問題嗎?當搜尋「INC-2023-Q4-011 發生了什麼事?」時,僅使用向量方法的結果出乎意料。網路安全事件(第 10 節)排名第一,但財務分析(第 3 節)排名第二,而不是更相關的軟體工程章節。
使用我們的混合檢索器,現在我們得到了更好的結果:
- 第 10 節:網路安全分析——事件回應報告(最相關)
- 第 2 節:軟體工程——鳳凰計畫穩定性增強(第二相關)
- 第 5 節:法律發展(第三)
這展示了結合語義搜尋和詞彙搜尋如何克服單獨使用任一方法時的限制。
可擴展性
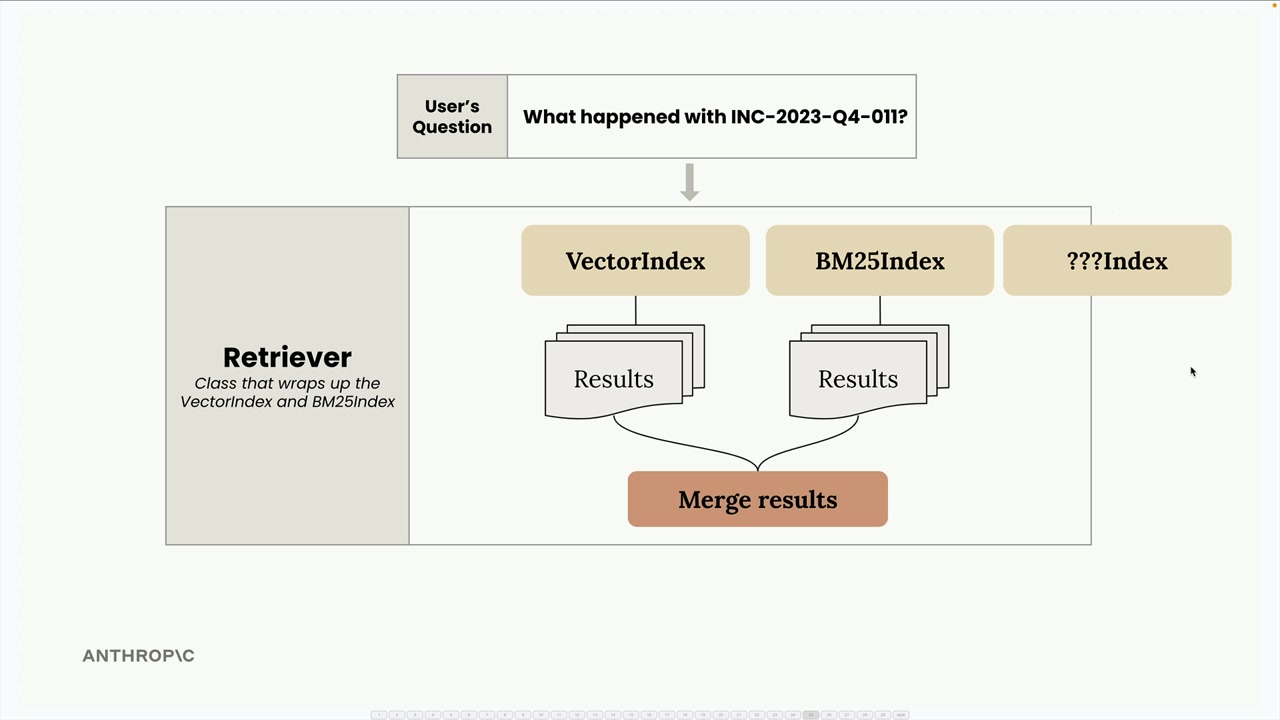
這種架構的美妙之處在於它的可擴展性。由於所有索引都實作了相同的 SearchIndex 協定,並具有 add_document() 和 search() 方法,您可以輕鬆新增新的搜尋方法:
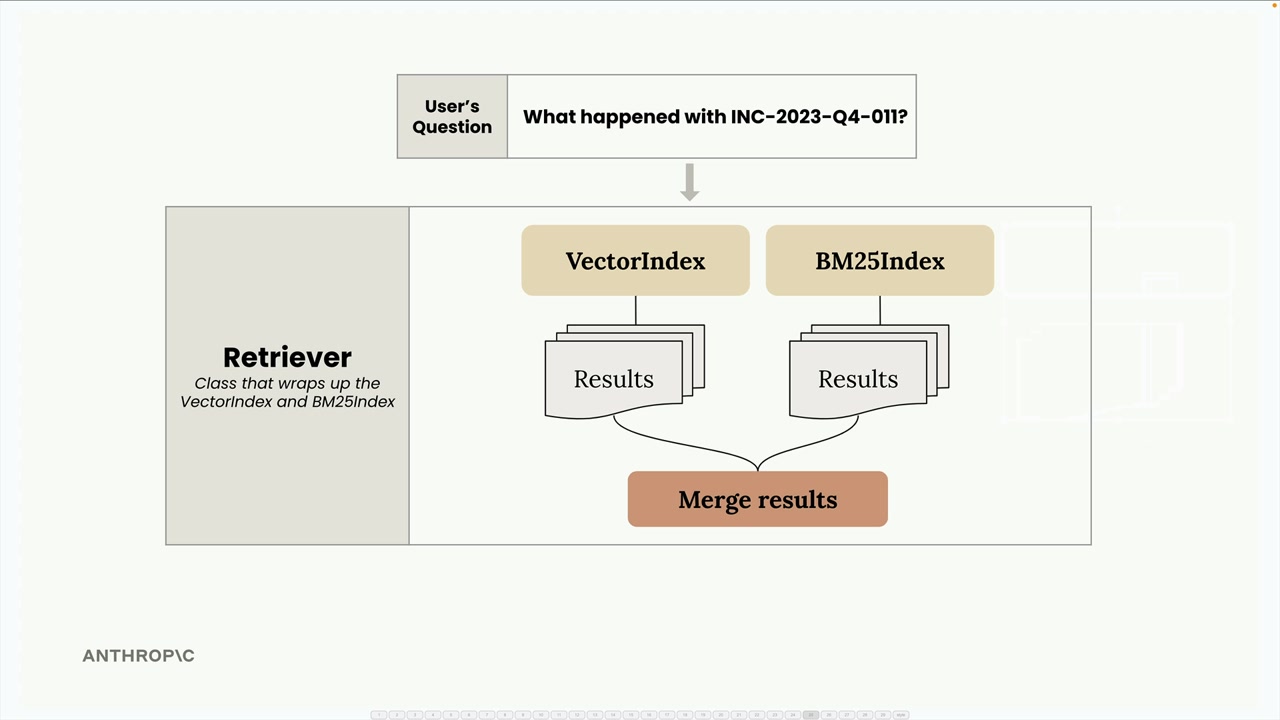
想新增基於關鍵字的索引嗎?基於圖形的搜尋?專門的領域索引?只需實作相同的介面,Retriever 就會自動將其納入融合流程中。
這種模組化方法使每個搜尋實作保持專注且可測試,同時為在最終系統中結合它們的優勢提供了一種乾淨的方式。