載入中
現在我們已經從概念上理解了 RAG 流程,讓我們逐步實作它。我們將透過一個完整的範例,示範如何對文本進行分塊、生成嵌入、將其儲存在向量資料庫中,以及執行相似度搜尋。
五步驟 RAG 實作
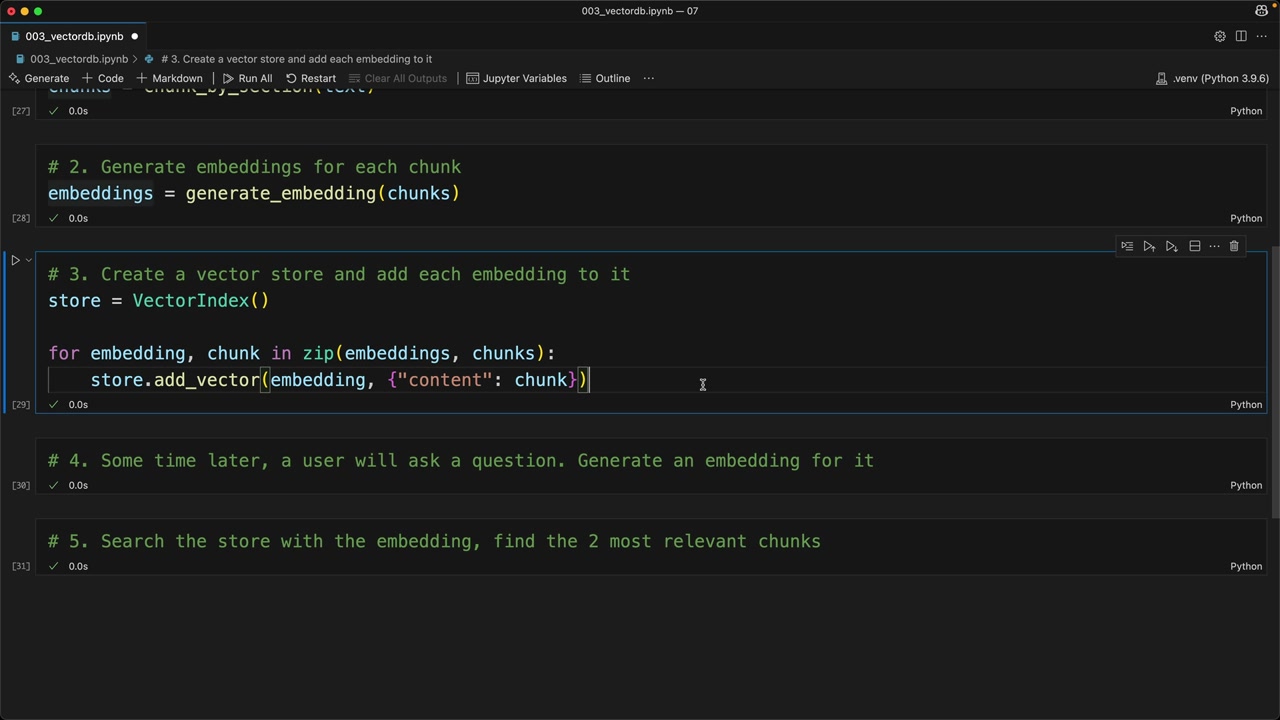
我們的實作遵循先前討論過的相同五個步驟:
- 依章節對文本進行分塊
- 為每個區塊生成嵌入
- 建立一個向量儲存庫,並將每個嵌入加入其中
- 為使用者的問題生成嵌入
- 搜尋儲存庫以找出最相關的區塊
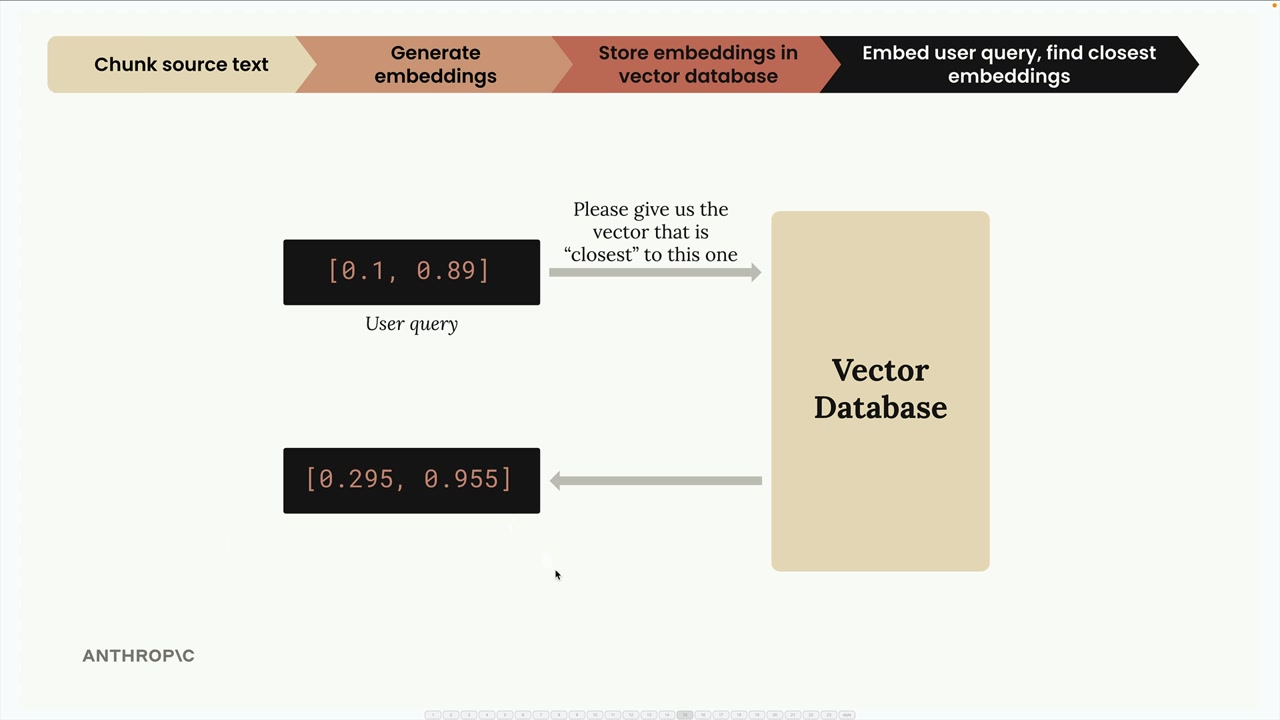
此圖顯示我們如何將使用者查詢轉換為嵌入,並搜尋我們的向量資料庫以找出最相關的內容。
步驟一:對文本進行分塊
首先,我們載入文件並將其分割成易於管理的區段:
python
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
chunks[2]  # Test to see the table of contents
我們使用先前相同的 chunk_by_section 函式,將文件分割成邏輯區段。
步驟二:生成嵌入
接下來,我們一次為所有區塊建立嵌入:
python
embeddings = generate_embedding(chunks)嵌入函式已更新,可同時處理單一字串與字串清單,使其在批次處理時更有效率。
步驟三:儲存至向量資料庫
現在我們建立向量儲存庫,並以嵌入及其相關文本填充它:
python
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
請注意,我們同時儲存了嵌入與原始文本內容。這一點至關重要,因為稍後進行搜尋時,我們需要回傳實際的文本,而不僅僅是數值嵌入值。
為什麼要儲存原始文本?
當我們查詢向量資料庫時,只取回嵌入數字並無用處。我們需要用於生成這些嵌入的實際文本。這就是為什麼我們會在資料庫中,將原始區塊文本(或至少是其參照)與每個嵌入一併儲存的原因。
步驟四:處理使用者查詢
當使用者提出問題時,我們會為其查詢生成嵌入:
python
user_embedding = generate_embedding("What did the software engineering dept do last year?")步驟五:找出相關內容
最後,我們搜尋向量儲存庫,以找出最相似的區塊:
python
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
此次搜尋會回傳兩個最相關的區塊,以及它們的相似度分數(餘弦距離)。
搜尋結果向我們顯示文件中哪些區段與使用者問題最為相關,並附上相似度分數。
理解結果
當我們執行有關軟體工程部門的範例查詢時,得到的結果如下:
- 第 2 節:軟體工程,距離為 0.71(最接近的匹配)
- 方法論章節,距離為 0.72(第二接近)
距離值越低表示相似度越高,因此第 2 節與我們的查詢最為相關。
接下來呢?
此實作方式對基本情境運作良好,但在某些情況下其表現未如預期。在接下來的章節中,我們將探討如何改進,使我們的 RAG 系統更加穩健且準確。
關鍵要點是:RAG 的本質在於將文本轉換為數字(嵌入)、有效率地儲存這些數字,然後在使用者提問時,運用數學上的相似度來找出相關內容。