MCP 中的資源讓您的伺服器能夠公開資料,這些資料可以直接包含在提示中,而不需要透過工具呼叫來存取資訊。這創造了一種更有效率的方式,為像 Claude 這樣的 AI 模型提供上下文。
理解資源請求
當您在 MCP 伺服器上定義了資源後,您的客戶端需要一種方式來請求和使用這些資源。客戶端充當您的應用程式與 MCP 伺服器之間的橋樑,自動處理通訊與資料解析。
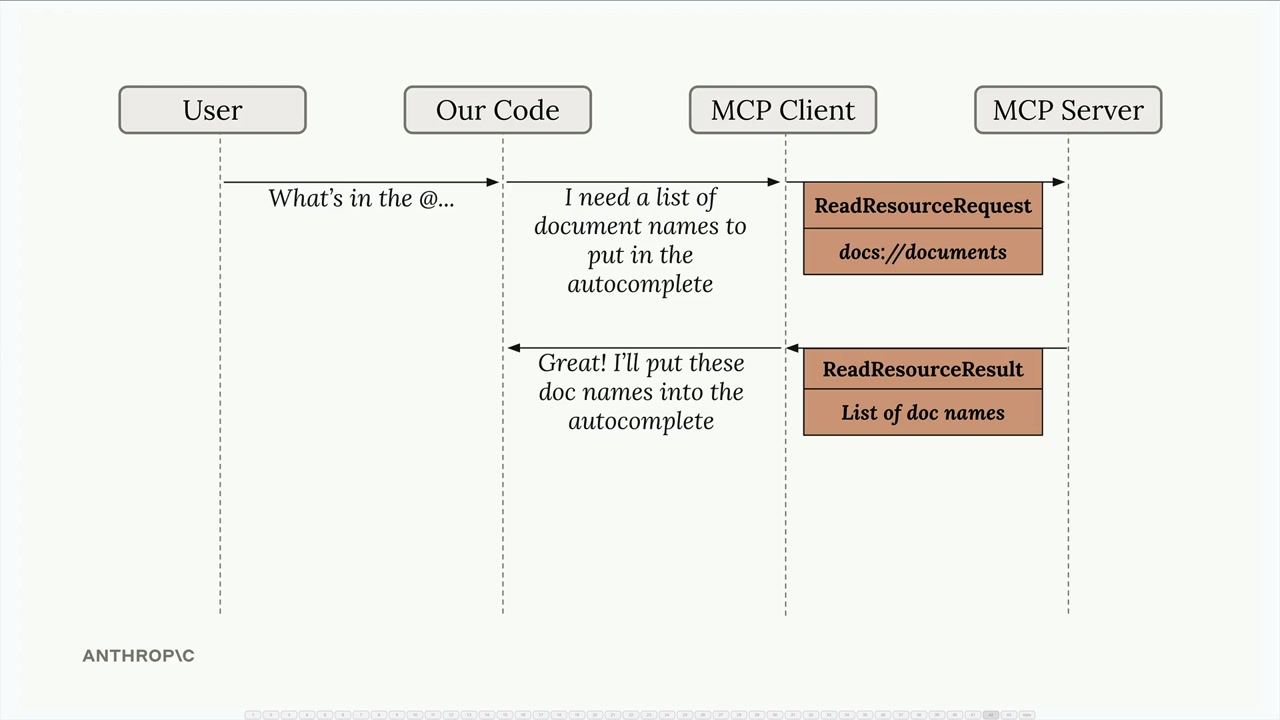
這個流程很直接:當使用者想要參考某份文件時(例如輸入「@report.pdf」),您的應用程式會使用 MCP 客戶端從伺服器取得該資源,並將其內容直接包含在傳送給 Claude 的提示中。
實作資源讀取
核心功能需要在您的 MCP 客戶端中有一個 read_resource 函式。這個函式接受一個用來識別要擷取哪個資源的 URI 參數:
async def read_resource(self, uri: str) -> Any:
    result = await self.session().read_resource(AnyUrl(uri))
    resource = result.contents[0]
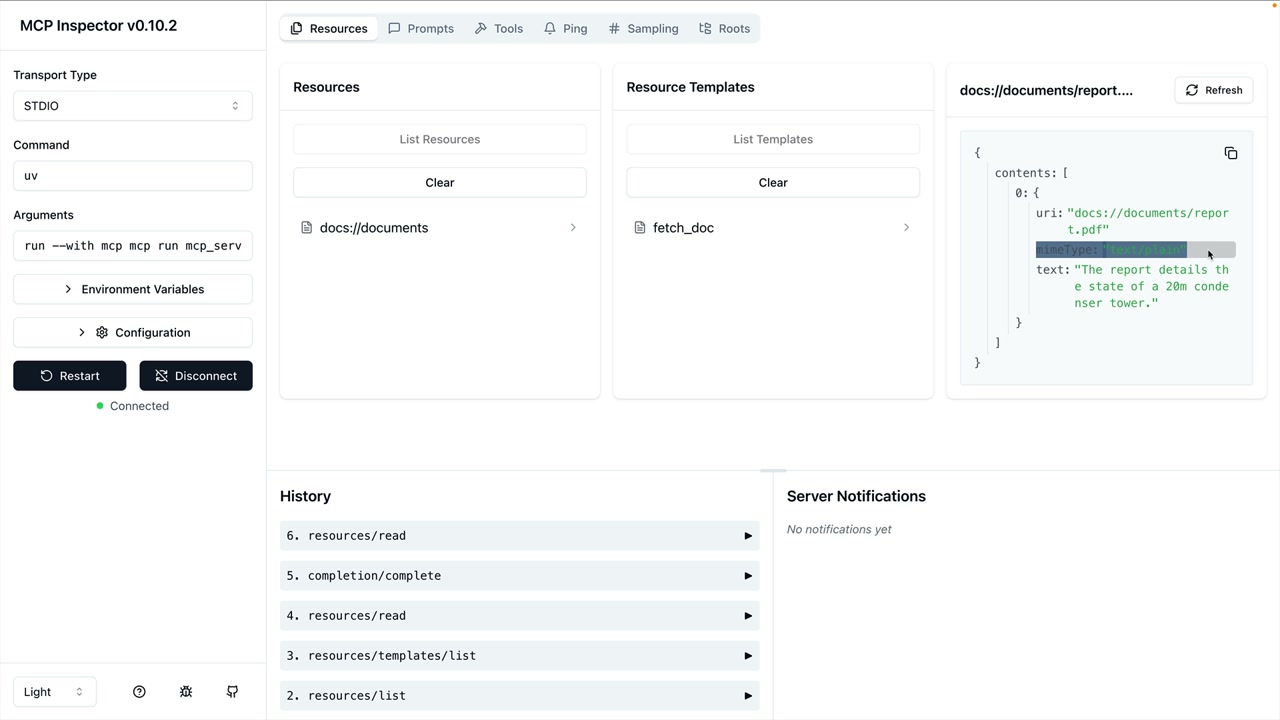
從 MCP 伺服器傳回的回應包含一個 contents 清單。您通常只需要第一個元素,其中包含實際的資源資料以及像 MIME 類型這樣的中繼資料。
處理不同的內容類型
資源可以回傳不同類型的內容,因此您的客戶端需要適當地解析它們。MIME 類型會告訴您該如何處理資料:
if isinstance(resource, types.TextResourceContents):
    if resource.mimeType == "application/json":
        return json.loads(resource.text)

    return resource.text
這種做法可確保 JSON 資源被正確解析為 Python 物件,而純文字資源則以字串形式回傳。MIME 類型可作為您判斷正確解析策略的提示。
必要的匯入項目
為了讓這一切正常運作,您需要在 MCP 客戶端中匯入以下項目:
import json
from pydantic import AnyUrl
json 模組負責解析 JSON 回應,而 AnyUrl 則確保 URI 參數有正確的型別處理。
測試資源存取
實作完成後,您可以透過您的 CLI 應用程式來測試此功能。當您輸入類似「@report.pdf 文件裡有什麼?」這樣的內容時,系統應該會:
- 在自動完成清單中顯示可用的資源
- 讓您選擇一個資源
- 自動擷取資源內容
- 將該內容包含在傳送給 Claude 的提示中
關鍵優勢在於 Claude 可以直接在提示中收到文件內容,無需透過工具呼叫來存取資訊。這讓互動變得更快速、更有效率。
與您的應用程式整合
請記得,您撰寫的 MCP 客戶端程式碼會被應用程式的其他部分所使用。read_resource 函式會成為一個建構區塊,供其他元件呼叫以擷取文件內容、列出可用資源,或將資源資料整合到提示中。
這種關注點分離讓您的程式碼保持整潔:MCP 客戶端負責處理與伺服器的通訊,而您的應用程式邏輯則專注於如何有效地運用這些資料。