文本分塊是建構 RAG(檢索增強生成)管線中最關鍵的步驟之一。您如何拆分文件會直接影響整個系統的品質。不佳的分塊策略可能導致不相關的上下文被插入到您的提示中,進而使您的 AI 給出完全錯誤的答案。
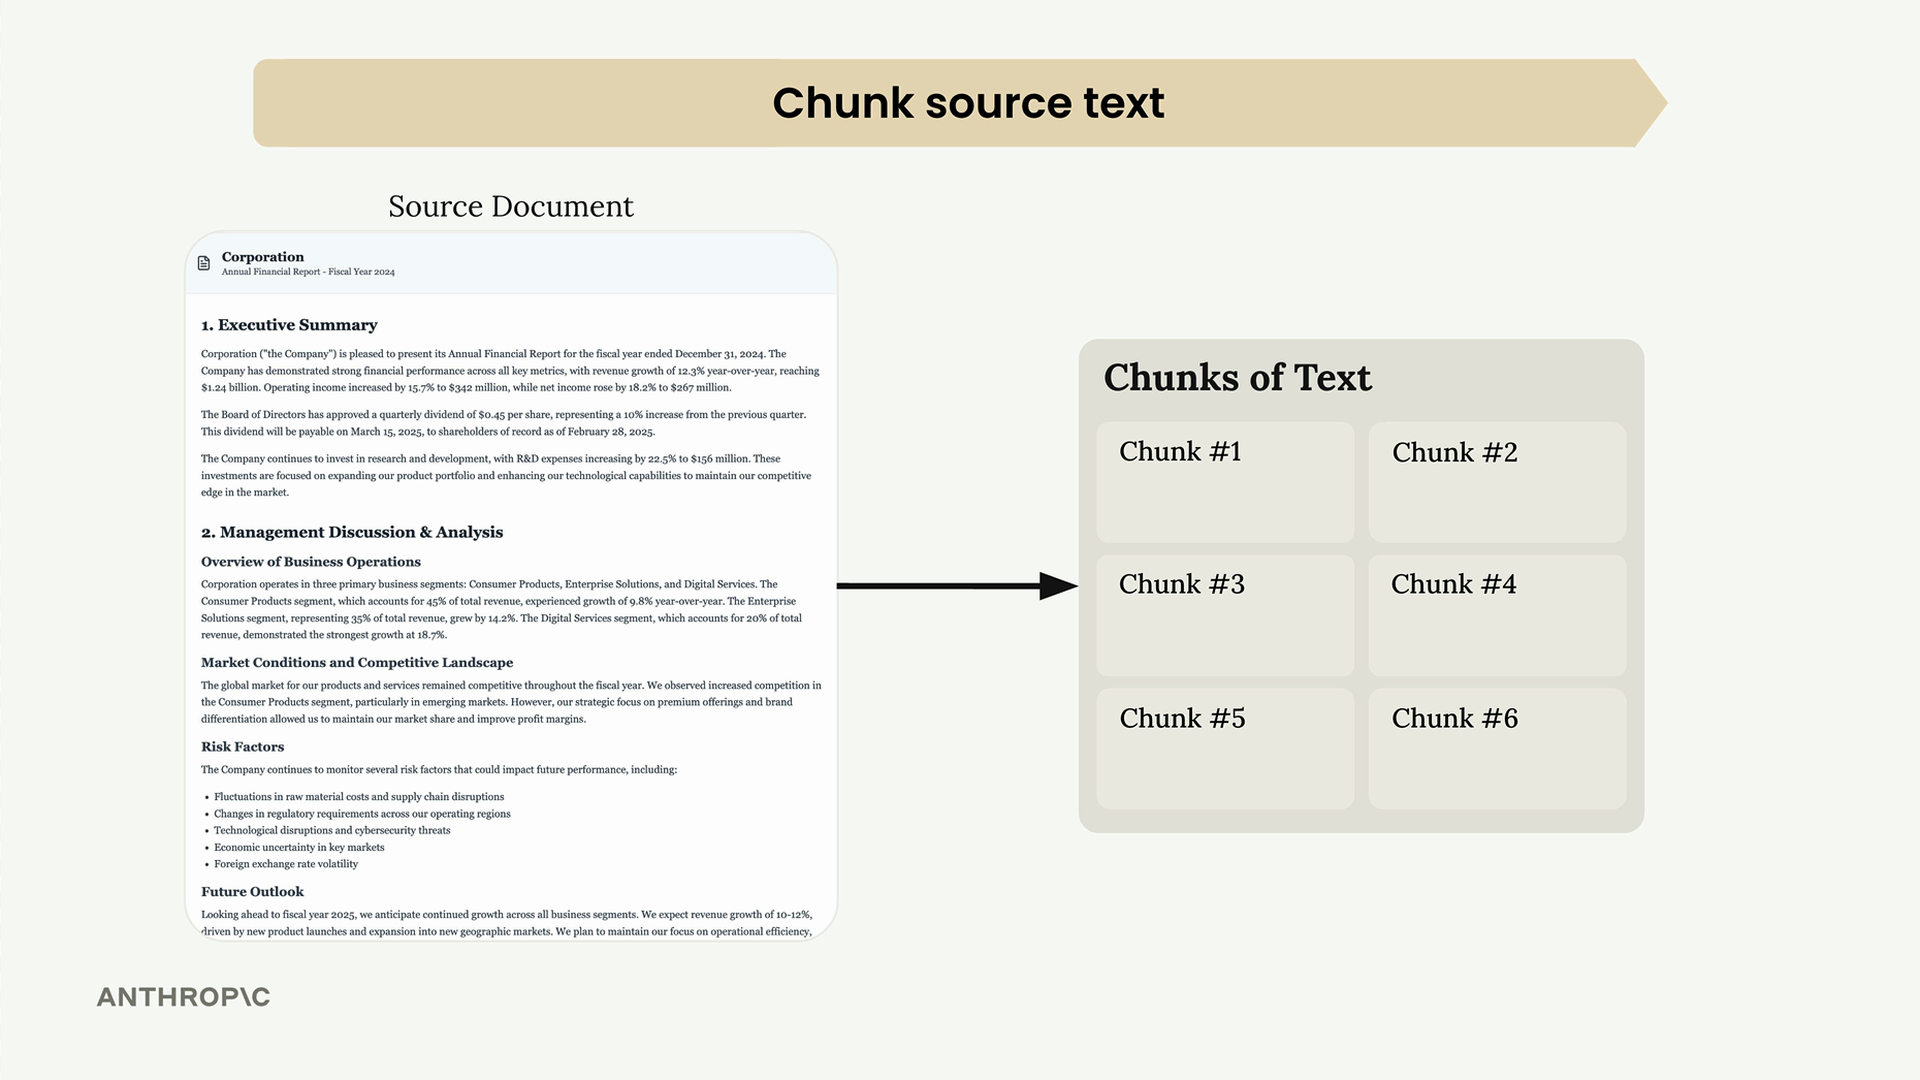
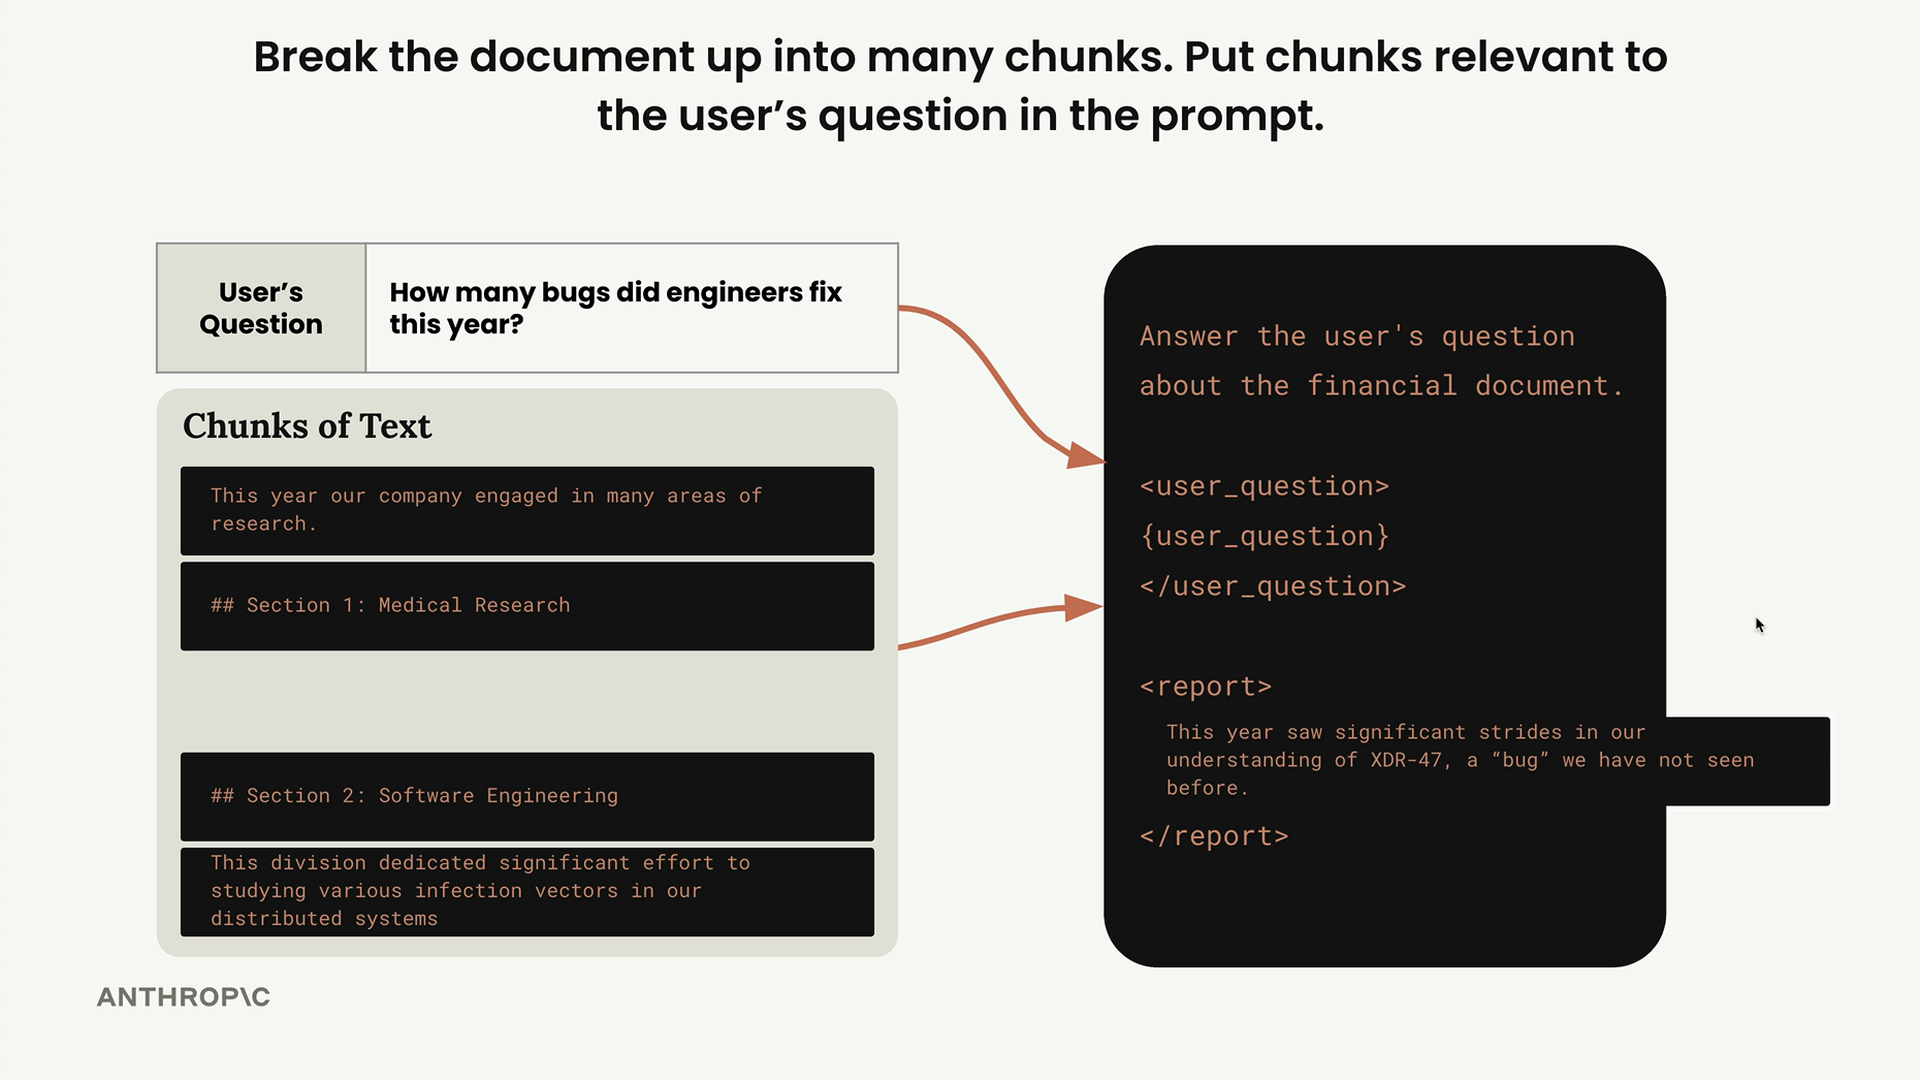
考慮這個例子:您有一份文件,其中包含關於醫學研究和軟體工程的章節。如果分塊不佳,當使用者詢問「今年工程師修復了多少個錯誤?」時,可能會得到關於醫學研究的資訊,而不是軟體工程的資訊,僅僅因為醫學部分恰好在不同語境下包含了「bug」這個詞。
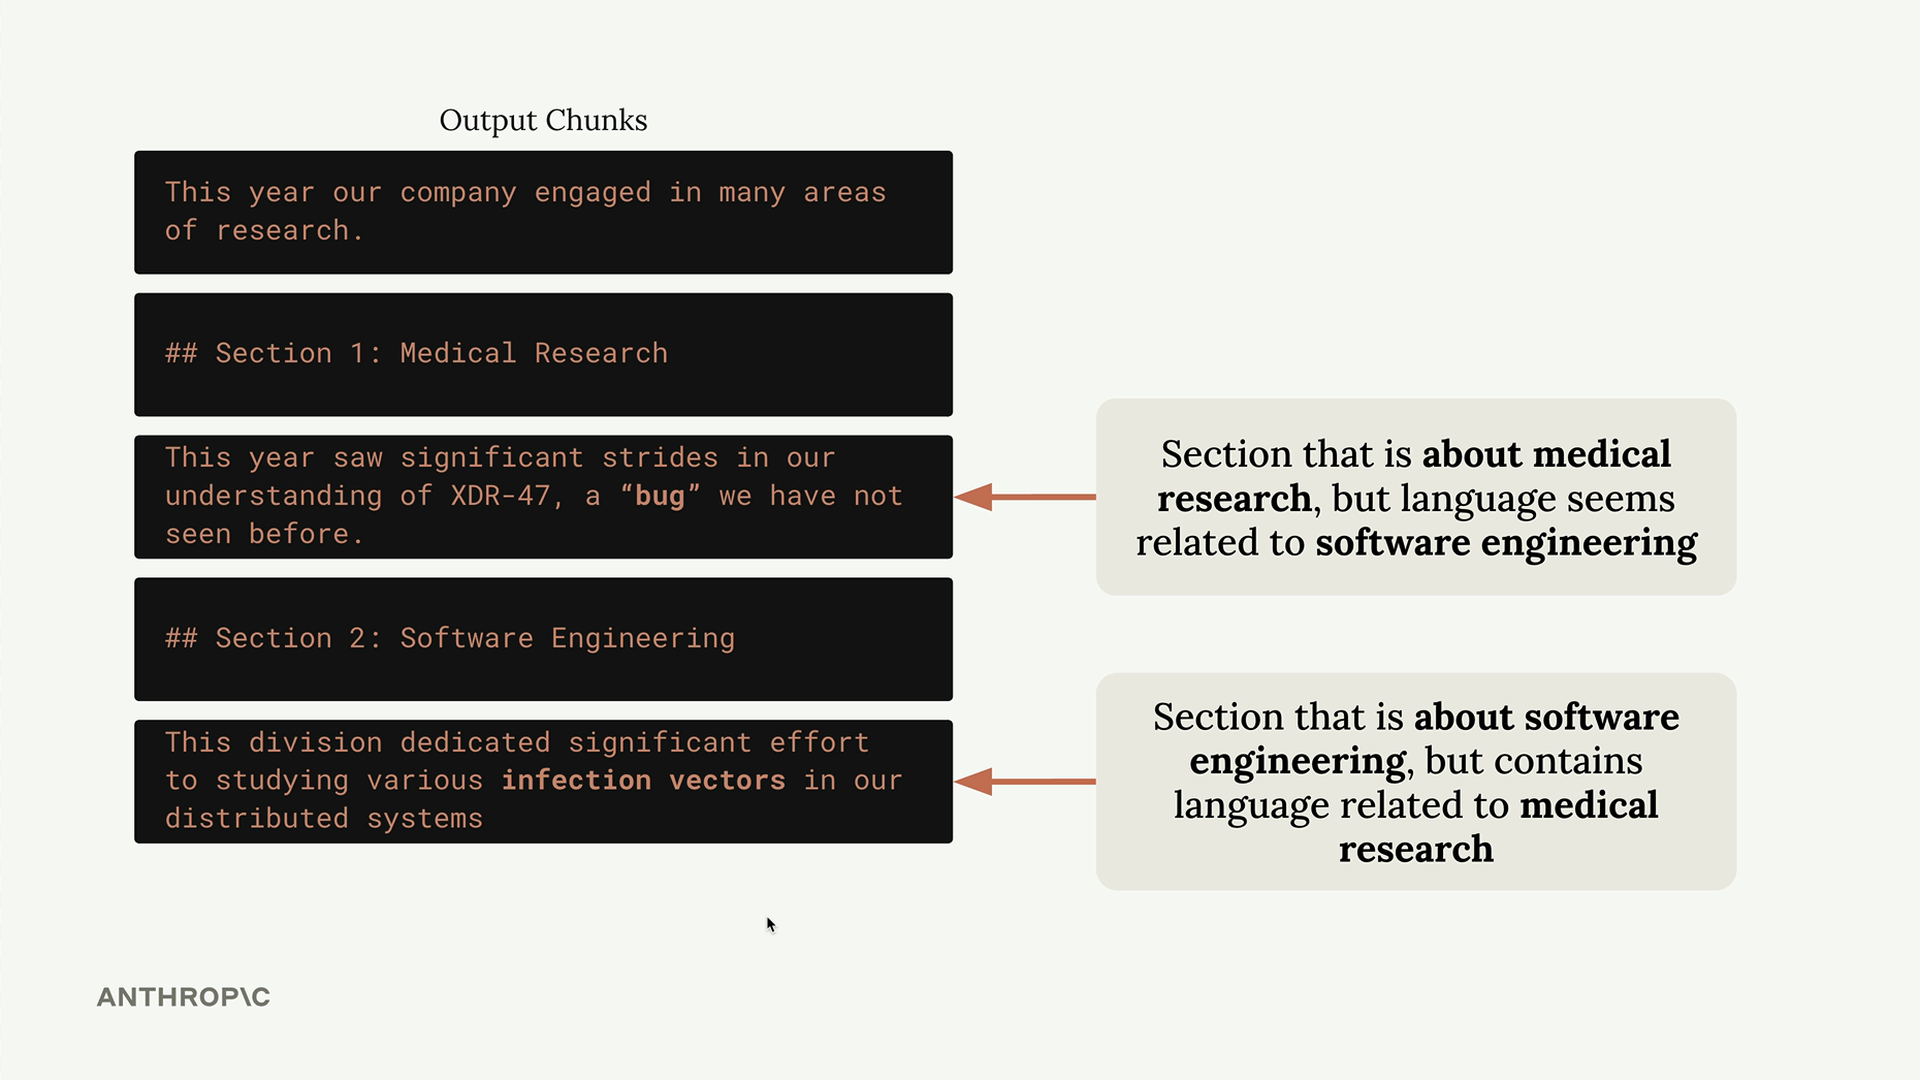
這說明了分塊策略為何如此重要。目標是建立能維持語義連貫性、並在檢索時提供有意義上下文的區塊。
三種主要分塊策略
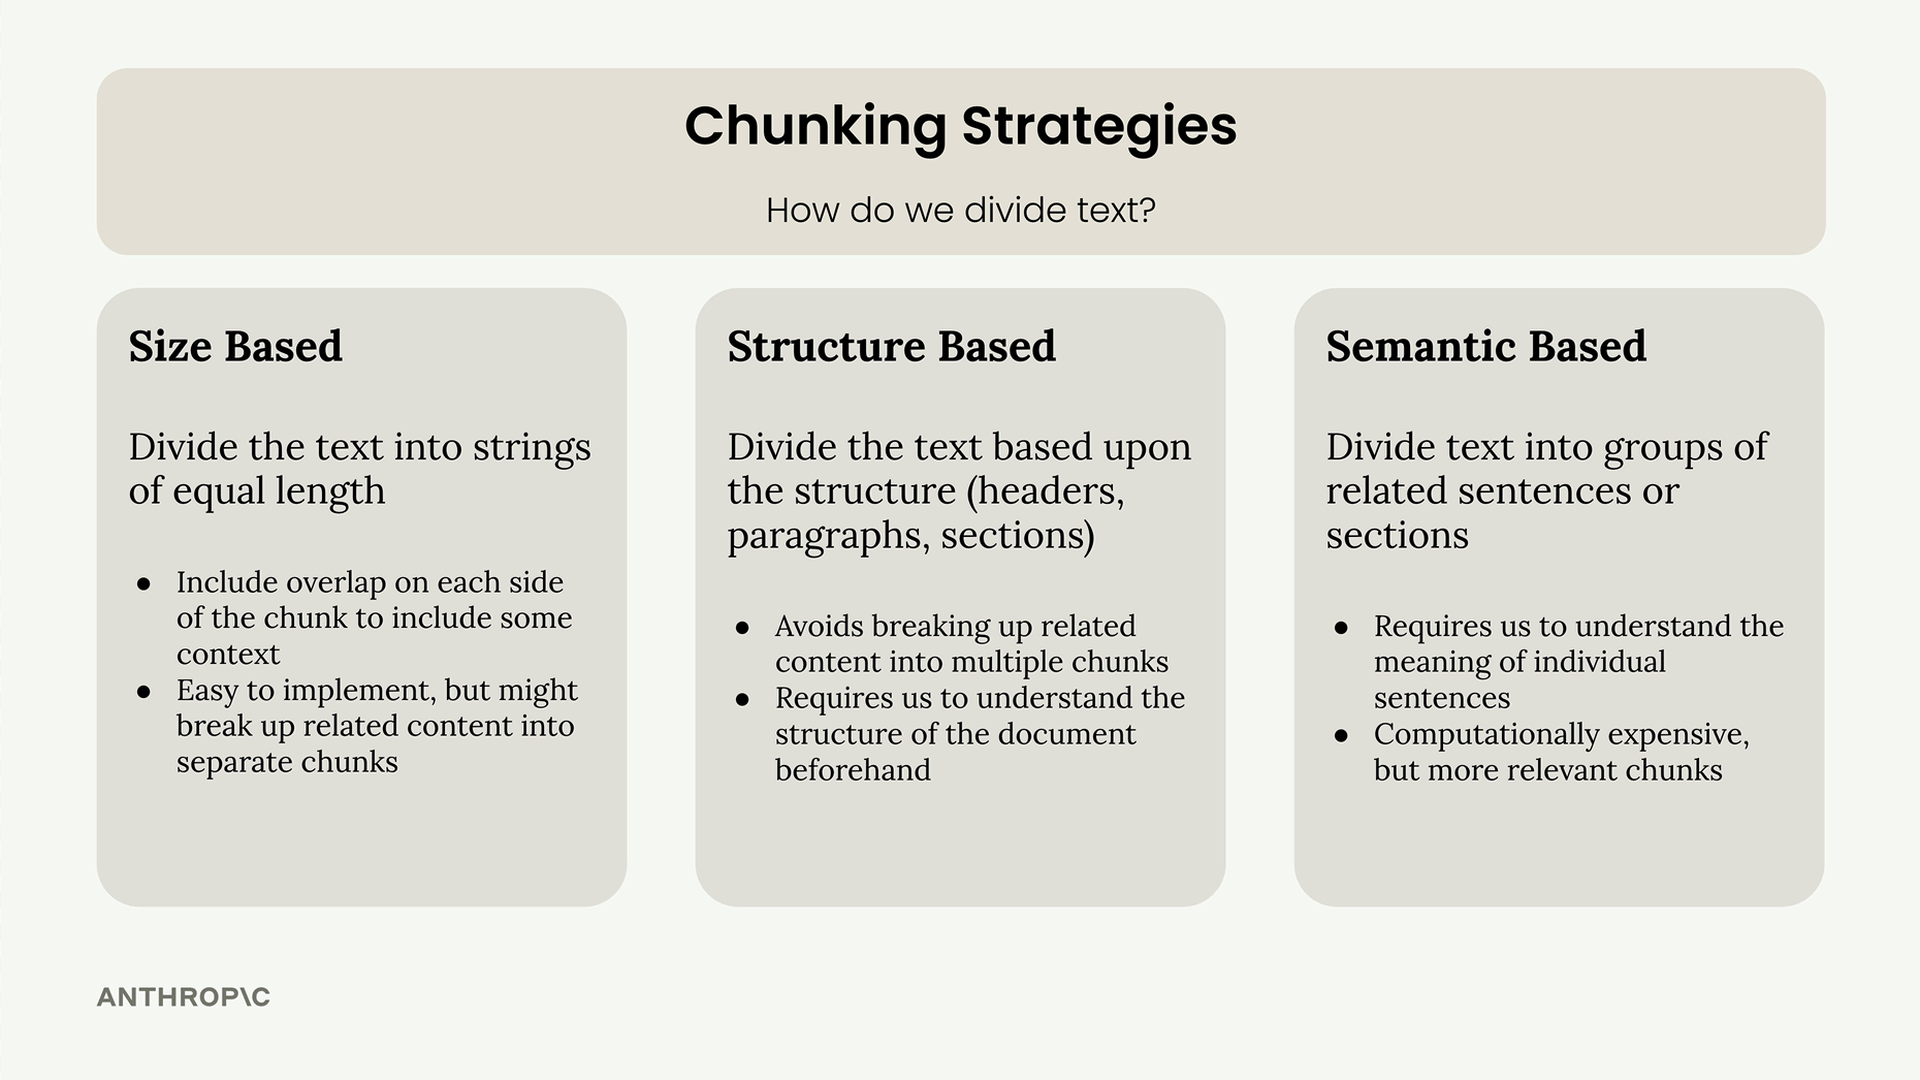
文本分塊有三種主要方法,每種都有不同的優缺點:
- 基於大小: 將文本分割成長度相等的字串
- 基於結構: 根據文件結構(標題、段落、章節)進行分割
- 基於語義: 使用 NLP 技術將相關句子或段落分組
基於大小的分塊
基於大小的分塊是最簡單直接的方法。您只需將文件分割成字元數或字數大致相等的區塊。這種方法易於實作,且在不同文件類型中都能可靠運作。
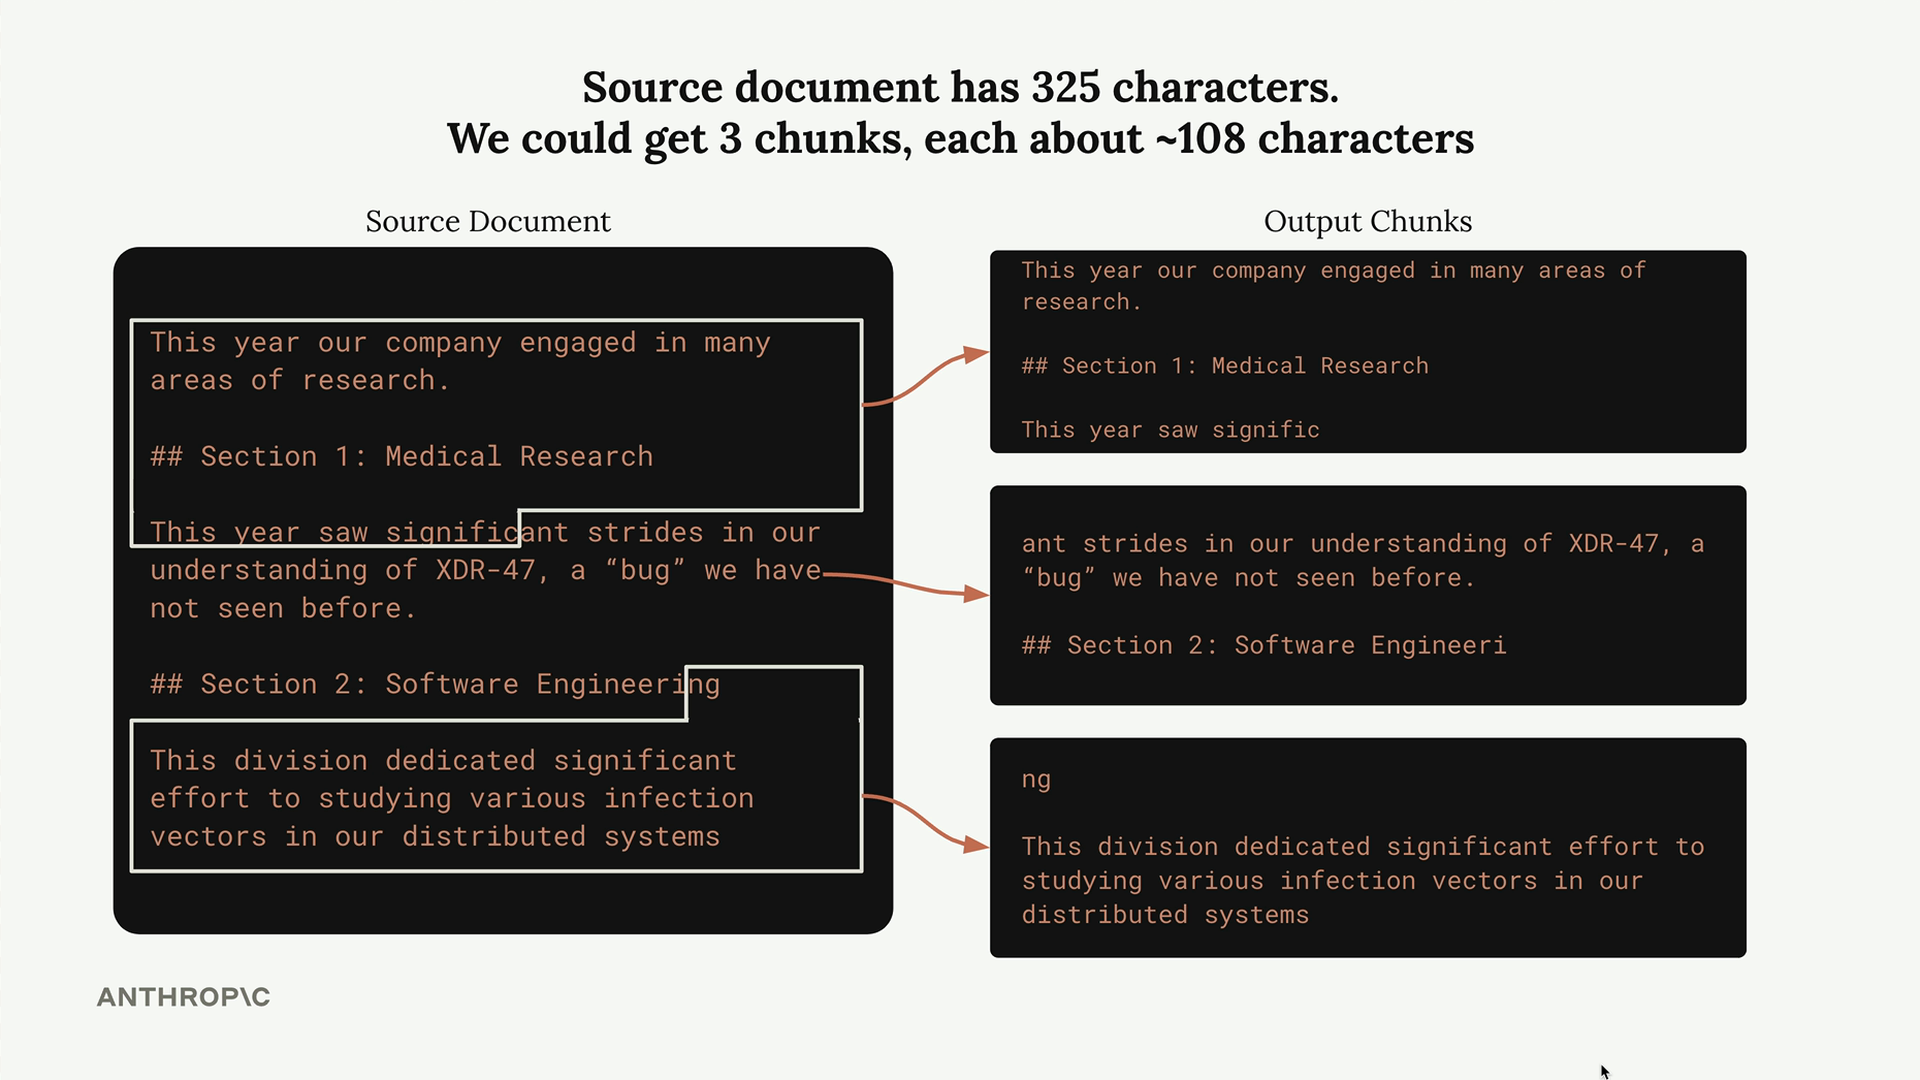
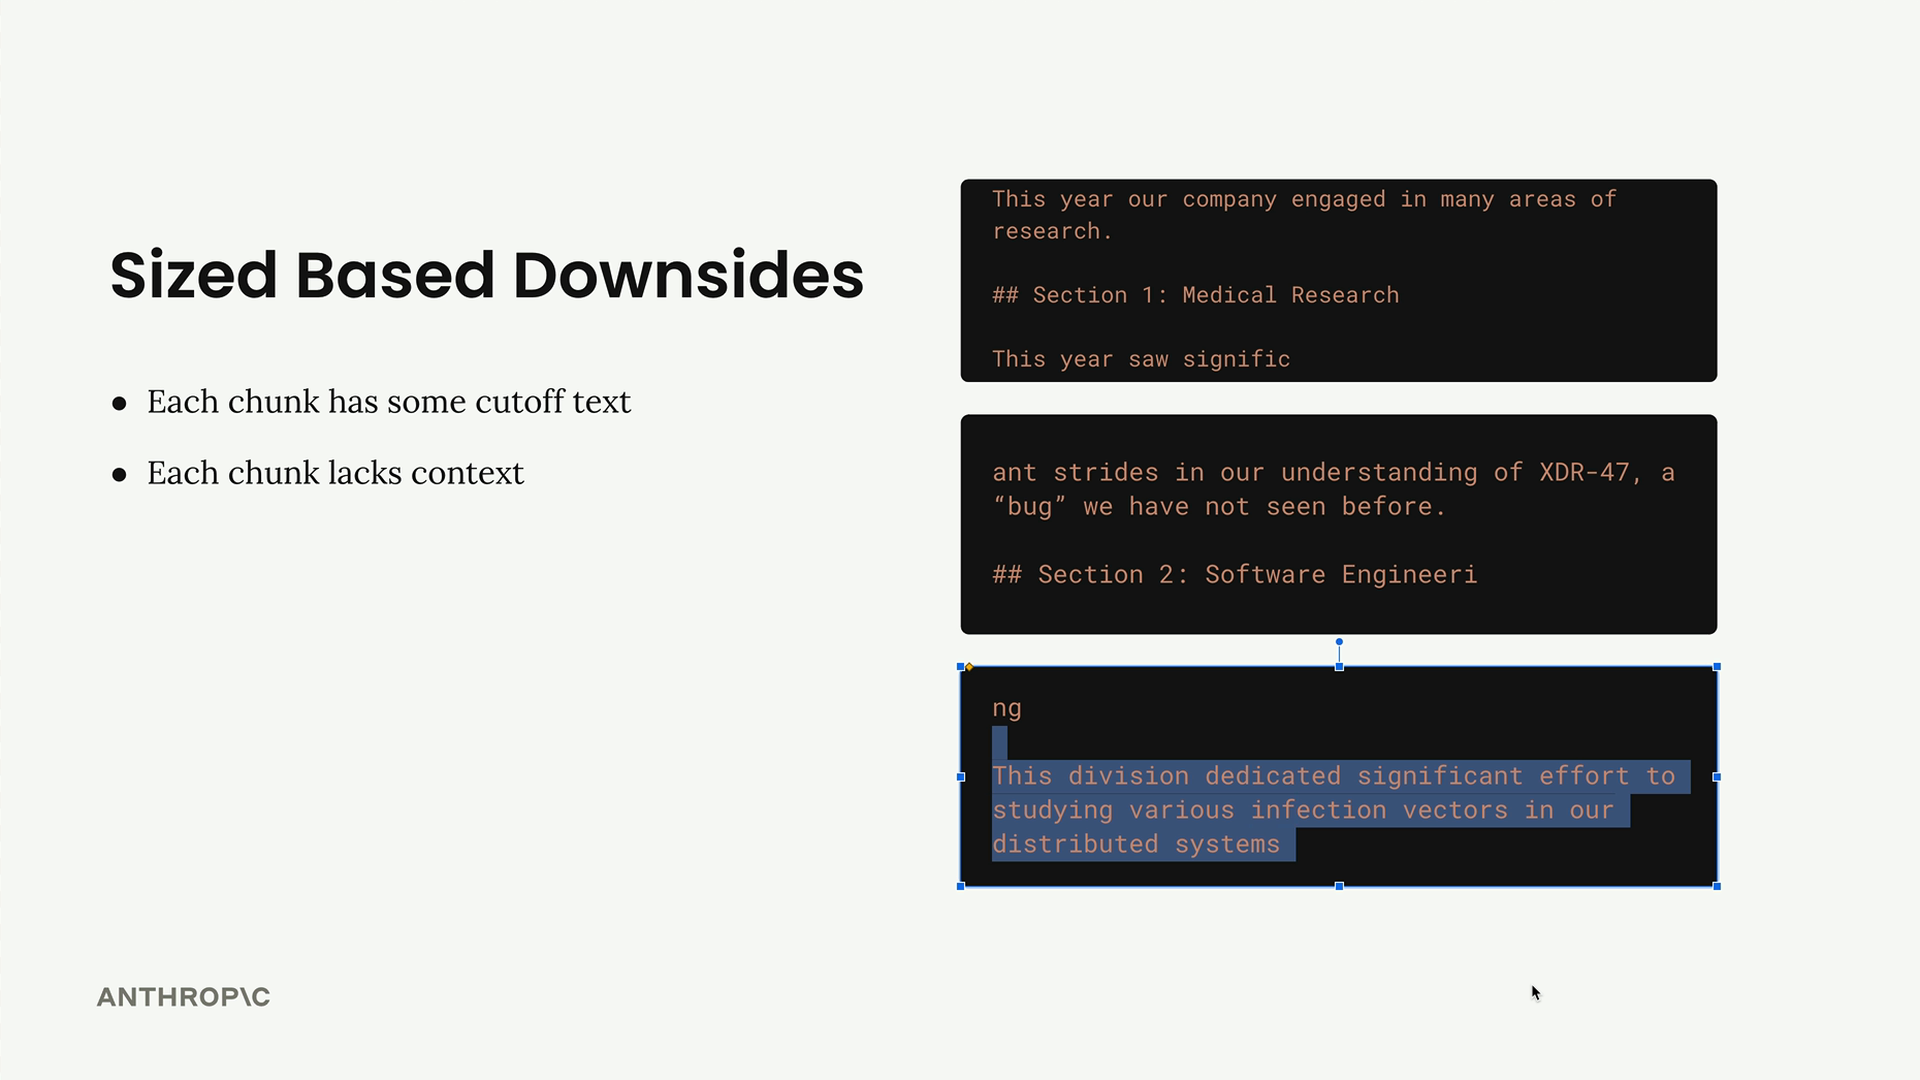
然而,這種方法有明顯的缺點。單字會在句子中間被截斷,區塊也會失去重要的上下文。舉例來說,一個區塊可能不會包含能解釋其內容實際主題的章節標題。
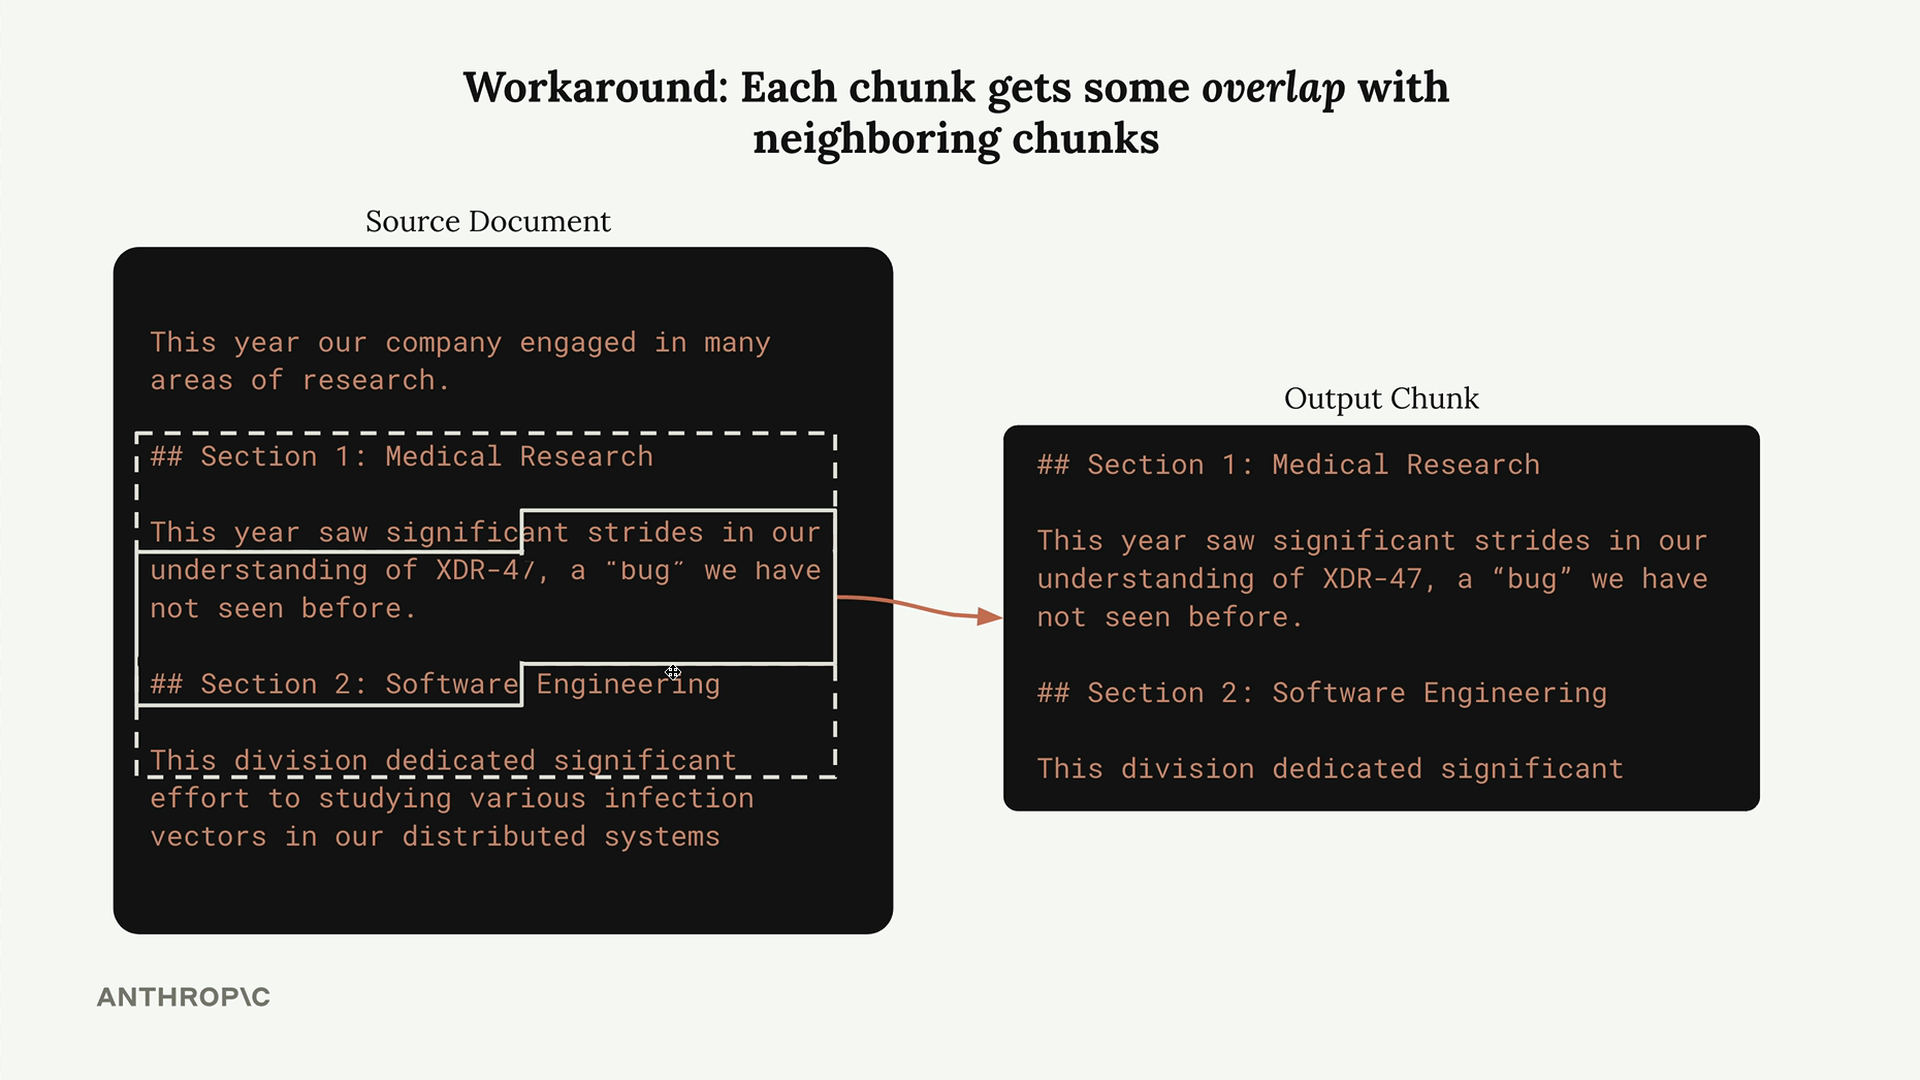
解決方法是在區塊之間加入重疊。每個區塊都包含來自相鄰區塊的一些字元,以確保更好地保留上下文並避免突兀的截斷。
以下是帶有重疊的基於字元分塊的基本實作:
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
基於結構的分塊
基於結構的分塊利用了文件的自然組織方式。如果您處理的是 markdown 檔案,可以依標題進行分割。對於其他格式,您可能會依段落或其他結構元素進行分割。
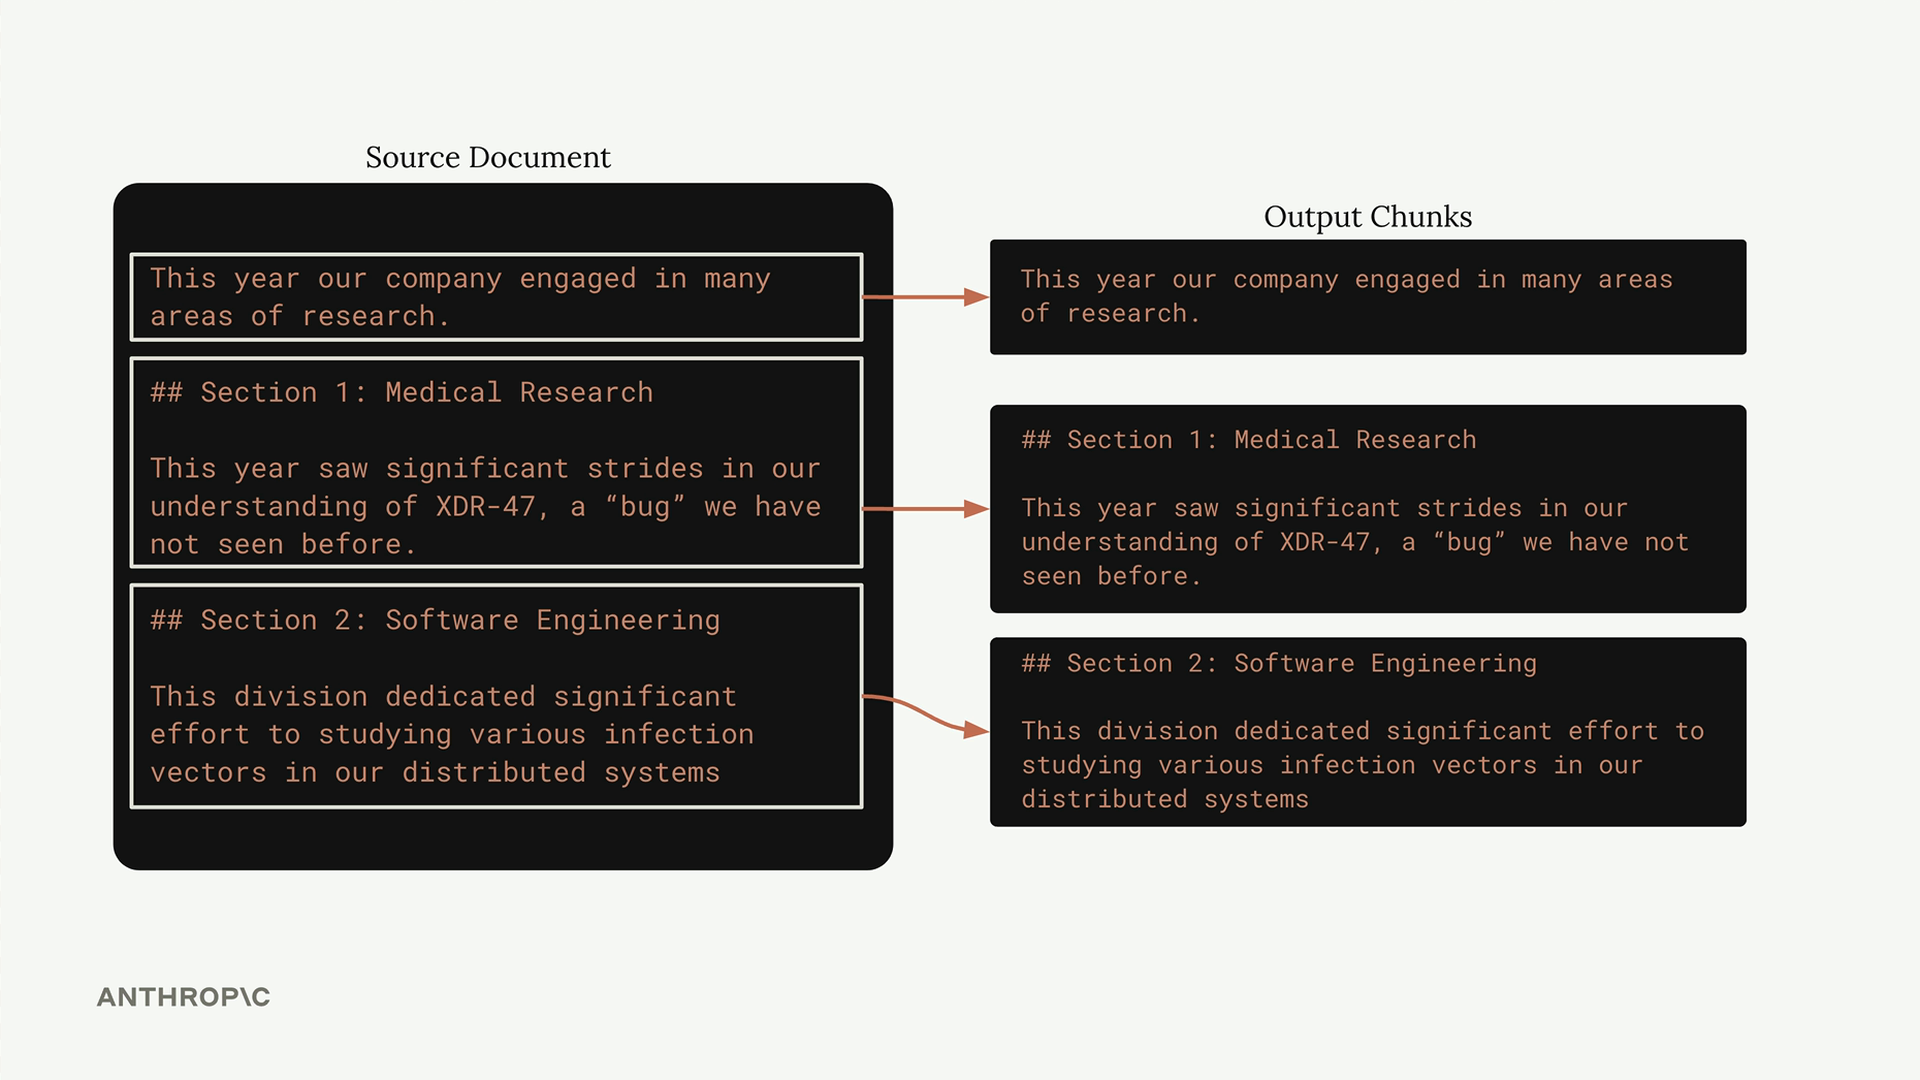
當您能確保文件結構一致時,這種方法效果絕佳。對於 markdown 文件,您可以依章節標題進行分割:
import re

def chunk_by_section(document_text):
    pattern = r'\n## '
    return re.split(pattern, document_text)
主要的限制在於許多文件沒有一致的結構。純文字檔案、PDF 或使用者上傳的文件可能沒有明確的結構標記可供分割。
基於語義的分塊
基於語義的分塊是最精密複雜的方法。它會分析句子之間的意義與關係,將相關內容分組在一起。這通常涉及:
- 將文本拆分成句子
- 使用 NLP 技術衡量語義相似度
- 將相關句子分組成連貫的區塊
雖然這種方法能產生品質最高的區塊,但計算成本高,實作上也更複雜。對於大多數應用而言,較簡單的方法已經足夠好用。
實務實作
以下是一個以句子為基礎的分塊函式,提供了不錯的折衷方案:
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r'(?<=[.!?])\s+', text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(' '.join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
選擇合適的策略
您選擇哪種分塊策略,完全取決於您的特定使用情境:
- 一致的文件結構: 使用基於結構的分塊,可獲得最乾淨的結果
- 混合文件類型: 基於句子的分塊通常效果不錯
- 程式碼或技術內容: 基於字元的分塊最為可靠
- 未知的文件格式: 基於字元的分塊是您最安全的選擇
請記住,分塊通常是一個反覆迭代的過程。從簡單的方法開始,以您特定的文件和使用情境進行測試,然後根據結果進行調整。所謂「最佳」的分塊策略,就是能可靠地適用於您特定資料和需求的那個策略。