在使用 Claude 建置應用程式時,了解完整的請求生命週期有助於您架構更好的系統,並更有效地除錯問題。讓我們逐步說明當使用者向您的 AI 驅動聊天應用程式傳送訊息時會發生什麼事。
完整的請求流程
從使用者輸入到 AI 回應的旅程涉及五個不同的步驟:請求傳送到伺服器、請求傳送到 Vertex、模型處理、回應傳送到伺服器,以及回應傳送到用戶端。每個步驟在提供使用者期待的那個「神奇」回應方面都扮演著關鍵角色。
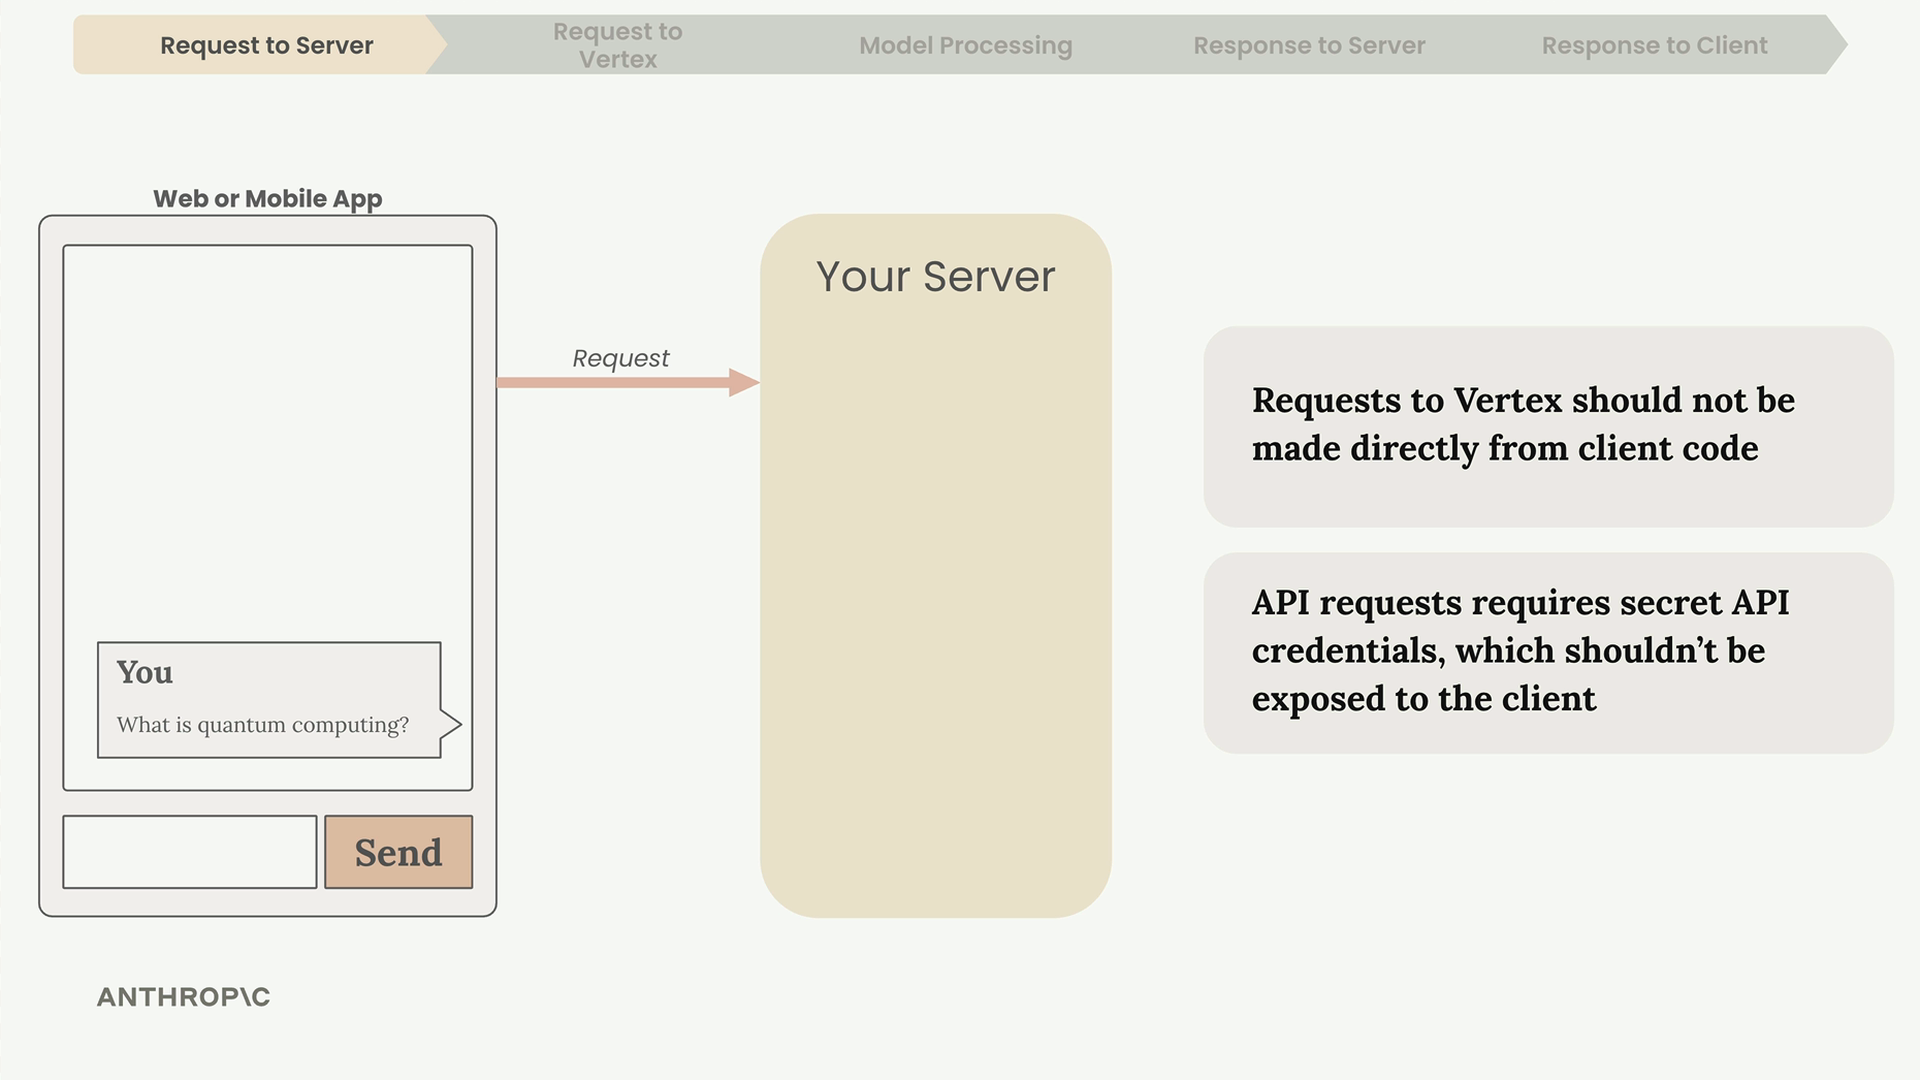
為什麼您需要伺服器
切勿直接從用戶端程式碼發出 API 請求。原因如下:
- API 請求需要保持安全的秘密憑證
- 在用戶端程式碼中暴露憑證會使任何人都能看到它們
- 您的伺服器扮演著您的應用程式與 Vertex 之間的安全中介角色
請務必將請求透過您自己控制和保護的伺服器進行路由。
發出 API 請求
您的伺服器使用 Anthropic 的 SDK 或 Google 的官方 Vertex SDK 與 Vertex 通訊。Anthropic 為 Python、TypeScript、Go 和 Ruby 提供官方 SDK。
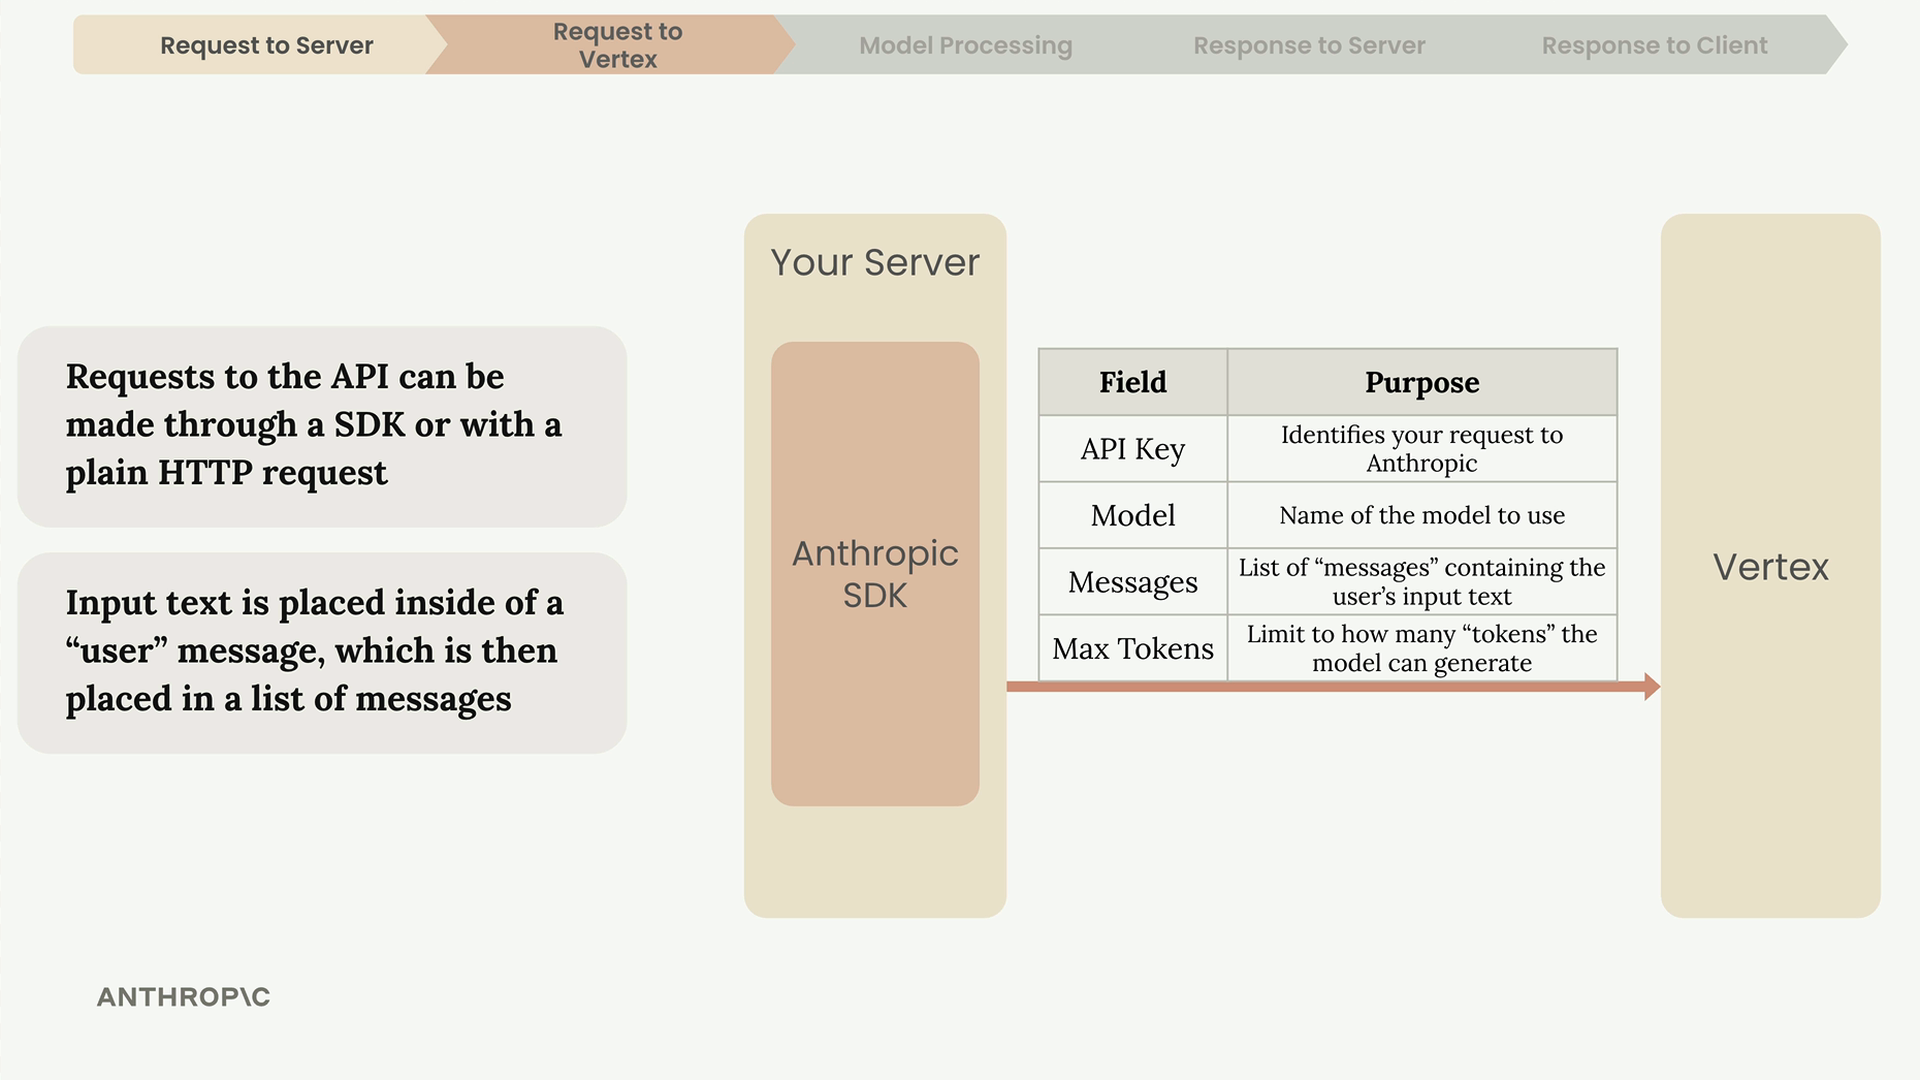
每個請求都必須包含以下關鍵欄位:
- Google Cloud 憑證 - 為您的請求在 Google Cloud 上進行授權
- 模型(Model) - 要使用的特定模型名稱
- 訊息(Messages) - 包含使用者輸入文字的清單
- 最大權杖數(Max Tokens) - 限制模型可以生成的權杖數量
使用者的輸入會被放入一則「user」訊息中,然後進入傳送給 API 的訊息清單。
深入 Claude:文字生成流程
一旦 Vertex 收到您的請求,Claude 會透過四個階段來處理它:權杖化(Tokenization)、嵌入(Embedding)、上下文化(Contextualization)和生成(Generation)。
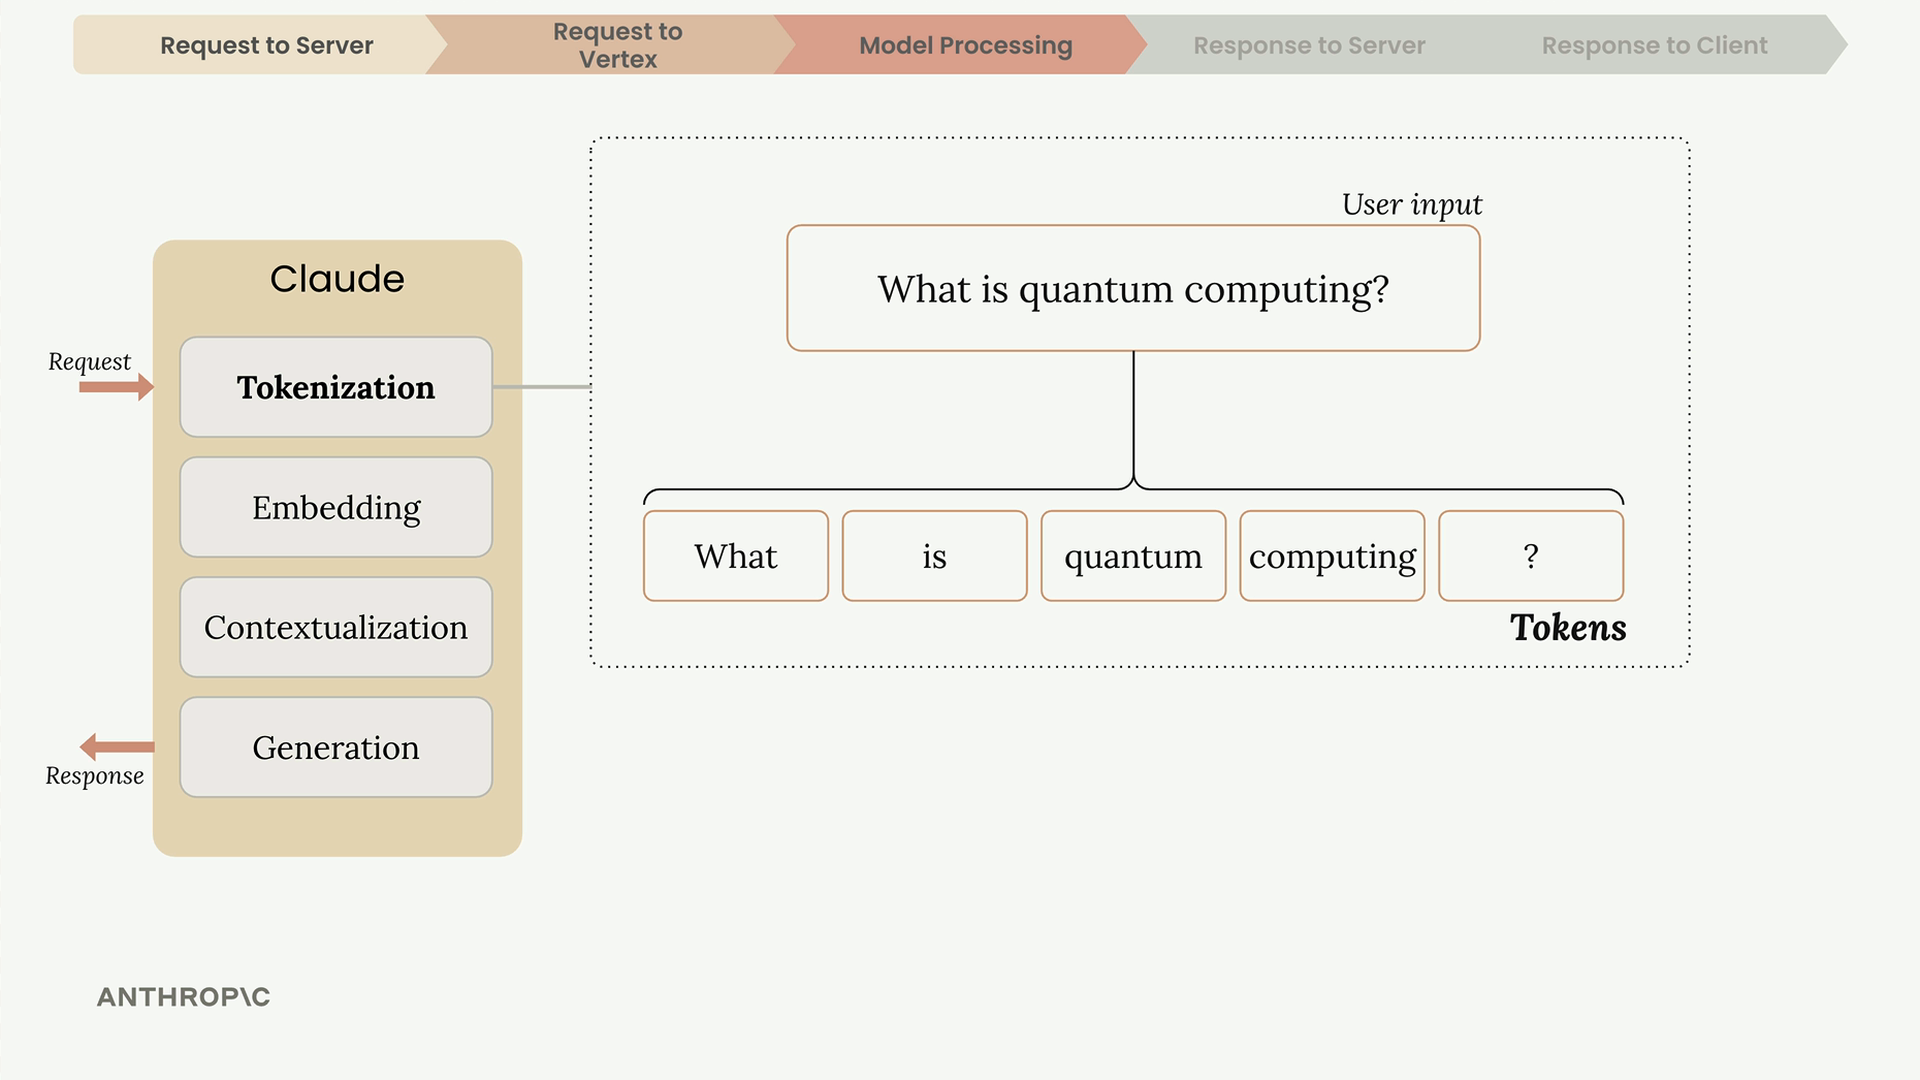
權杖化
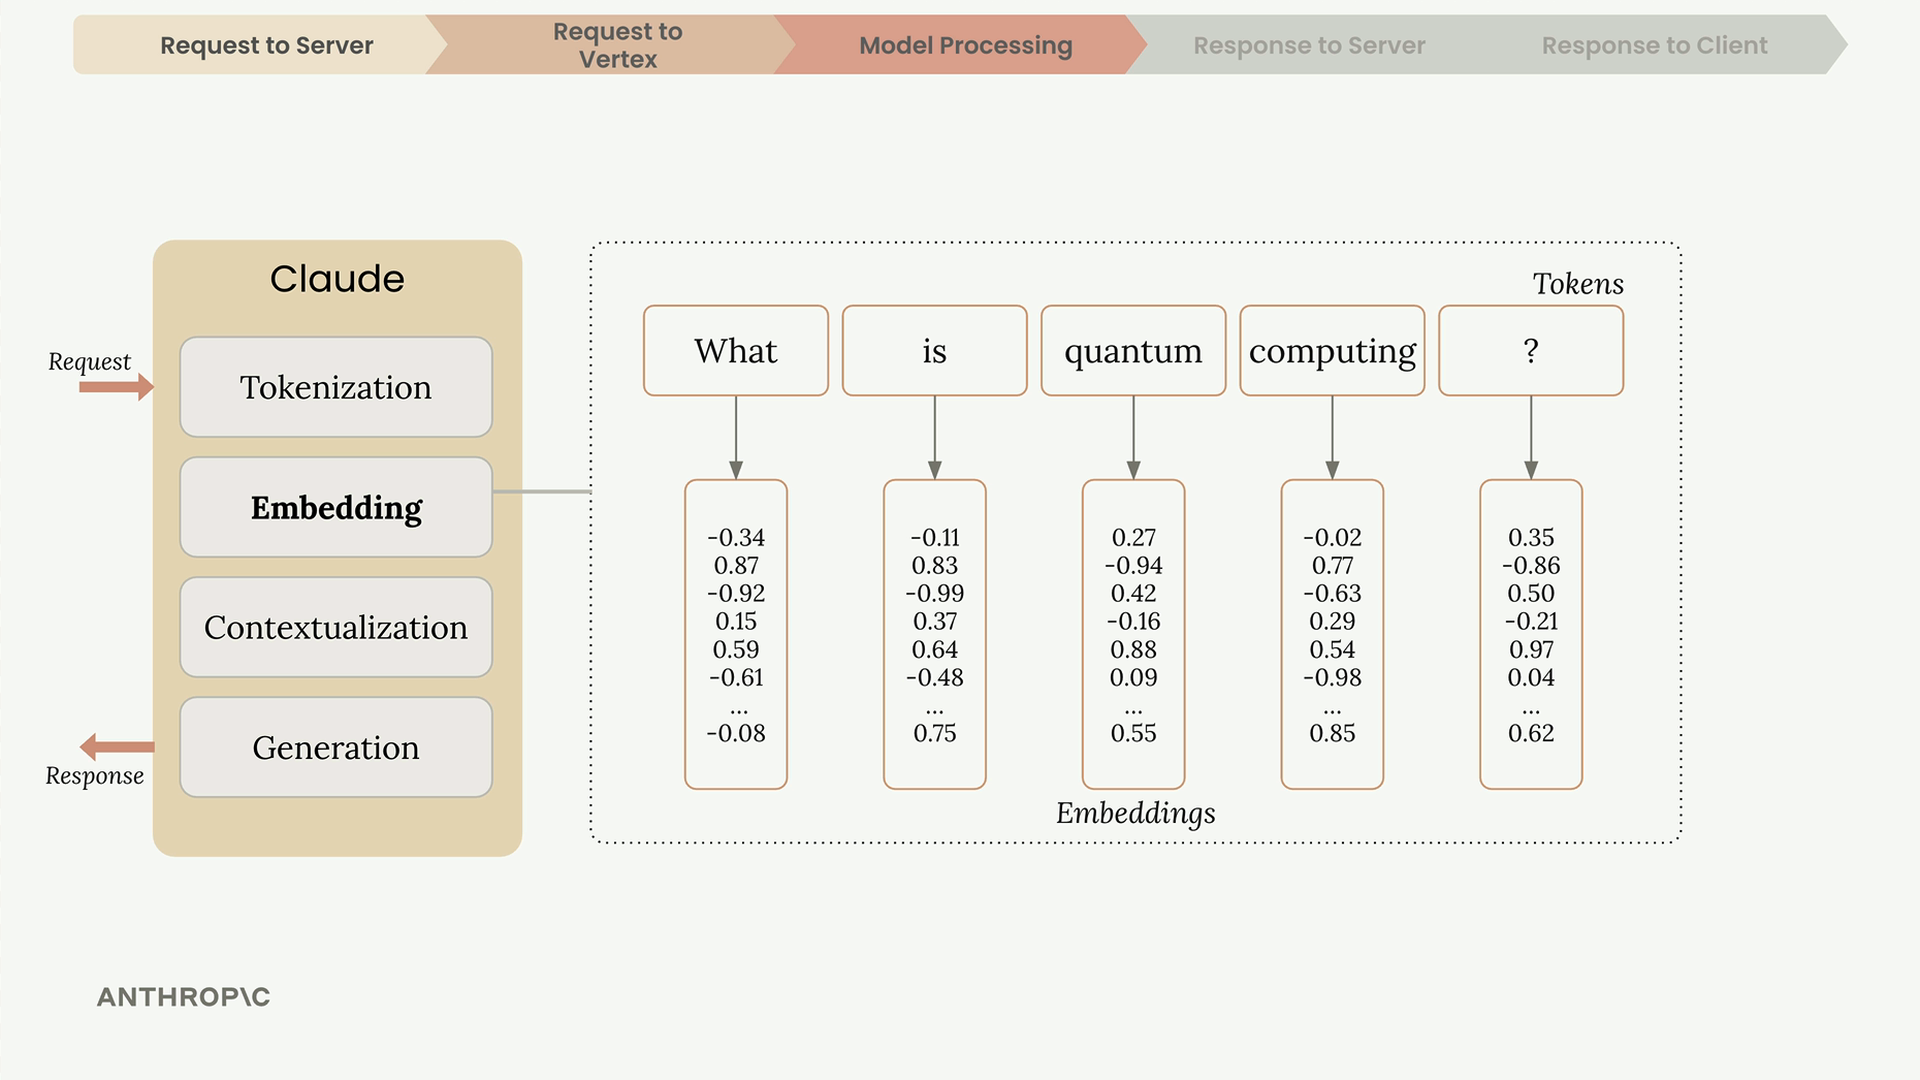
Claude 首先將輸入文字拆解成稱為權杖(token)的較小區塊。這些可以是完整的單字、單字的一部分、空格或符號。為了簡化說明,可以將每個單字視為一個權杖。
嵌入
每個權杖都會被轉換成一個嵌入(embedding)——一長串代表該單字所有可能含義的數字。可以將嵌入想像成以數字表示的定義。
上下文化
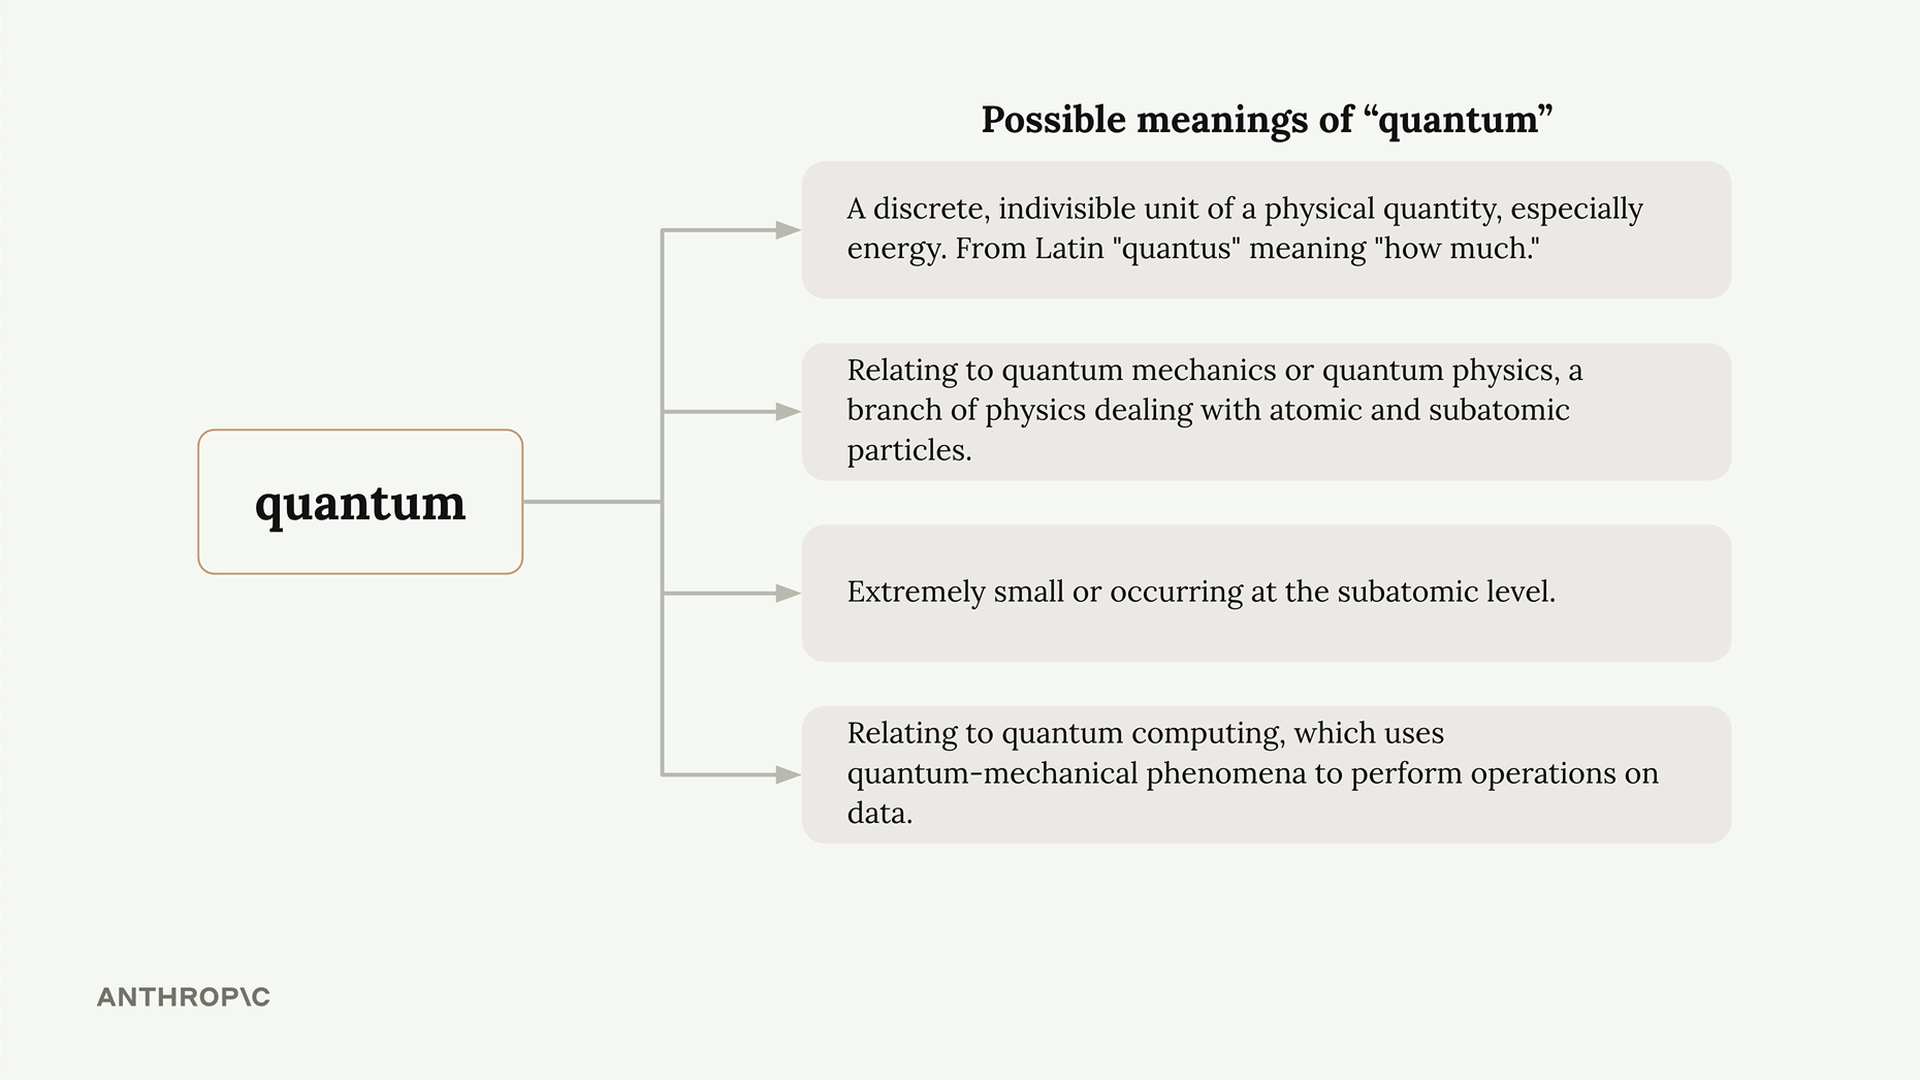
由於單字可能有多重含義,Claude 會利用上下文來判斷正確的解釋。「quantum」這個詞可能指物理學、計算,或只是表示「非常微小」——周圍單字的上下文可以釐清其真正的含義。
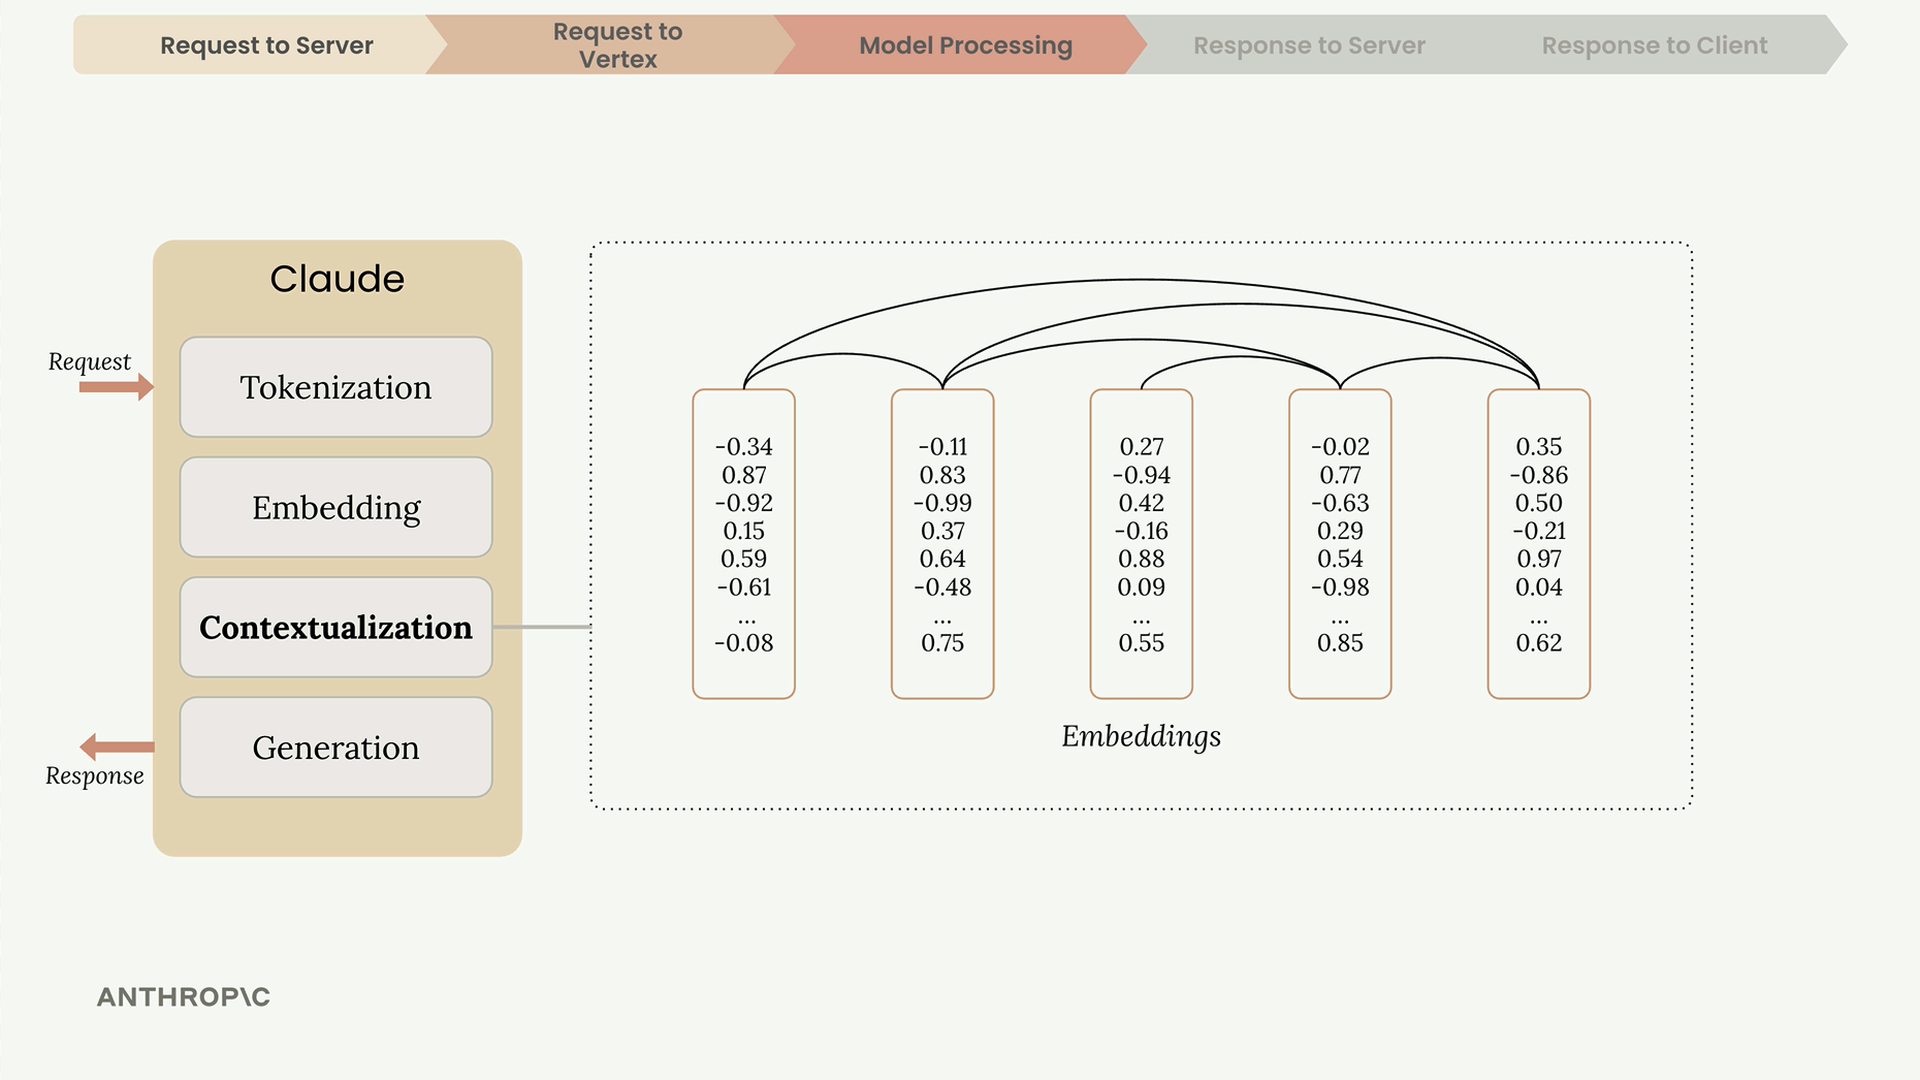
在上下文化的過程中,每個嵌入都會根據其鄰近詞進行調整,突顯出在給定上下文中最合理的含義。
生成
經過上下文化的嵌入會通過一個輸出層,該層會為每個可能的下一個單字產生機率。Claude 並非總是選擇機率最高的單字——它會混合使用機率與隨機性,以產生更自然、更多變的回應。
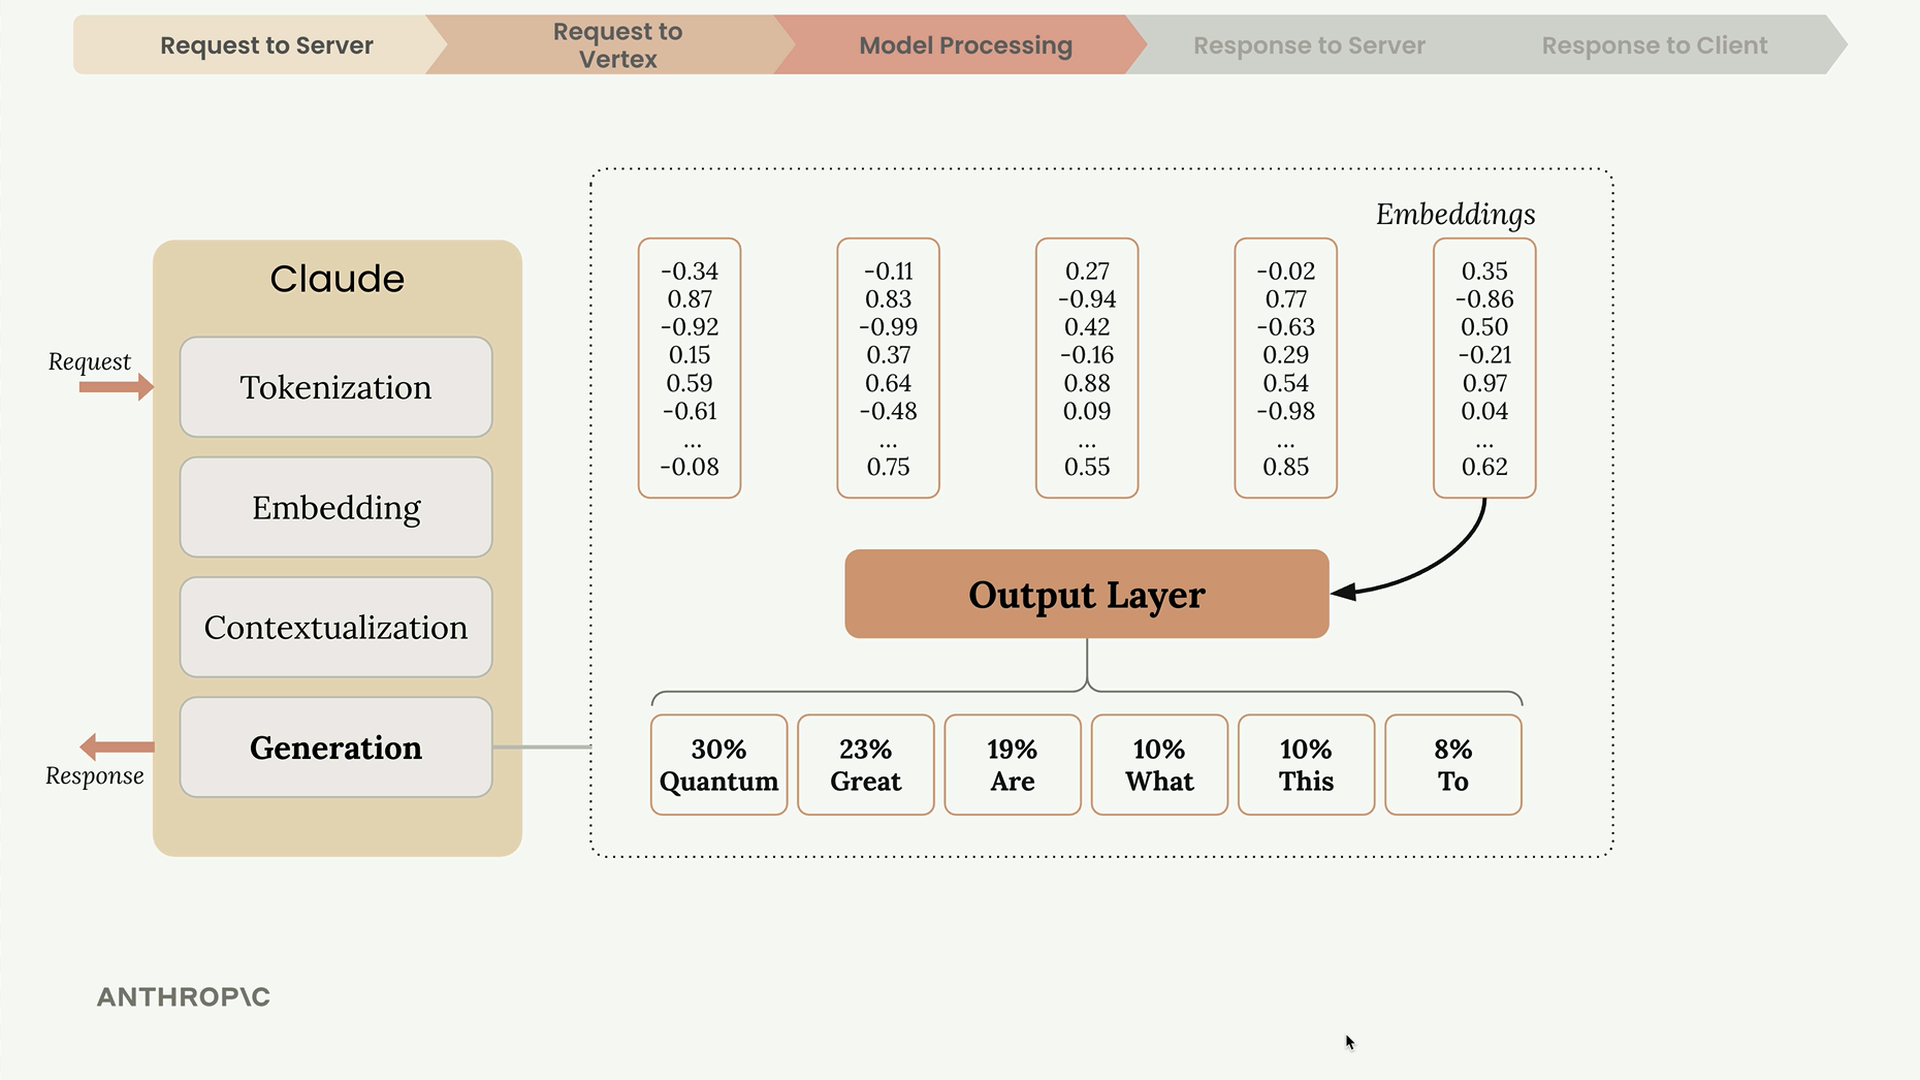
選定一個單字後,Claude 會將其加入序列中,並針對下一個單字重複整個流程。
生成何時停止
在生成每個權杖之後,Claude 會檢查幾個條件來決定是否繼續:
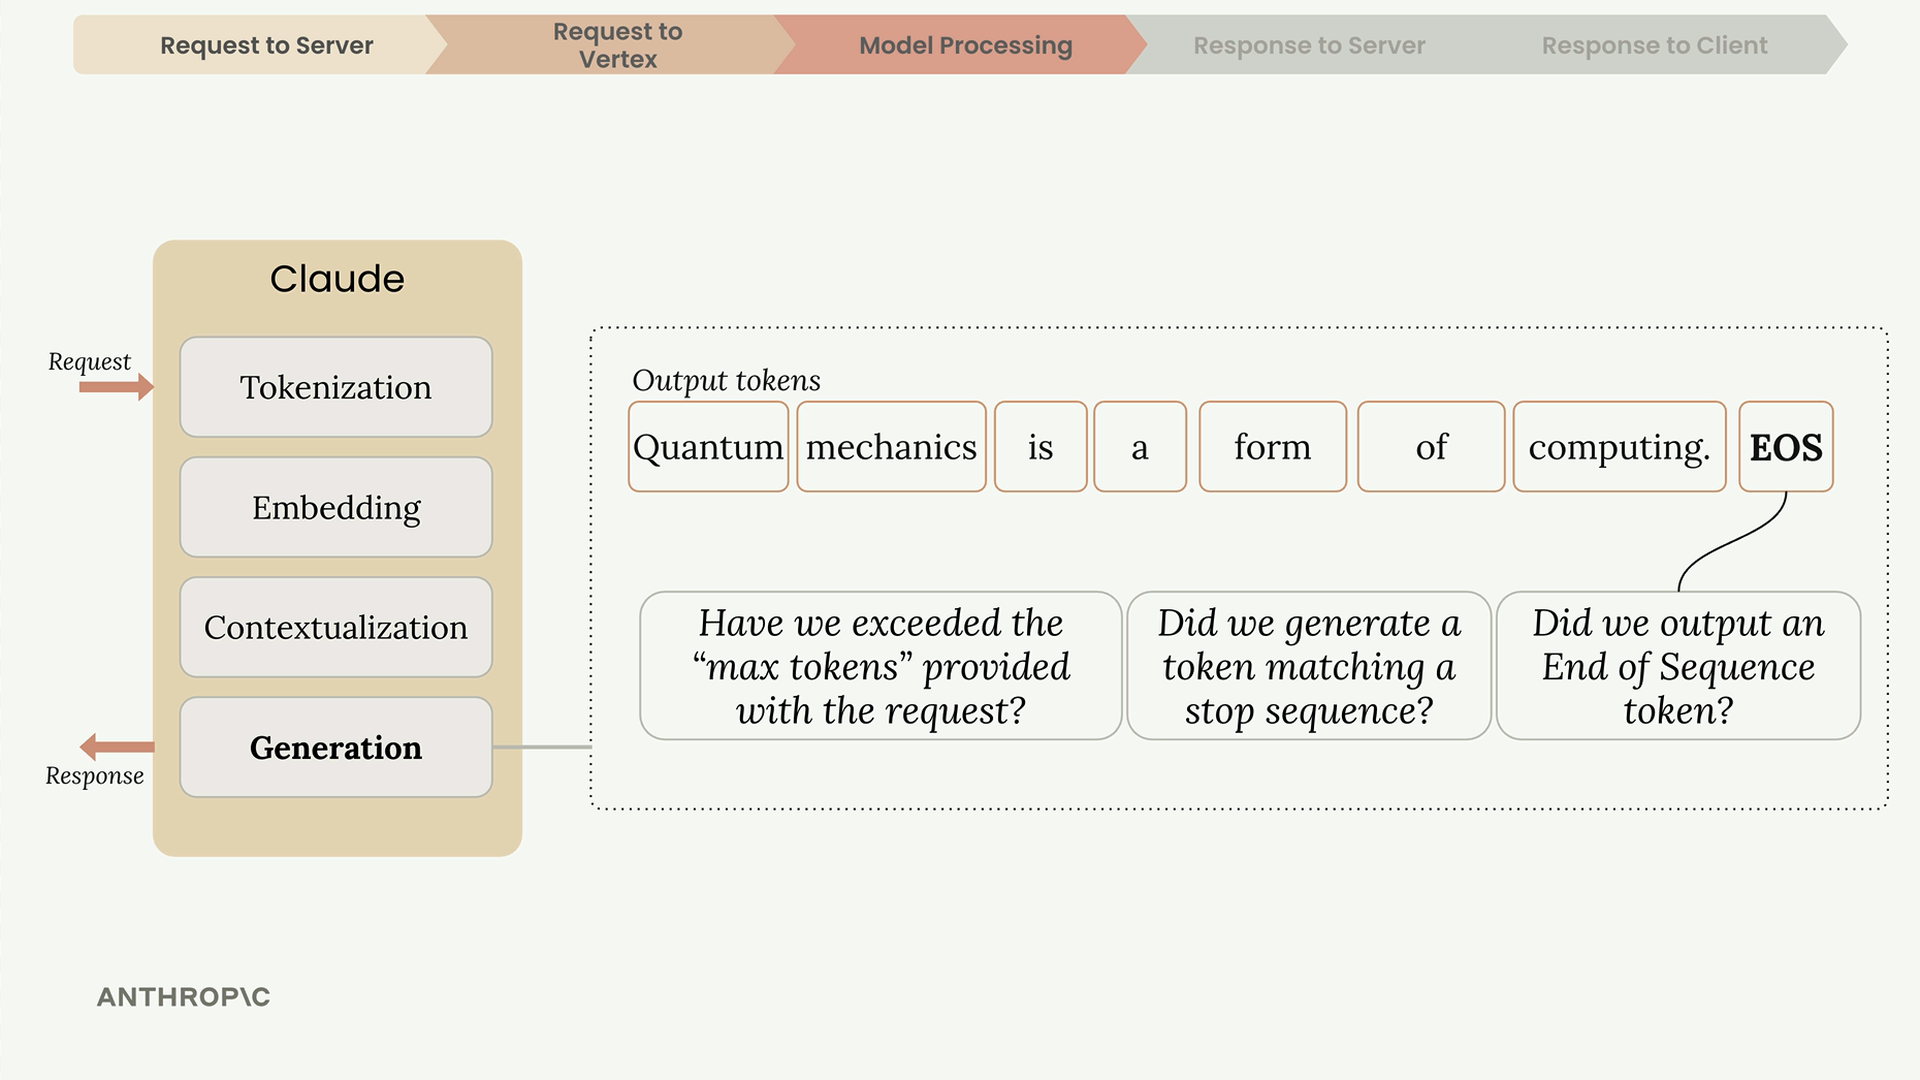
- 達到最大權杖數 - 是否已達到您指定的上限?
- 自然結束 - 是否生成了序列結束(end-of-sequence)權杖?
- 停止序列 - 是否遇到了預先定義的停止短語?
序列結束權杖是一個特殊訊號(並非可見文字),Claude 用它來表示已達到自然的結論。
回應
一旦生成完成,Vertex 會將回應傳回給您的伺服器,其中包含:
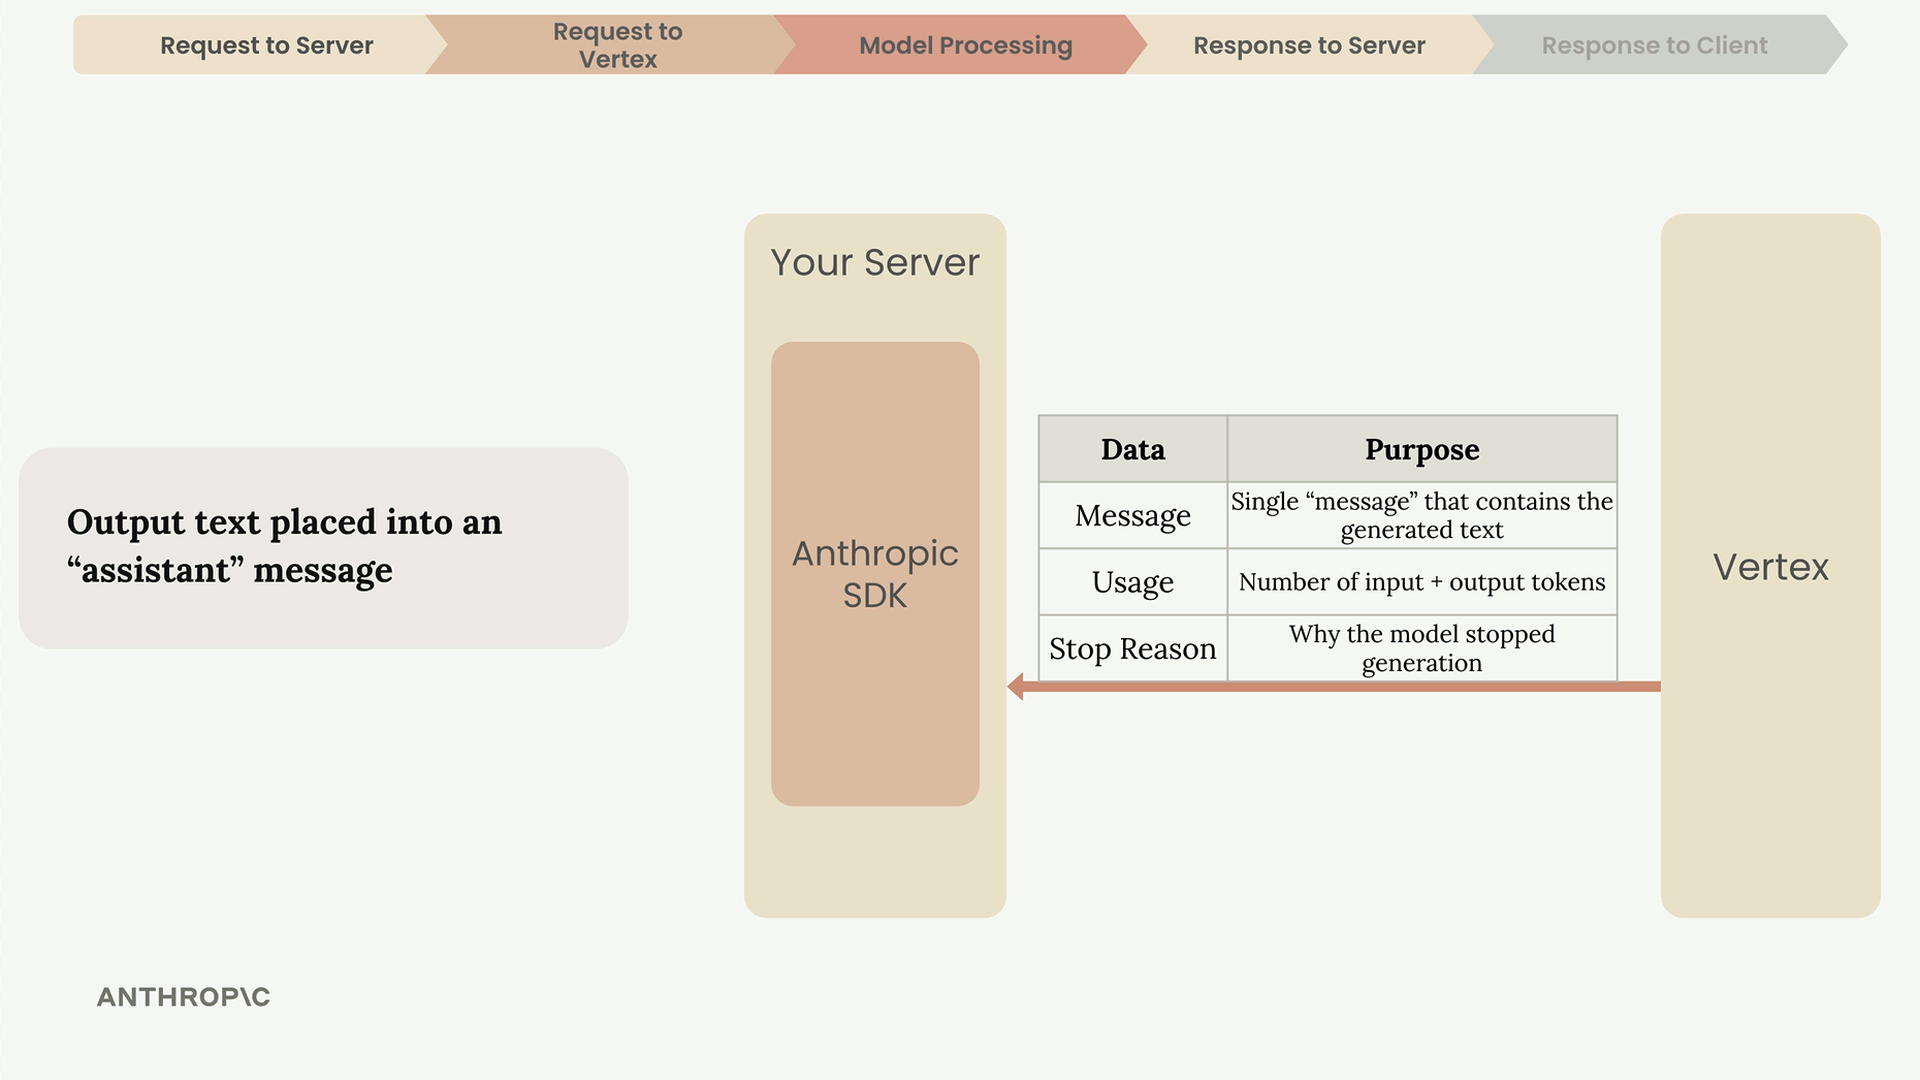
- 訊息(Message) - 生成的文字
- 用量(Usage) - 輸入與輸出權杖的計數
- 停止原因(Stop Reason) - 模型停止生成的原因
接著,您的伺服器會將生成的文字轉發給您的用戶端應用程式,並顯示在聊天介面中。
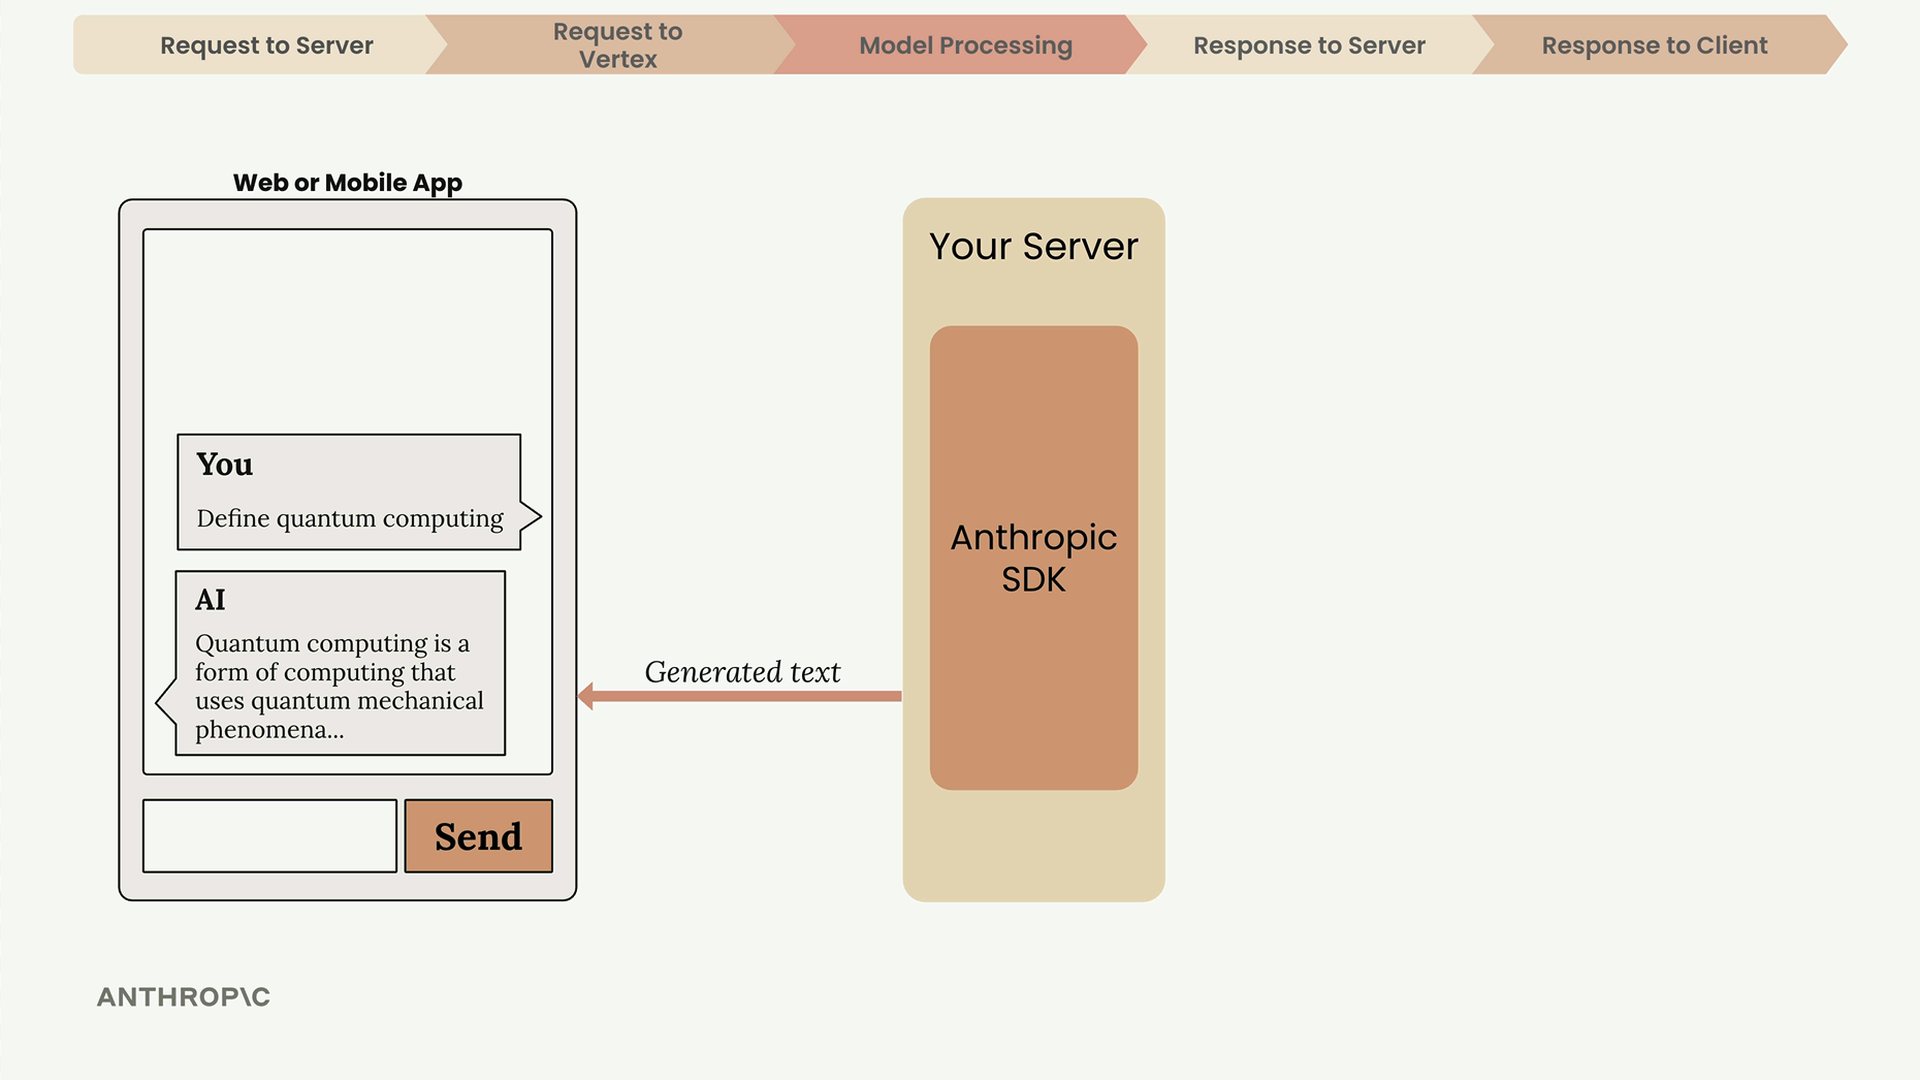
完整的全貌
整個過程——從使用者輸入,經過權杖化、嵌入、上下文化、生成,再回到使用者——都在幾秒鐘內完成。了解這個流程有助於您建置更穩健的應用程式,並在問題出現時進行疑難排解。
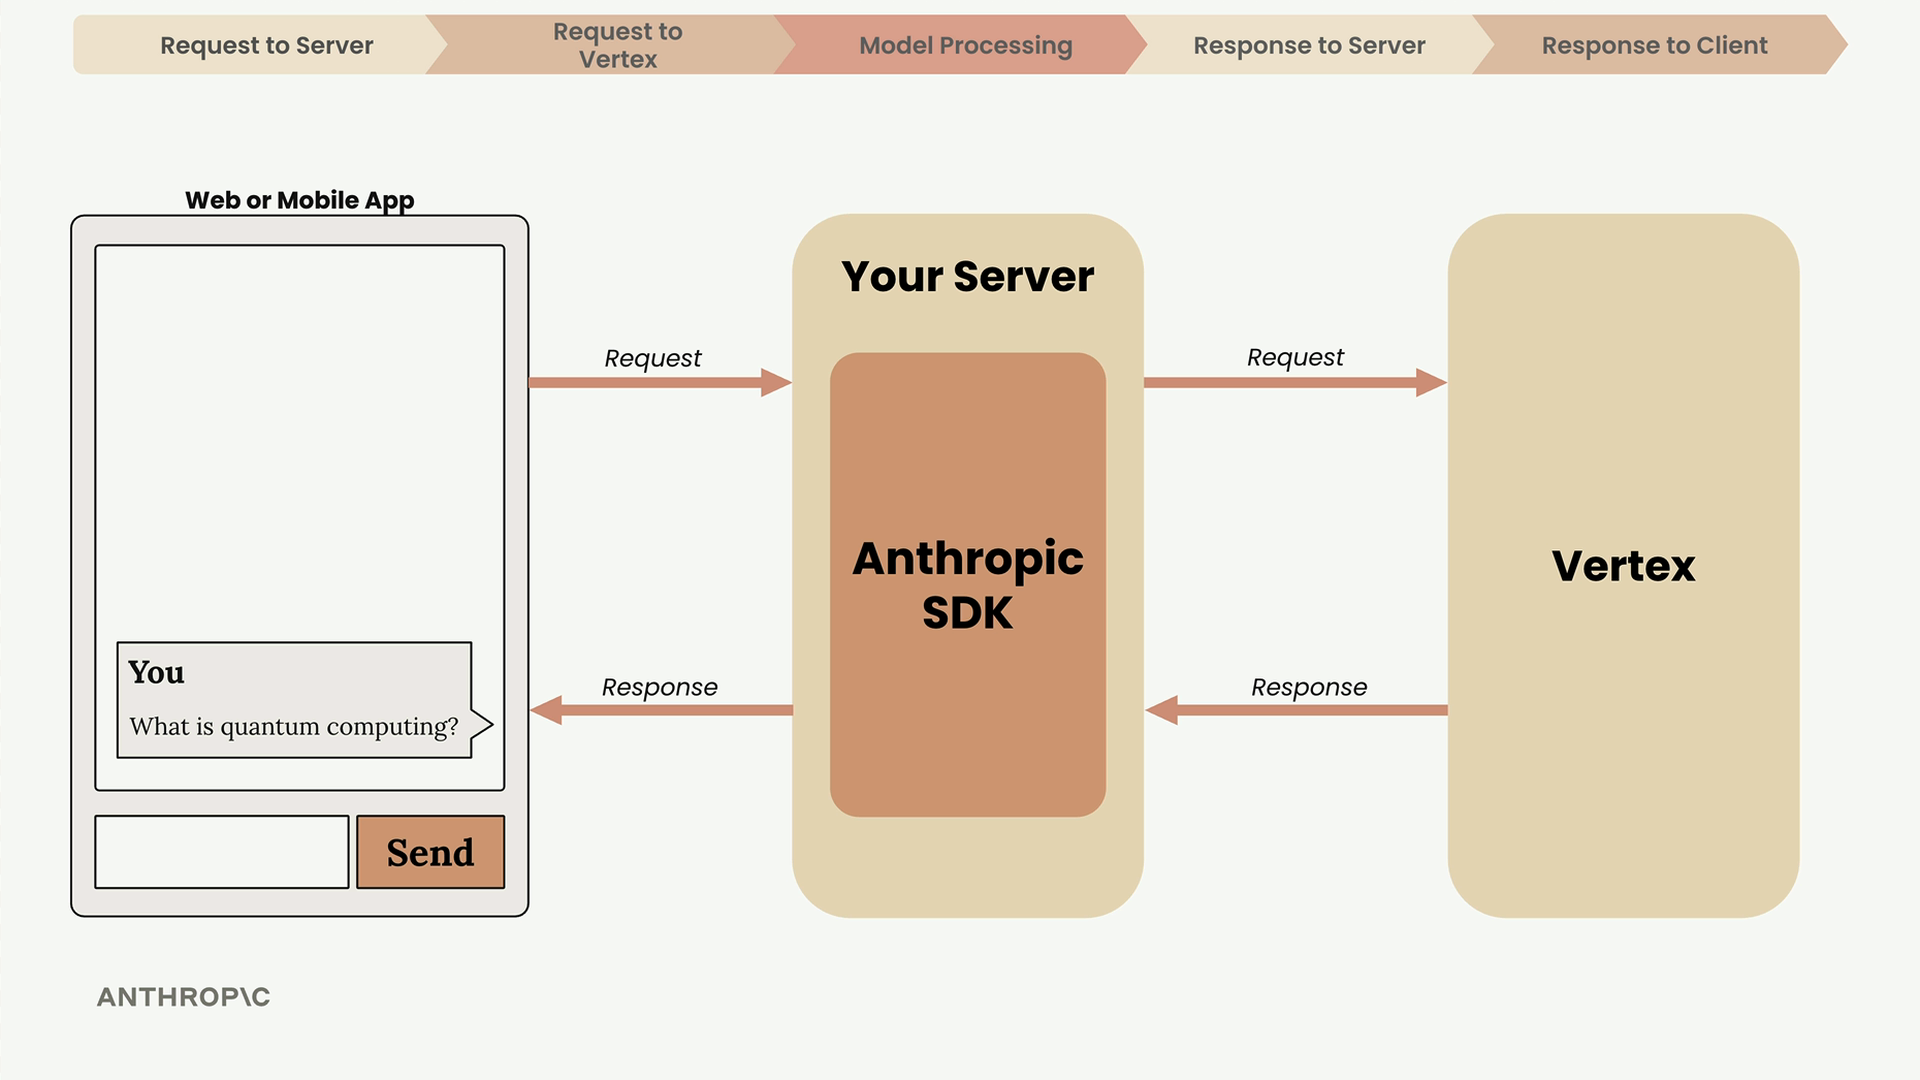
關鍵要點:務必使用伺服器作為中介、理解文字生成是一個反覆進行的過程,並注意回應的元數據,以監控用量並了解模型行為。