エージェントの構築:サブエージェントをメインのエージェントループに組み込むタイミング
Claude Platform でエージェントを構築する場合、サブエージェントの数を減らし、代わりにコンテキストやツールを段階的に開示することで、コストとレイテンシーを削減しながら品質を向上させることができます。 移行のタイミングと方法をご紹介します。
複数のサブエージェントを含むエージェントを Claude Platform で構築している場合は、当社の移行キットを使用して、どのサブエージェントをメインのエージェントループに組み込むのが適切かを確認しましょう。 ガイド付きワークフローを実行してパターンを特定し、代替案を評価して最適なアプローチを検証します。 エージェントで実行する前に、モックシステム上で試せるデモが含まれています。
サブエージェント(独自のコンテキスト ウィンドウ、ツール、指示を持つエージェント)は、コーディネーターによって統括され、エージェント設計の中核的な要素です。これらは、検証、並行作業、モジュール式権限付与に効果的です。当社では、Claude Platform を使用して構築する多くの自社エージェント、たとえば当社のマルチエージェント研究システムで、これらを活用しています。
しかし、Applied AI チームは最近、ルーター、プランナー、ドメインのサブエージェントをメインのエージェントループに組み込むことで恩恵を得ているエンタープライズエージェントの導入に、あるパターンを発見しました。 複数のエンタープライズ環境での導入を比較したところ、スキルを備えた単一エージェントは、単一プロンプトで処理する設計とサブエージェント設計の両方を品質面で上回ることが多く、多くの場合、タスクあたりのコストとレイテンシーも低く抑えられました。
たとえば、ある企業は、顧客対応エージェント内に多数の専門サブエージェントがあることで、ブランドに沿った一貫した体験の維持が難しくなり、レイテンシーを増加させてユーザー体験を損なっていることに気づきました。
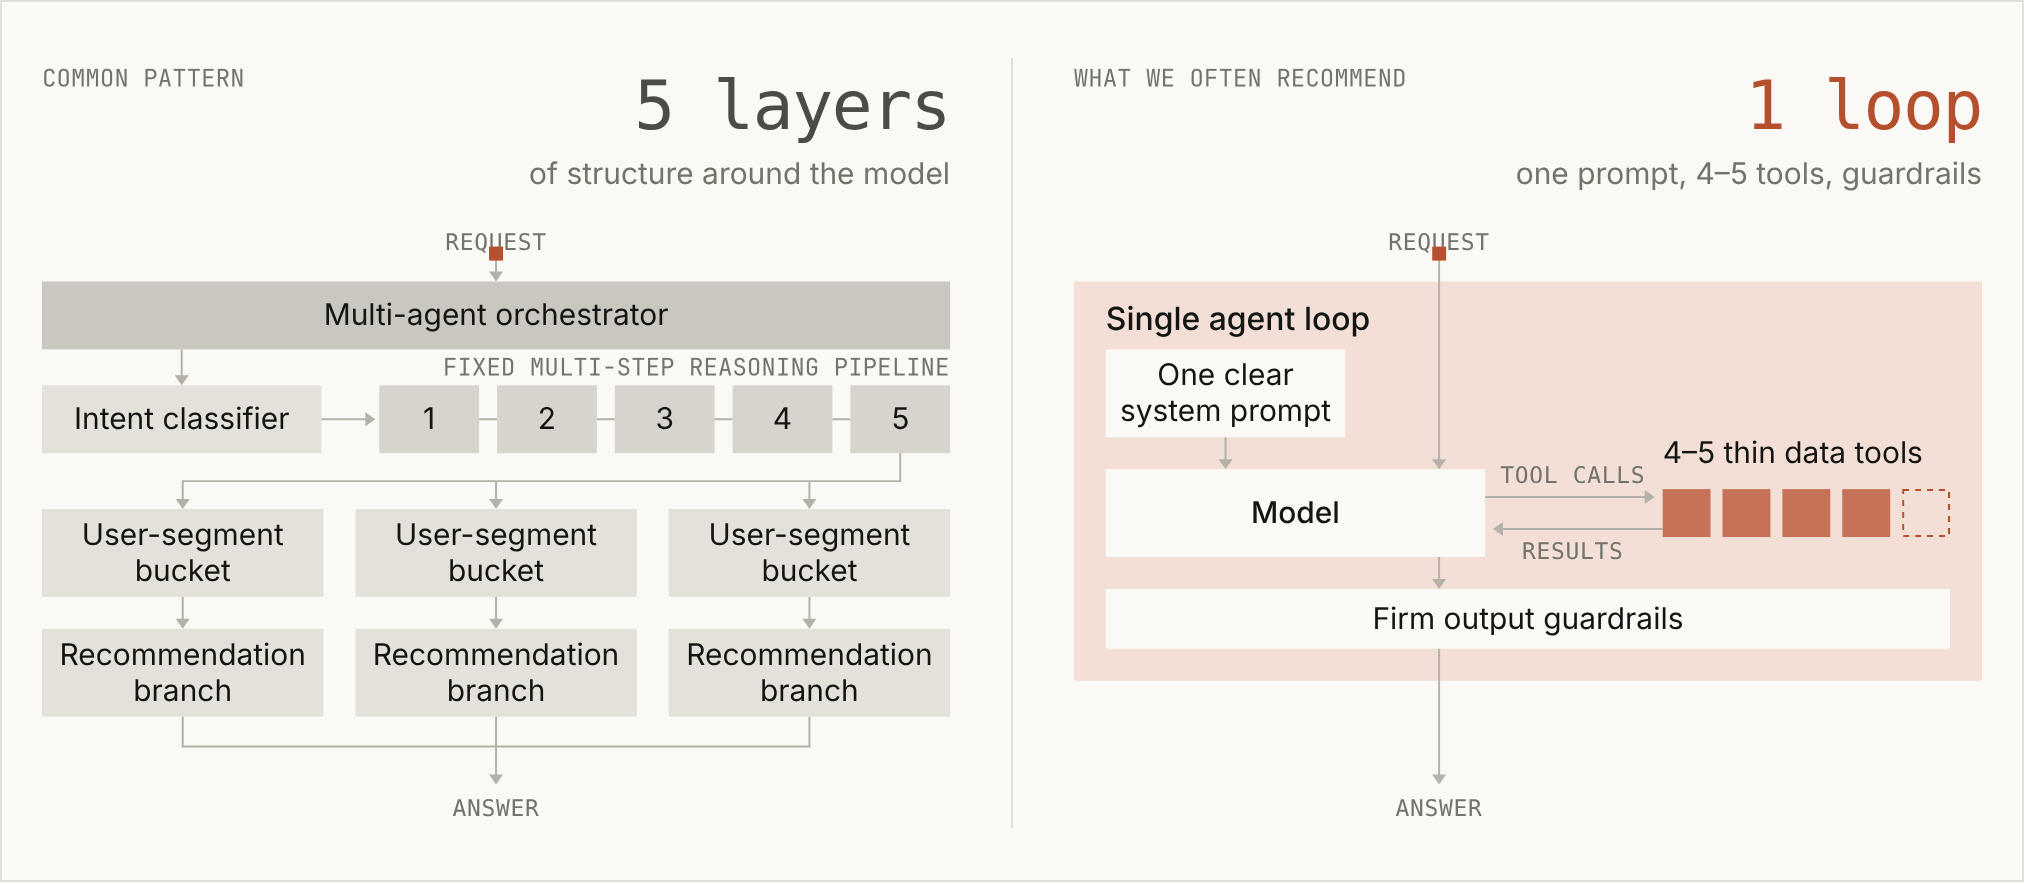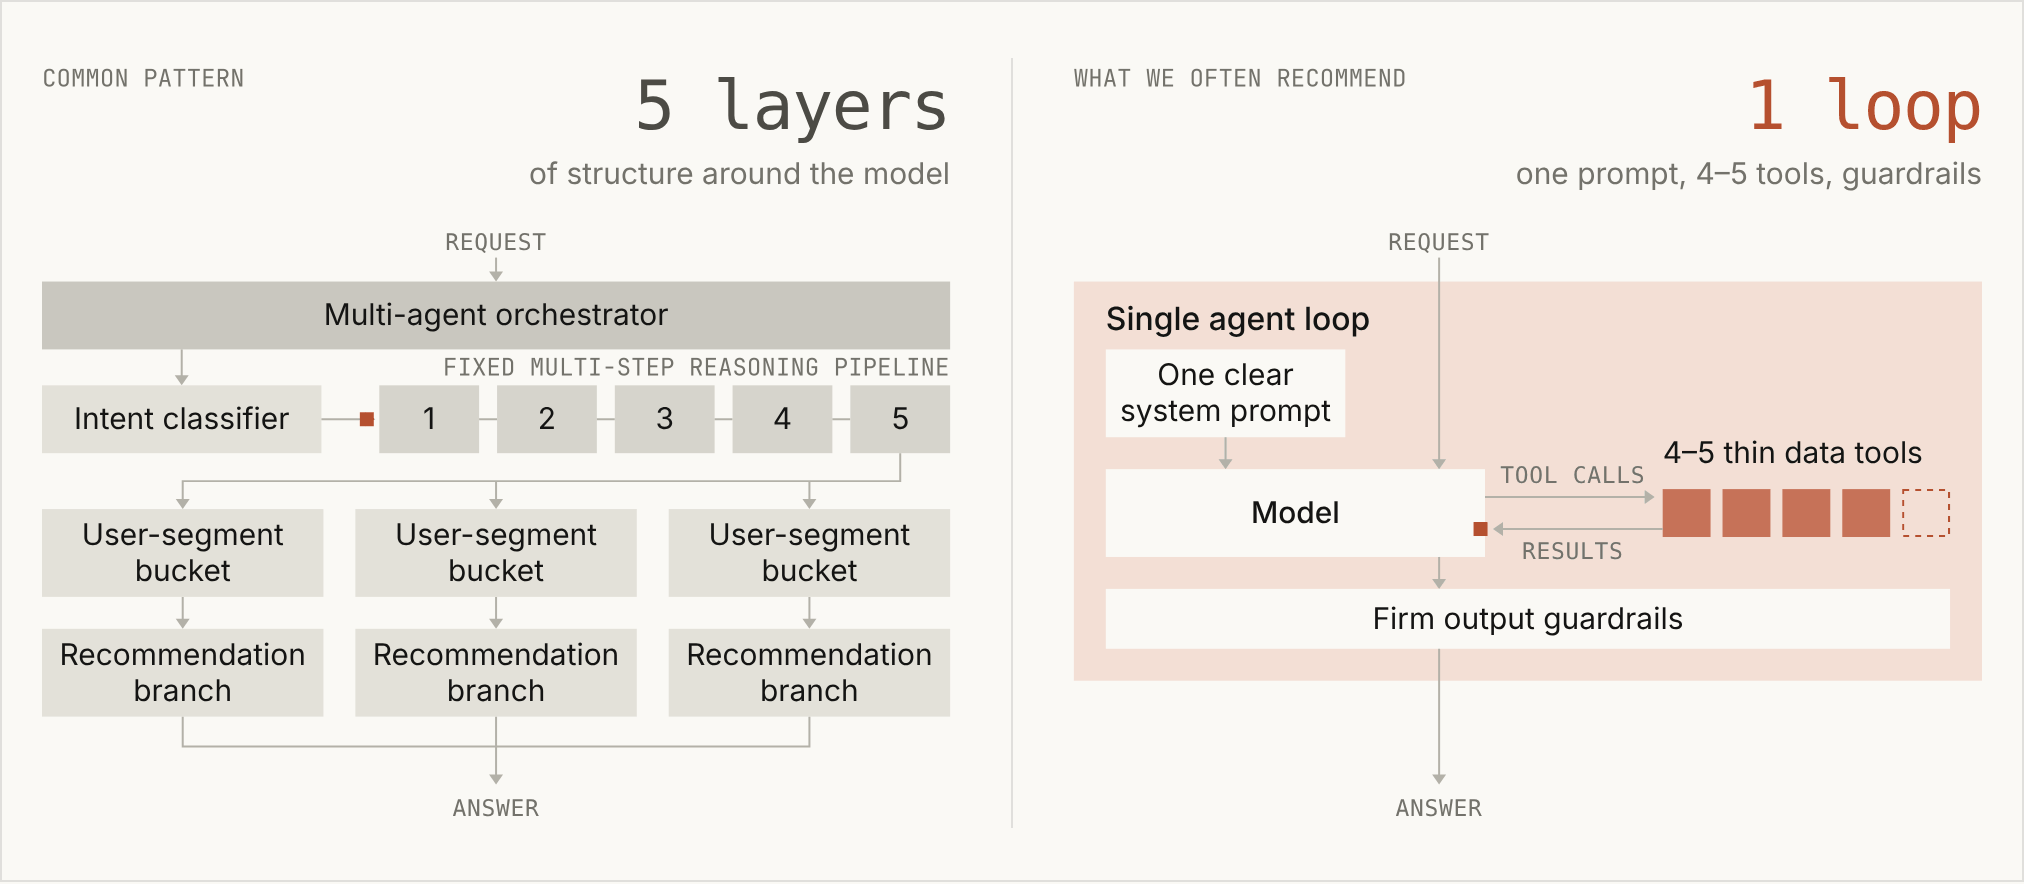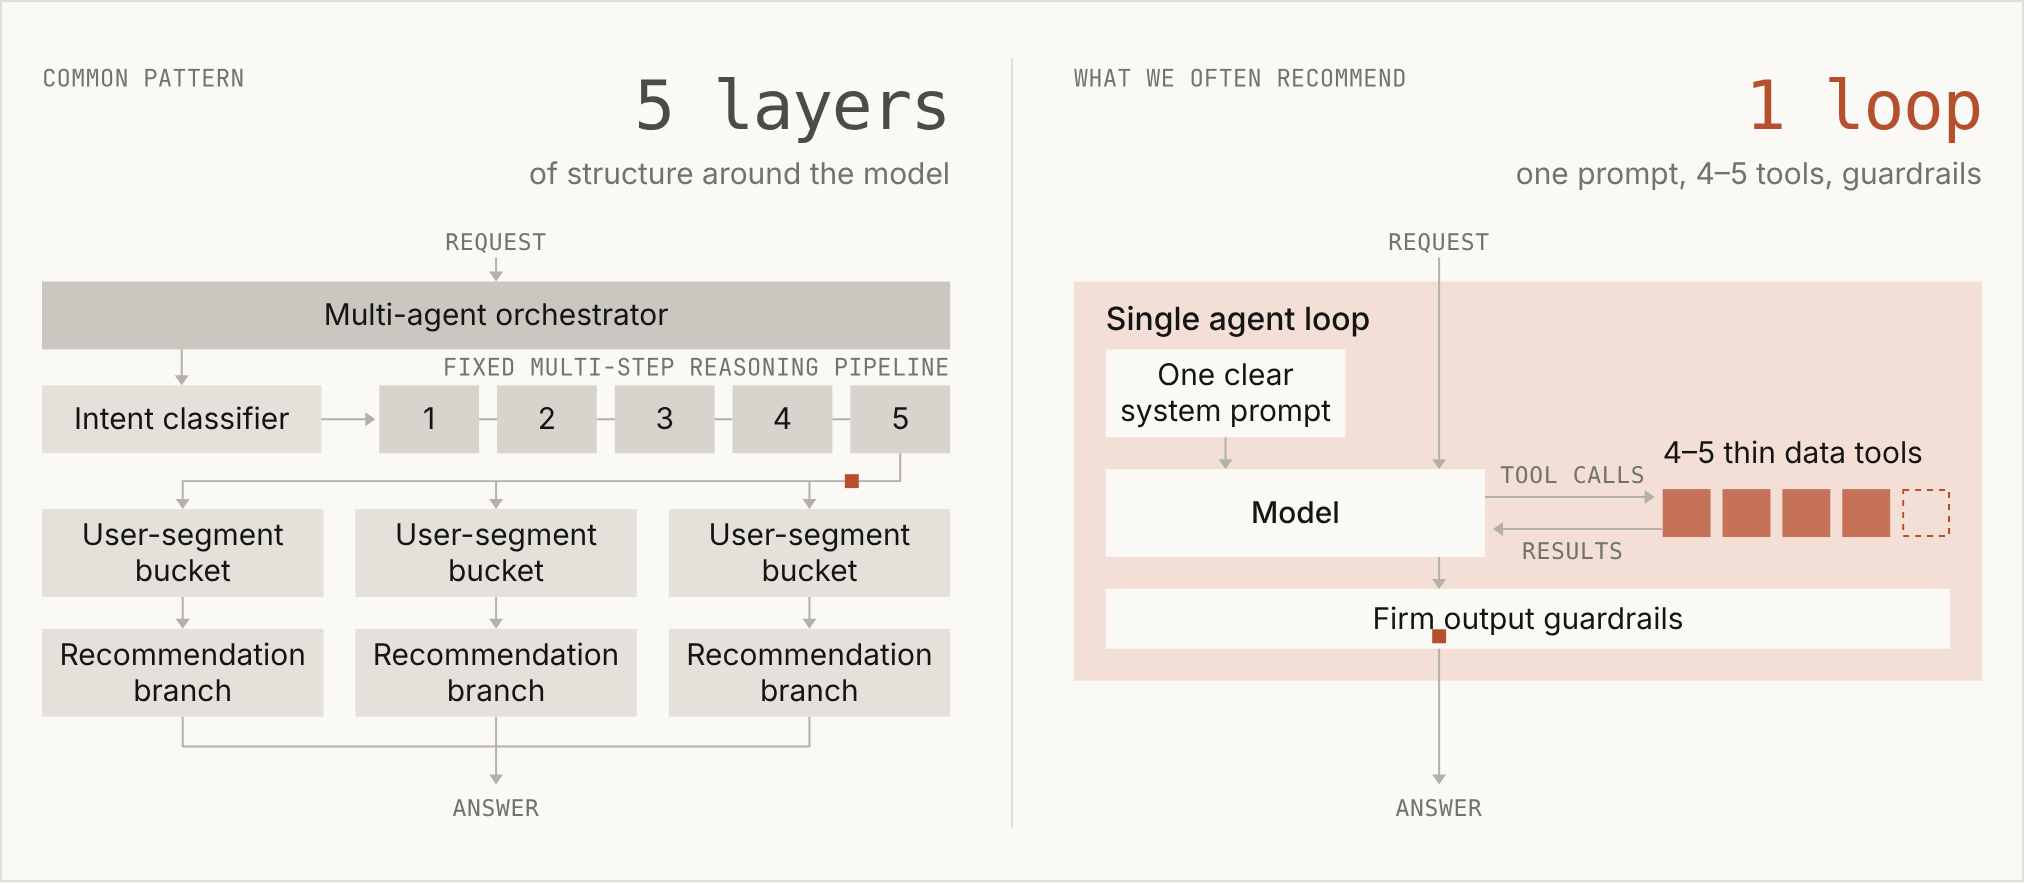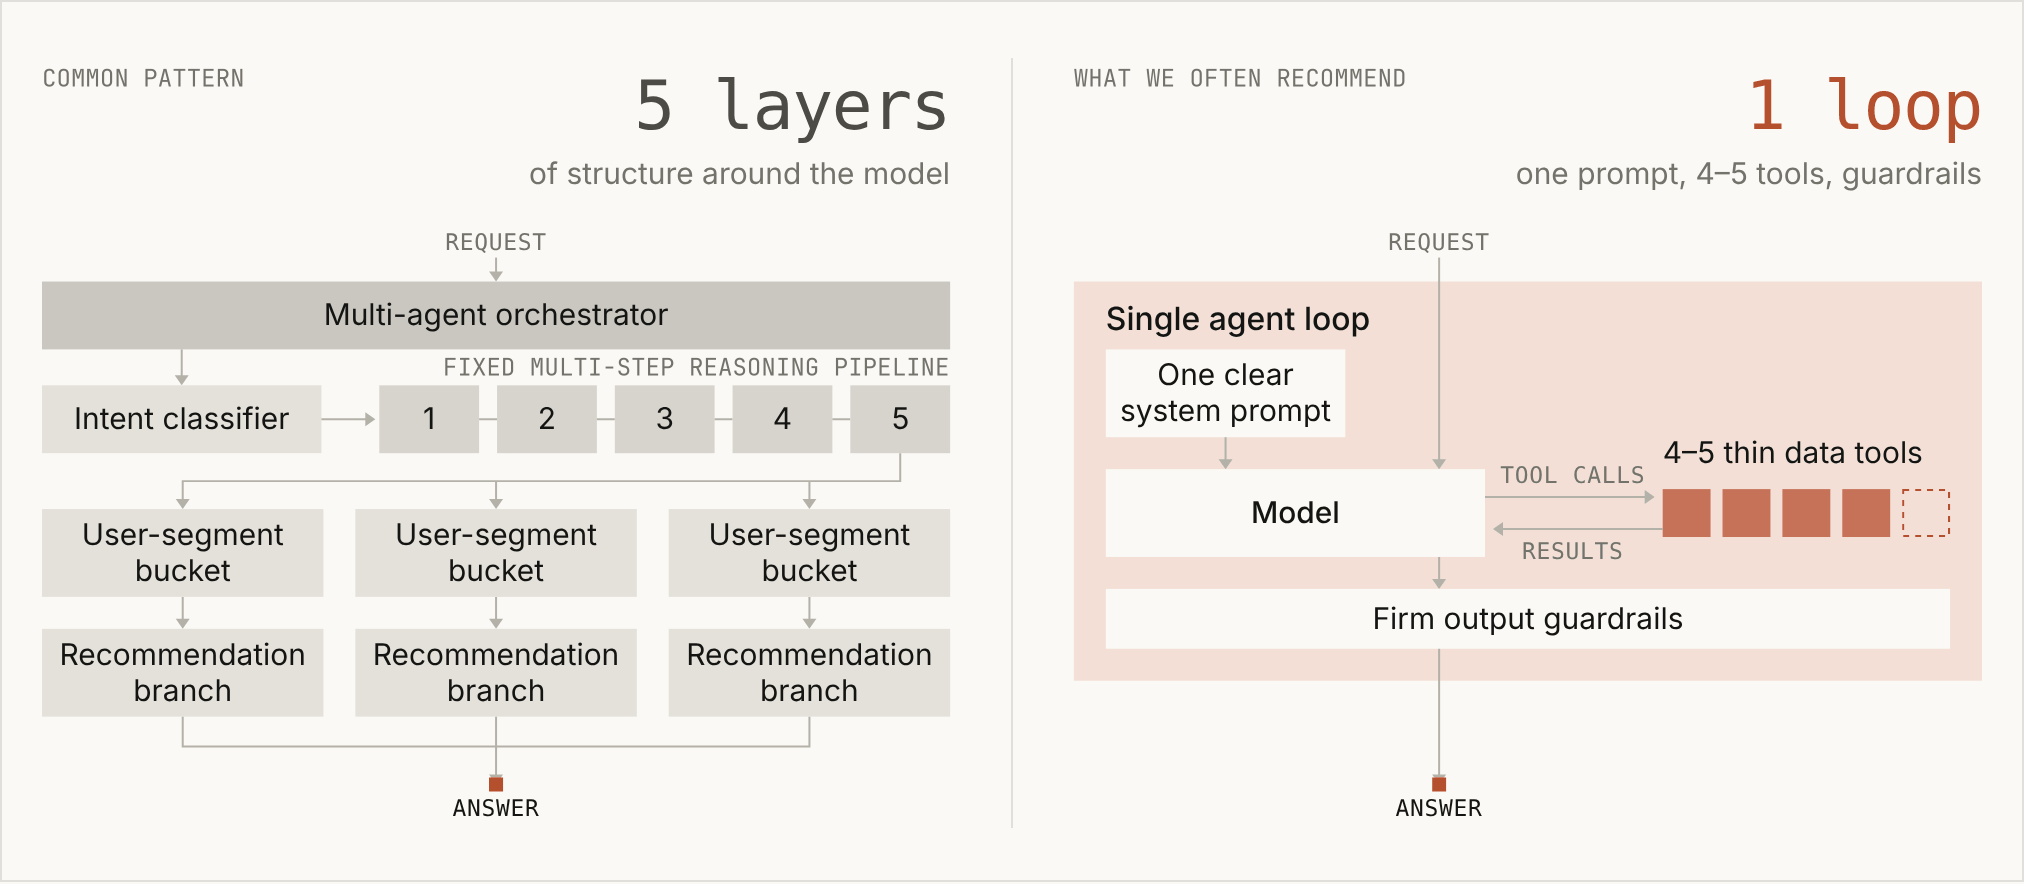
また、よく見られるエージェントの設計案は、おなじみの流れに沿っています。インテント分類器、固定された複数ステップの推論パイプライン、ユーザーセグメント別のバケット、個別のレコメンデーションブランチ、そしてそれらの上に配置されたマルチエージェントオーケストレーターです。
このようなケースでは、この構造の大部分は、モデルにとってもはや不要な作業を担っていたこと、そして明確なシステムプロンプト 1 つ、4~5 個の軽量なデータツール、厳格な出力ガードレールがあれば、ユースケースの大部分をカバーできることが、フィードバックとしてよく寄せられます。
念のため申し添えると、サブエージェントには、研究の最前線を含め、今でも活躍の場があります。 以下の場面で使用してください:
- 単一のエージェントループで、コンテキストの膨張により測定可能なパフォーマンス低下が発生する場合、または、
- 複数のタスクを、完了後に破棄可能な新しいコンテキスト ウィンドウを用いて並行処理する必要がある場合や、
- 単一のエージェントが適切なツールを選択するのに苦労したり、システムプロンプトで指示が矛盾する場合もあります。
しかし、企業がチームや課題タイプごとに独自のサブエージェントを割り当て、エージェントのアーキテクチャが組織図のコピーになってしまうケースがあまりにも多く見られます(Conway の法則が働いている例です)。
この記事では、大規模組織でのエージェント構築から学んだベストプラクティスを基に、サブエージェントをメインのエージェントループに組み込むことを検討すべきタイミングについて説明します。
大規模組織におけるエージェント構築の失敗モード
企業は、複数の製品や機能を単一のカスタマーインターフェースに統合するエージェントを構築したいと考えていることがよくあります。
一般的には、各機能は別のチームが担当するため、企業はまず個々のチームに独自のエージェントを構築してもらうことから始め、その後、中央のプラットフォームチームがその上にオーケストレーターを構築します。この構成には、オーケストレーター・サブエージェント型や、特定のエージェントを MCP ツールとして公開した単一エージェントなど、いくつかの形があります。
これは最もシンプルな解決策のように思えますが、以下の点で即座に複雑さをもたらします:
- コンテキスト管理:エージェント間でどのようなコンテキストを交換するかを決定する必要があり、やり取りの中で詳細が失われることもよくあります。
- サブエージェントの無秩序な増加:各チームが独自のサブエージェントをリリースするため、結果として企業は、標準が徹底されず明確なオーナーもいない、重複した何百ものサブエージェントを抱えることになります。
- フランケンプロンプト:各チームがシステムプロンプトに文を追加するため、ルールが矛盾し、一貫したトーンが失われます。
- 未検証で、過度にローカライズされた評価:誰もがそれぞれ、自分のサブタスクに対して過度に最適化された独自の評価を追加しています。そのセット全体を統括・管理する部門がなく、経営陣は内容が希薄化されて過度にローカライズされたスコアに基づいて意思決定を下します。
- レイテンシ:マルチエージェントのアーキテクチャが複雑になるため、レイテンシが増加します。 マルチエージェントのハーネスを単一エージェントループと比較評価したあるお客様では、後者のほうが実行速度が約 2 倍速くなりました。
段階的開示を用いたエージェントループの利用
上述したオーケストレーター・サブエージェント型の設計は、複数のチームにわたって構築された専門エージェントを連携させるための合理的なアプローチですが、多くの場合、より効果的なのは、スキルによるコンテキストの段階的開示、およびツール検索によるツールの段階的開示です。言い換えれば、エージェントにはスキルやツールの短い説明のみが提示され、それらは必要な場合にのみ完全に読み込まれます。
このアプローチが理にかなっていると考えられる理由は、以下の 3 つです:
- コンテキストを共有することで、より良い回答が得られます:長時間実行されるエージェントの場合、複数の異なるタスクのコンテキストをメインのコンテキスト ウィンドウに保持したいと考えます。 前の各ステップの結果を確認したエージェントは、それらの結果を結びつけることができるため、サブエージェントから返される一連の要約よりも豊かな出力と優れたインサイトが得られます。また、コンテキストウィンドウが少なくなり、損失を伴う引き継ぎも減ることを意味します。
- 段階的な開示により、コンテキストの膨張を防げます:この手法により、チームはすべてのコンテキストを 1 つの長いシステムプロンプトにすぐに読み込む必要がなく、多種多様なタスクを完了できる単一のエージェントを構築できます。これは、チームが以前、サブエージェント間で作業を分散させていた主な理由を取り除きます。実際、より高度なモデルに対する Claude Code のシステムプロンプトは 80% 以上削減されており、これにはスキルやツールの段階的な開示に関連する削減も含まれています。
- モデルの能力は向上しました:Opus 4.5 以降、ほとんどのチームが予想していたよりもはるかに多くのことを1つのループで処理できるようになりました。 Opus 5.5 および Fable 5.1 では思考をオフにすることはできず、最近のモデルは作業を進めながら進捗状況を説明し、自身の作業を確認する傾向が強まっているため、一部のハーネス要素が不要になっています。新しいモデルが登場するたびに、より多くの意思決定をハーネスからモデル自体に移行することができるようになります。ループがシンプルであれば、次のモデルへの移行も容易です;私たちが支援したお客様の移行事例では、硬直したマルチエージェント構造が、新しいモデルがより多くの作業を担うことを妨げているケースが多く見られました。
単一エージェントのループ設計には、慎重に管理されたシステムプロンプト、適切なタイミングで起動するスキルやツールの説明、コンテキストウィンドウ、メモリ、メモ取りの意図的な処理など、規律が必要です。この記事では、以降のセクションで、移行と設計の考慮事項について詳しく説明します。
エンドツーエンドの品質とシステムプロンプトは 1 つの中央チームが管理し、新しいツールや eval はすべてリリース前に審査するべきです。中央チームを小規模に保つことで、反復を迅速に進められ、大規模な組織全体での調整コストも削減できます。
マルチエージェントのアプローチを採用する場合は、うまく機能する可能性のある最もシンプルなパターン(ジェネレーター・ベリファイア、オーケストレーター・サブエージェント など)から始めましょう。コンテキストごとに分割して境界を効果的に切り分けましょう:各サブエージェントには、システムの他の部分にほとんど依存しない作業を割り当て、コンパクトな結果を返させます(独立した調査パス、明確なインターフェースを持つ個別のコンポーネント、ブラックボックス検証などが適した候補です)。 課題の種類によってエージェントを分割すると、情報が「伝言ゲーム」のように行き来し、引き継ぎのたびに精度が劣化していきます。
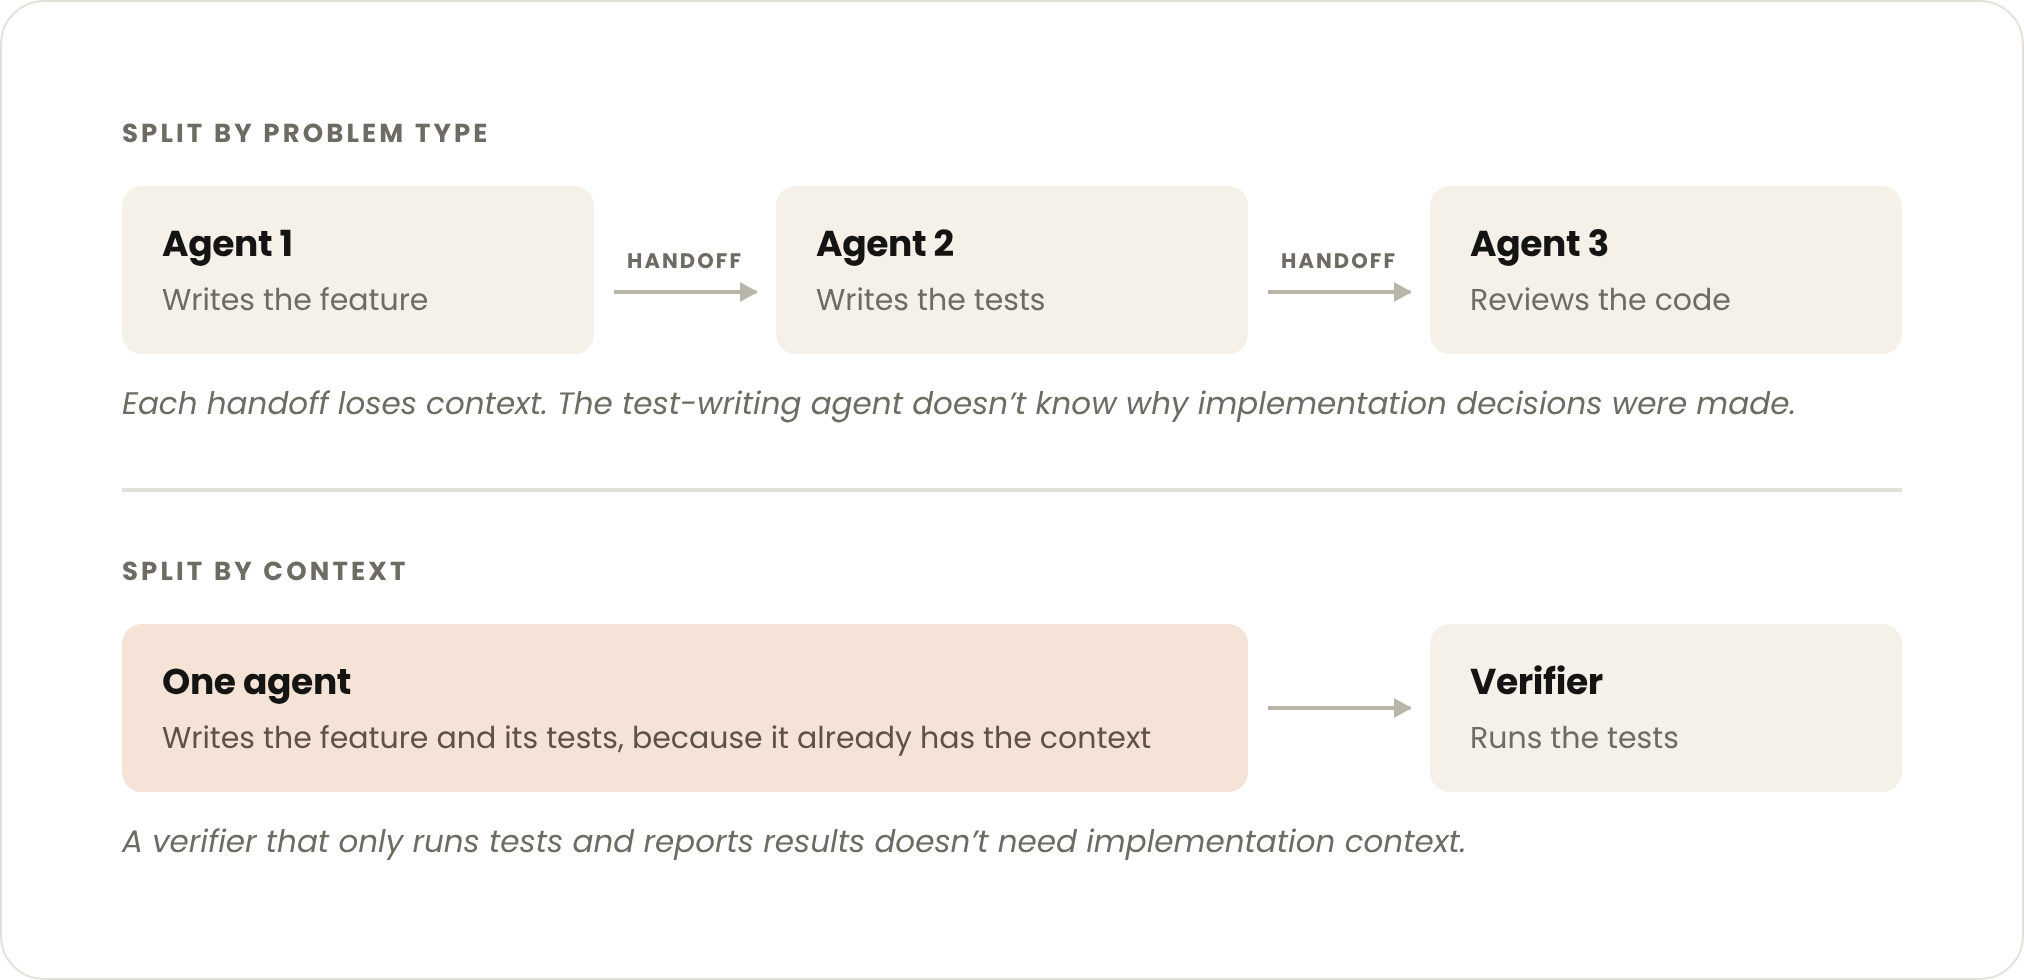
サブエージェントをメインのエージェントループに統合する方法
多くのチームは、オーケストレーターと一連の専門エージェントをすでに本番環境で運用しています。 以下は、私たちが推奨するシングルループ設計です:
- 1 つのモデルと 1 つのコンテキスト ウィンドウでオープンエンドなツールループを実行し、制限(ターン数とコストの予算、書き込みゲート)はハーネス内に設定します。
- 各ターンで、モデルはツール呼び出しのバッチを発行します。 ハーネスはこれらを並列に実行し、生の結果を同じモデルに返します。モデルは次のステップとして、別のバッチ、ユーザーへの質問、回答のいずれかを決定します。
- モデルが回答するか予算に達すると、ループは停止します。 回答後に、目標チェックまたは検証チェックを任意で実行することもできます。
- モデルは最初のターンで計画をコンテキスト内に書き出し、結果が得られるたびに修正します。これは、オーケストレーターと専門エージェントによる構成からの主な変更点です:計画を作成するモデルがその実行もするため、ターンの途中で計画を変更することができます。
- コンテキストは引き続き読み込まれ、エージェント自体が管理します:
- 各ステップはモデルが決定するため、ルールのカタログから計画を書き換えるコードステップは不要になります。
- 順序付けおよびドメイン手順は、スキルへ移行します。
- ハードリミット(検証、承認ゲート)や、会話の途中で発生するその他の処理(メモリ参照など)は、ツールへ移行します。
- コードは引き続き、低コストでほぼ常に関連する情報(エンティティ解決ステップなど)の読み込みや、ループが呼び出すツール内の機械的な処理(ペイロードの構築、ストリームの解析、明確化のための質問の再開)に使用できます。
このシングルループの設計は、エージェントが学習したすべてを 1 つのコンテキストに保持するため、多くのチームが目指している最終状態(ユーザーの高レベルな目標を理解し、ユーザーに代わって行動するエージェント)の実現にも役立ちます。
以下の提案では、チームがマルチエージェントシステムから単一のエージェントループへ段階的に移行する方法と、その過程で複数のチームがエージェントに貢献し続ける方法を示します。
タスク完了評価
最初のステップは、サブエージェントをメインのエージェントループに組み込むべきかどうかを判断するのに役立つ評価用データセットを作成することです。これまでに効果が確認されている評価の構成は、中央チームが所有する共有のエンドツーエンドセットを 1 つ用意し、各スキルを所有するチームがそのスキルとともに小規模な評価セットを提供するというものです。 10 件のゴールデンサンプルさえあれば、始めるには十分です。
エージェントの最終メッセージをルーブリックに照らして採点することは、回答の質を追跡するための良い出発点です。 オーケストレーターを引き続き使用している間は、ルーティングの精度(適切なサブエージェントを選択したか)も追跡する必要があります。サブエージェントの統合後は、代わりにエージェントが適切なスキルを読み込んだか、適切なツールを呼び出したかを確認してください。 時間の経過とともにタスク完了の評価に取り組むことは、アーキテクチャを比較する際に最も重要となるため、有益です。
内部システムのリプレイが困難で、ユーザーエンゲージメントのシミュレーションが難しい環境では、これは複雑な作業になり得ます。 当社で効果を上げているアプローチの 1 つは、重要なイベントのタイムスタンプを記録し、後でリプレイして、ターゲットを絞った評価として実行できるようにすることです。
時間の経過に伴うサブエージェントの削減
単一エージェントループへ進化させるには、サブエージェントをツールやスキルとして統合する必要があります。これは、ドメインサブエージェントを統合する、ツールとして呼び出す、またはスキルやツールに置き換えることで実現できます。
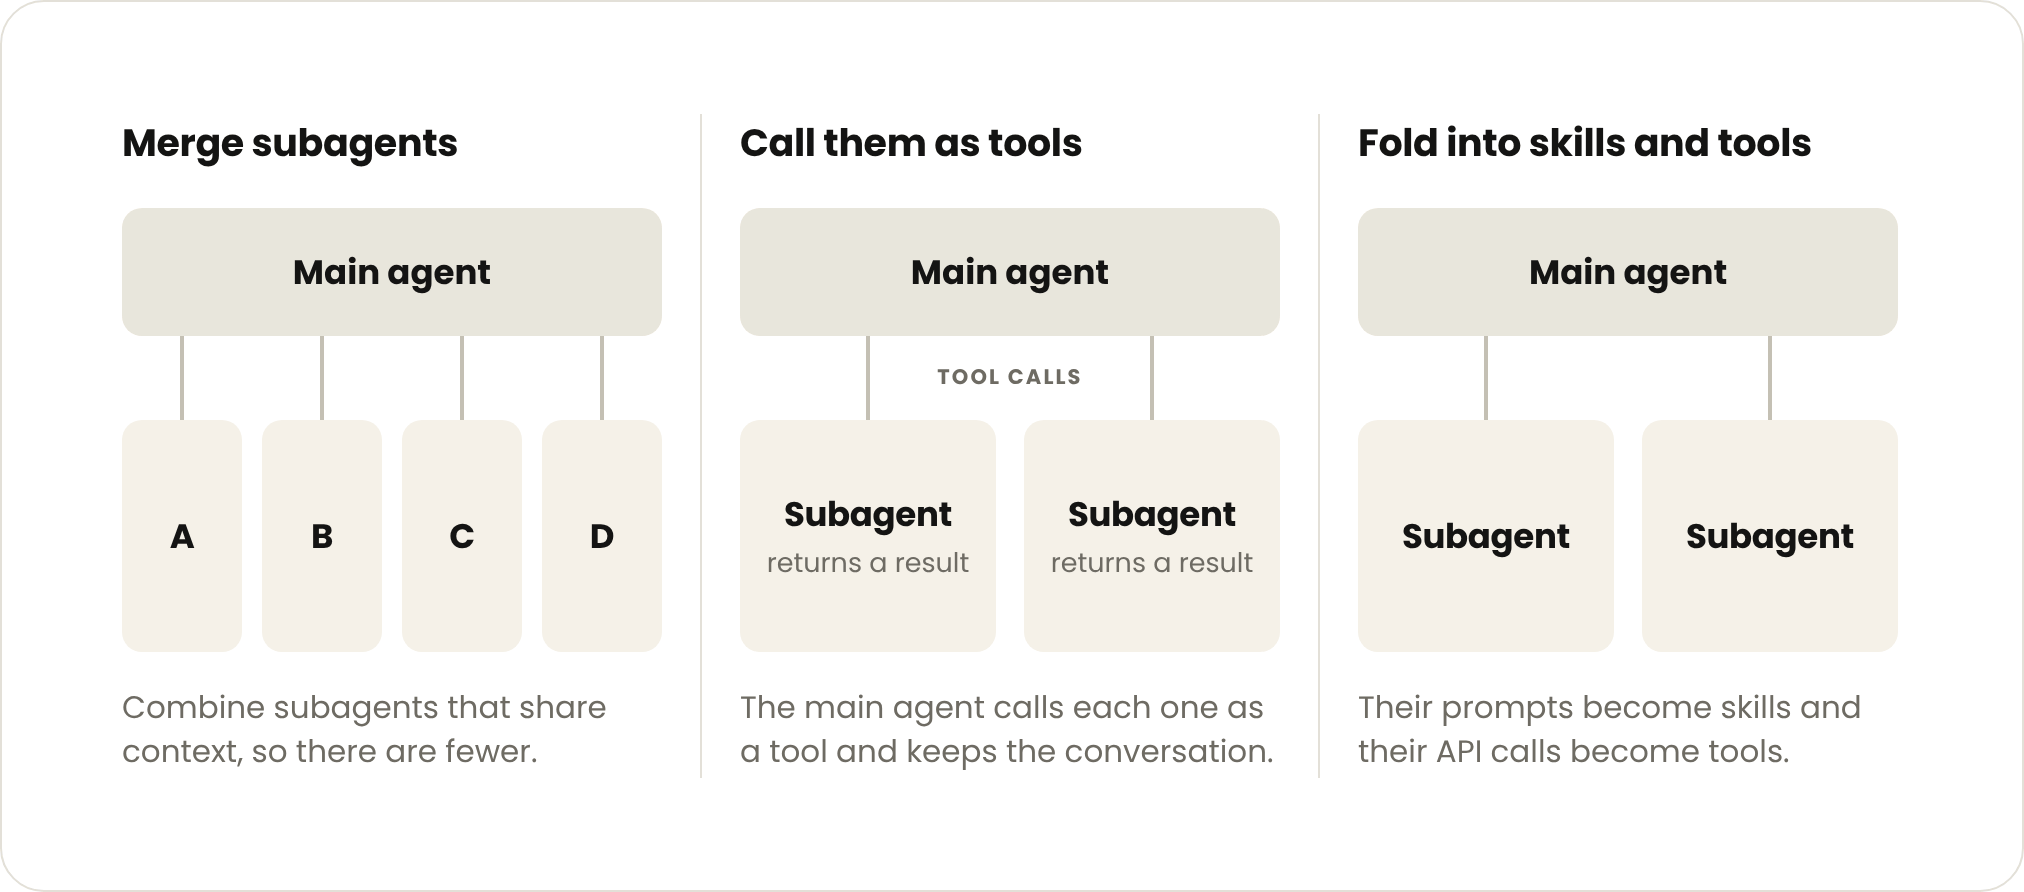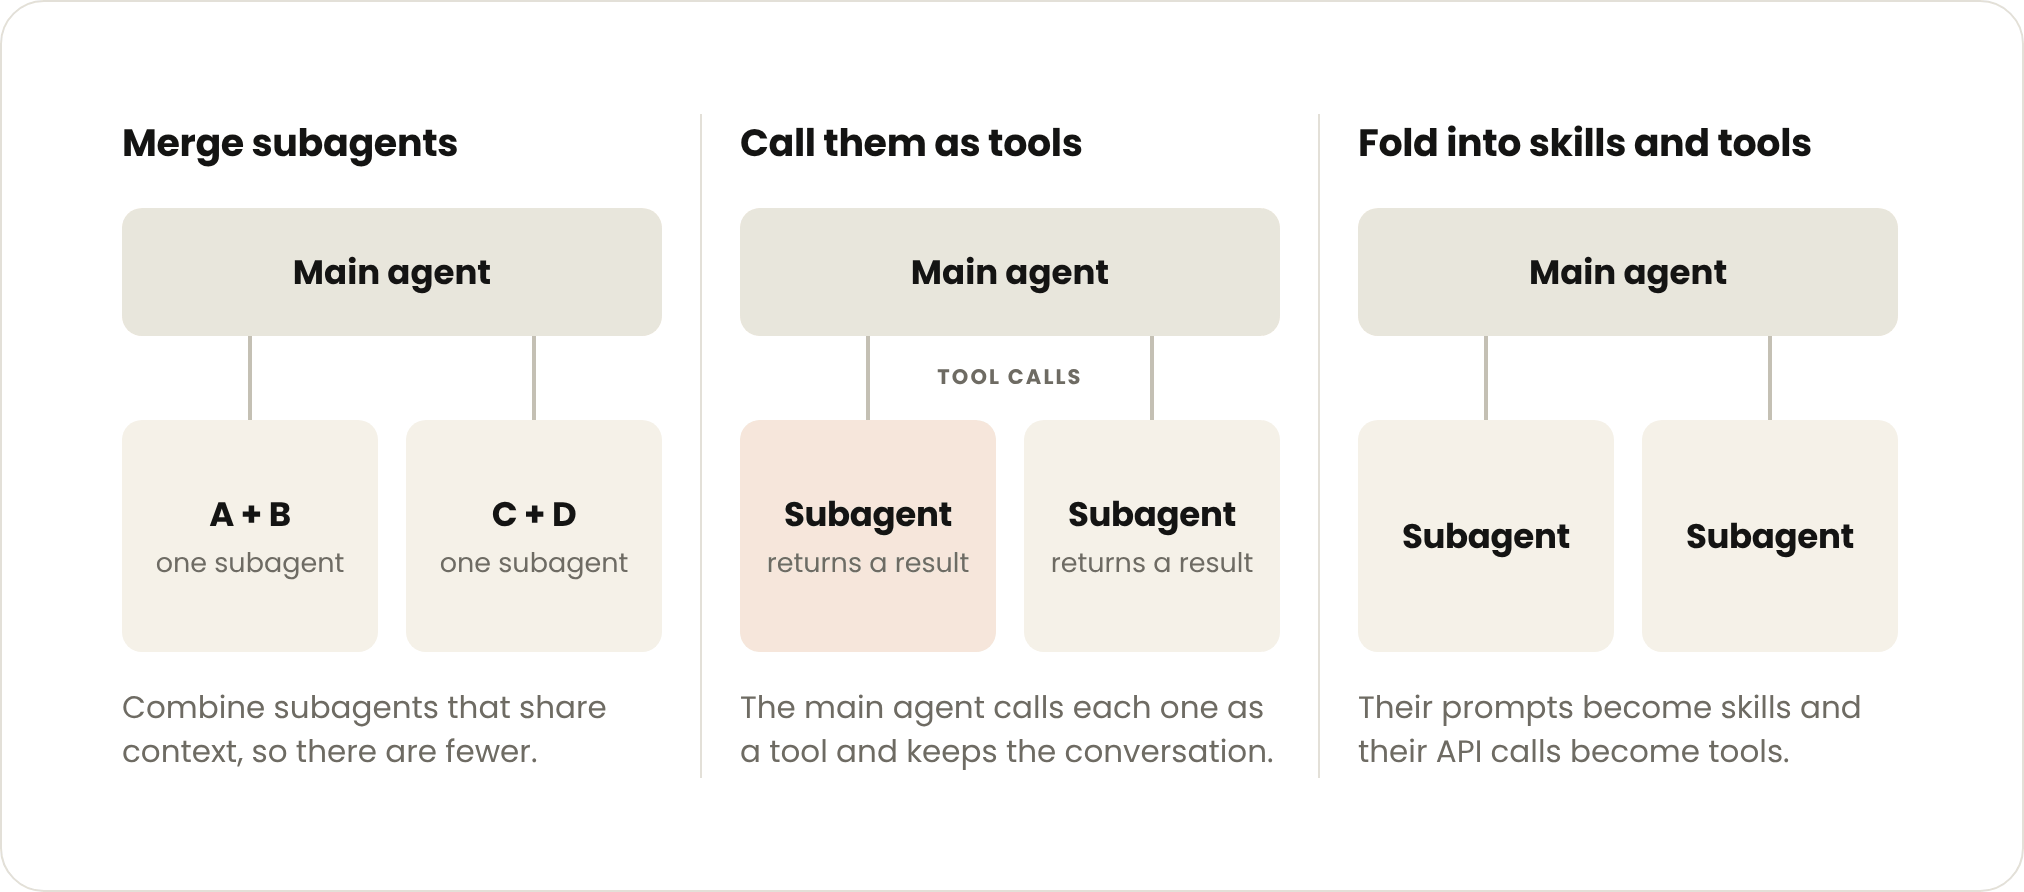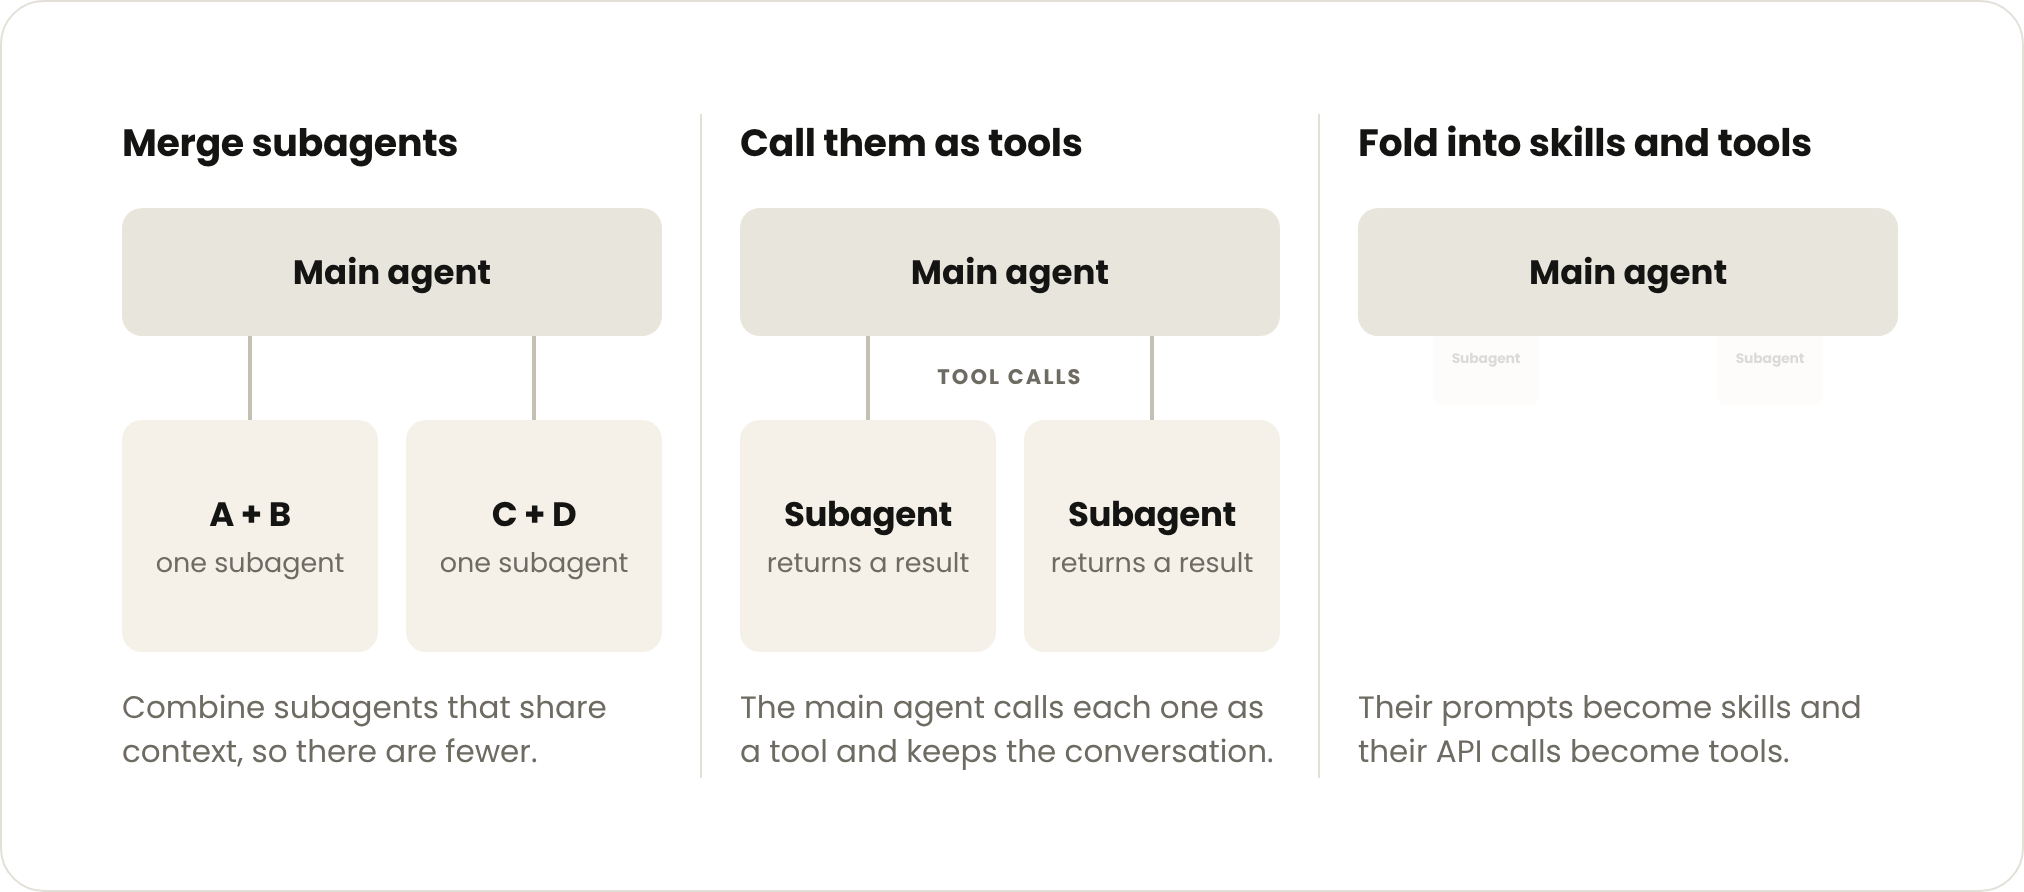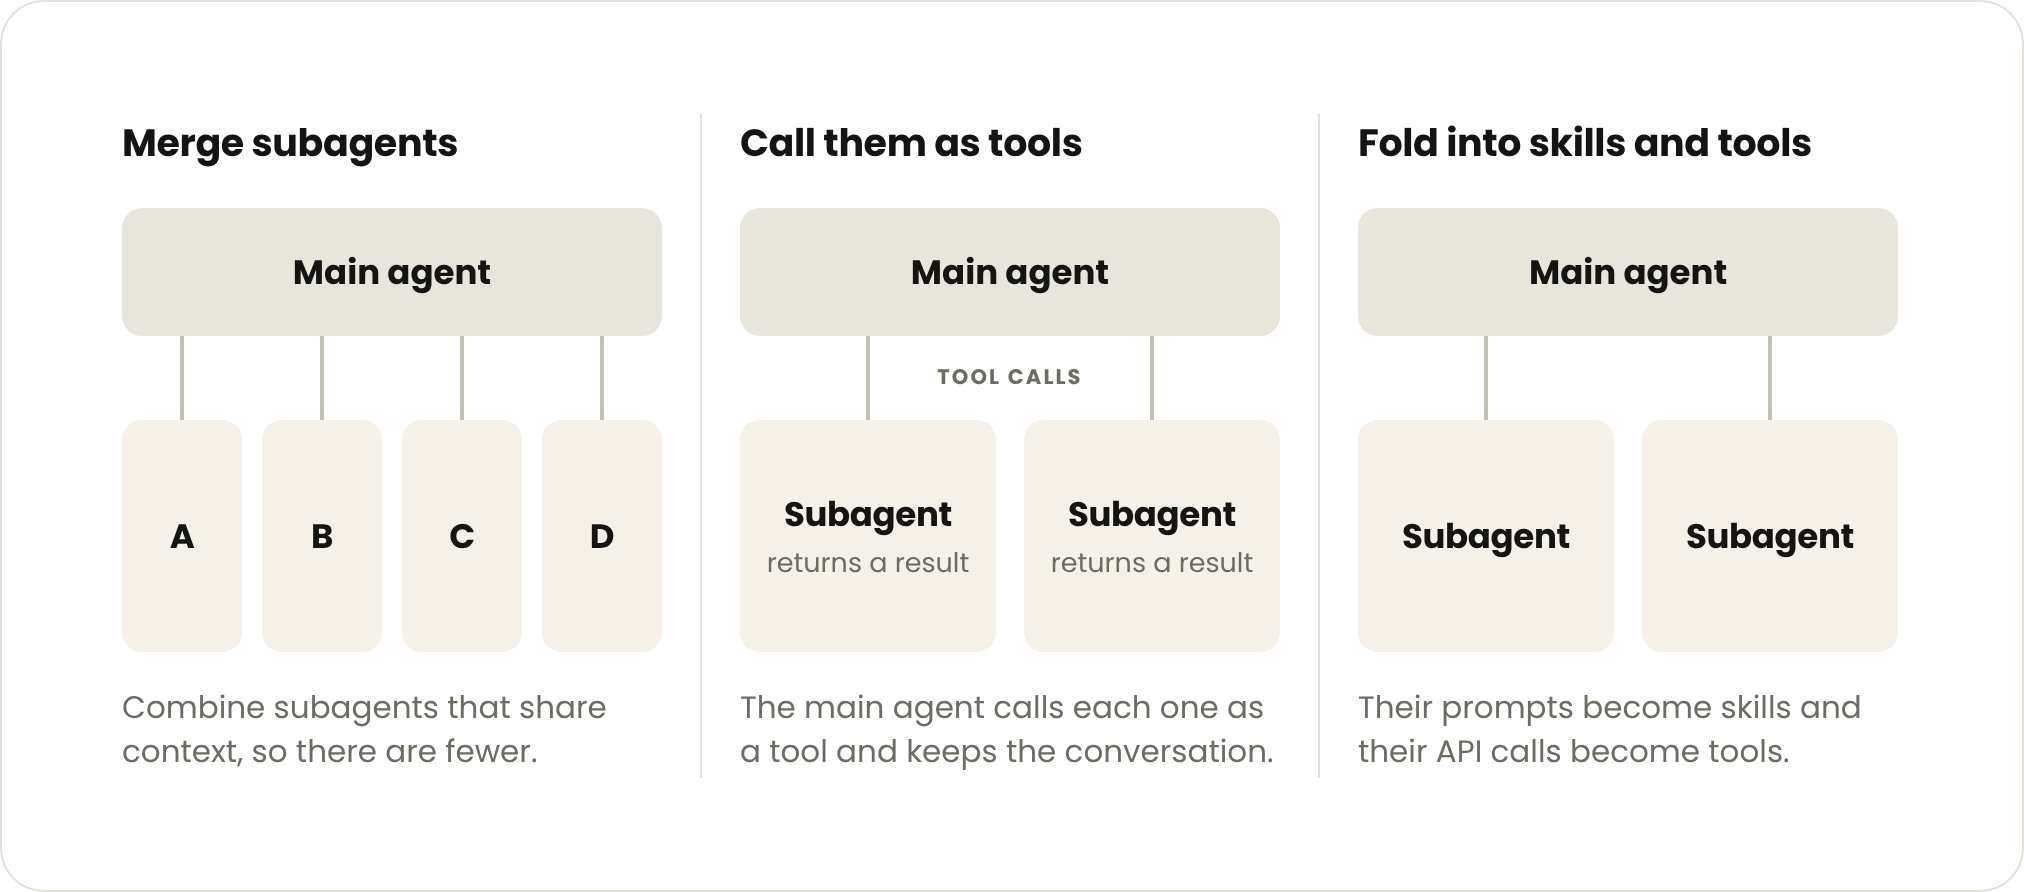
ドメインエージェントを組み合わせる
最初のマージ前に、小規模なエンドツーエンドの評価を作成します。 その後、最も使用頻度の高いサブエージェントから順に、共有コンテキストに基づいて統合します。
互いの出力を連鎖的に利用する、同じデータを扱う、または頻繁に一緒に呼び出される専門エージェントをマージします。 たとえば、本番トラフィックのかなりの割合で、ある専門エージェントの後に別の専門エージェントが続く場合、それは緊密に結合したペアであり、1 つのドメインエージェントに統合する候補になります。
ツールとして呼び出されるサブエージェント
上記の 3 つの条件のいずれかに該当し、サブエージェントを維持する場合は、メインエージェントがツールとしてサブエージェントを呼び出すようにすることが効果的な場合があります。これにより、メインエージェントはユーザーとの会話を継続できます。
サブエージェントが会話を引き継ぐ完全なハンドオフは、サブエージェントがユーザーと直接対話する必要がある場合に限ってお勧めします。 それ以外のものはすべて、メインループ内でスキルとツールを組み合わせたものにすることができます。
This will allow you to define a shared response schema for subagents, verify the conclusion against real data with the main agent, and trim the input to any final synthesis step. This is a good first step, as you don’t need to rewrite the subagents. It also gives you a baseline on the task-completion eval before deciding to fold any subagents into the main agent.
ただし、いくつかの故障モードは残ります:
- 各スペシャリストには、独自のプロンプト、コンテキスト、オーナーチーム、評価があります。
- 呼び出しのたびに、依然として情報が欠落した要約が返されます。
- すべての呼び出しは、レイテンシを増加させるネストされたモデルループです。
スキルやツールを通じてサブエージェントをメインエージェントに統合
各サブエージェントのプロンプトをスキルに、API 呼び出しを MCP ツールに変換して、サブエージェントを 1 つずつメインエージェントに統合します。サブエージェントがある場合とない場合の評価パフォーマンスを比較します。次に、どちらを残すかを決定します。
比較する際は、最終スコアだけでなく、どのタスクの結果が入れ替わったかも確認してください。サンプルのサポートエージェントでこれをテストしたところ、1 つのサブエージェントを別のサブエージェントに統合することでレイテンシは低下しましたが、それまで成功していたプロセスが機能しなくなりました。メインエージェントは、注文検索ツールを操作し、配送スペシャリストに配送日を尋ねることなく、単独で回答していました。
変更を加える前に、本番環境で一緒に実行されるエージェントの各チェーンと、エージェントが順守すべき各ルールに対応するタスクが評価に含まれていることを確認してください。また、今回のような問題は2回の実行のうち1回しか発生しなかったため、各タスクを複数回実行するようにしてください。
複数のチームが 1 つのエージェントに貢献する方法
ドメイン推論は、ナレッジベース、スキル、MCP ツールから取得できます。 個々のチームは責任の対象をエージェントからスキルやツールに移すことができ、1 つの小規模な中央チームがシステムプロンプトとエンドツーエンドの品質に対する責任を維持します。これには、新しいスキル、ツール、評価をリリース前に審査することが含まれます。
MCP ツール
ツールは、エージェントがアクションを実行する必要がある場合、システムからライブデータを読み取る場合、または結果を固定形式で返す必要がある場合に最適です。 また、移行中もサブエージェントを呼び出し続ける手段としてツールを使用することもできます。システムプロンプト内のツール定義が 30~50 個を超えるとツール選択の精度が低下しやすいため、(API ごとに 1 つのツールではなく)ユーザーの意図別にグループ化したツールをお勧めします。
遅延読み込みを伴うツール検索を使用し、厳格な前提条件を制限した上で、必要な前提条件はツール内に移動してください。たとえば、Y が X の出力を必要とする場合、Y のツールがそれを確認し、モデルが対応できる指示を返します。ユーザーごとの権限も同じように機能します。 各ツールは、呼び出し側のユーザーが閲覧できる内容や実行できる内容を確認し、モデルが読み取れるシンプルな拒否結果を返すため、権限レベルごとに別のエージェントを用意しなくても、1 つのループで異なるアクセス権を持つユーザーに対応できます。
Skills
以前は専門サブエージェントのプロンプトが保持していた手順、ルール、判断基準など、チームの業務の進め方をエージェントが把握する必要がある場合は、Skills が最適です。
スキルライブラリを拡充するための当社のアプローチは、メンテナンス作業をスキル作成者に任せることです。Claude は、他のスキルを構築、テスト、整理できるスキルを使って、手間のかかる作業をこなせます。
スキルの乱立を防ぐため、チームごとの担当責任者(DRI)が各チームのスキルを管理し、それらが適切に作成され、明確に区別され、適切な評価とともにリリースされるようにすることができます。
- /skill-creator を使用すると、最初から適切な構成の新しいスキルを作成できるほか、既存のスキルを監査して削減、重複排除、再構成することもできます。
- /skill-doctor では、ライブラリ内の各スキルのコストと実際の使用頻度を確認でき、不要なスキルを削除できます。
ナレッジベース
ナレッジベースは、エージェントが時々しか必要としない参考資料に最適です。 事実や参照資料(ポリシー、指標の定義、製品仕様)は、モデルが呼び出す検索ツールやルックアップツールの背後に配置することも、スキル内の参照ファイルとして提供することもできます。 コードでこのコンテキストを取得し、プロンプトに貼り付ける方法は避けてください。
この作業を加速するツール
当社は最近、上記の作業のほとんどに役立つ Claude API スキルセットをリリースしました。当社の移行キットは、これらのスキルを1つのガイド付きワークフローにまとめ、マルチエージェントシステムを評価し単一のエージェントループに移行できるようにします。実際の環境で実行する前に試せるデモが含まれています。
- /claude-api build-eval:中央チームが管理する最初のエンドツーエンドの評価セットや、各チームがスキルとともに提供する小規模な評価を作成するのに役立ちます
- /claude-api prompt-audit:プロンプト、スキル、ツールの説明内で、以前のモデル向けに書かれた指示にフラグを立て、修正内容を差分として提案できます。これは、システムプロンプトに対して実行することができ、以前のモデル用に追加されたルールのうち、エージェントの動作を遅くしたり柔軟性を損なったりしているものを特定できます。各チームの DRI も、自チームのスキルやツールの説明を対象にこれを実行できます。
- /claude-api hillclimb:既存の評価を基準に、アプリを繰り返し改善できます。 これは、システムプロンプトだけでなく、「統合した場合と維持した場合」の比較(1 つのサブエージェントをスキルとツールに統合した後、スキルとツールの説明を繰り返し改善させ、統合版がサブエージェントと同等以上の結果を出せるかを確認する)にも利用できます。
- /claude-api cost-optimize:呼び出し先をプロファイリングし、プロンプトキャッシュ、不要な入出力トークンの削減、エフォート、モデルの選択などのオプションによるコスト削減策を、一度に 1 つずつ提案します。 これにより、特定の設計におけるコストとレイテンシを削減できます。
モデルが進化するにつれて、モデルを最適に活用する方法についての理解と、ベストプラクティスに関するガイダンスも進化します。 そのため、特定のアーキテクチャよりも、その背後にある原則の方が重要になります:それは、測定を行い、一度に1つずつ変更を加え、効果が実証されたものを維持するということです。
これはそのケースの一つです。モデルの能力が向上し、エージェントの稼働時間が長くなるにつれて、より多くのサブエージェントをスキルやツールとして活用できるようになります。ただし、その移行を一度に完了する必要はありません。 小規模なエンドツーエンドの評価を作成し、1 つのサブエージェントを統合します。統合版のスコアが悪化した場合に限ってサブエージェントを維持し、このプロセスを繰り返します。