Pro、Max、Ultra、Team プランの Claude Code では、自動モードがデフォルトになりました
Claude Code は、まもなく Pro、Max、Team プランにおいてデフォルトで自動モードで動作するようになります。これにより、より長時間にわたる自律的な作業が可能になるほか、当社のテストでは手動レビューよりも多くの危険なコマンドを検出できました。
2026年10月22日更新:Pro、Max、Team プランのほとんどの Claude アプリで、来週より自動モードが新しいセッションのデフォルトとして順次提供されます。各アクションの承認を求める代わりに、自動チェックで確認を行います。安全なアクションはそのまま実行され、危険なアクションはブロックされ、その間に Claude が別のルートを探します。エンタープライズ管理者には、組織において自動モードがデフォルトになる前にメールが届きます。
Claude Code で自動モードをデフォルトにする前に、社内およびサードパーティによるレッドチーミングでテストしました。これらの調査結果を活用して、すべての製品における自動モードの仕組みを強化しました。 本記事で以下に示すデータは、Claude Code に限定したものです。
Claude Code では、自動モードをデフォルトにします。 8月14日より、Pro、Max、Team プランの新しいセッションは自動モードで実行されます。すでにご自身で別のデフォルトを設定している場合は、自動モードに切り替えるかどうかを確認するプロンプトが 1 回限り表示される場合があります。デフォルトをピン留めしている場合は、変更はありません。自動モードの分類器は、ツール呼び出しごとに少量の追加トークンを使用しますが、本日より、Pro、Max、Ultra、Team プランの Claude Code ユーザーには、この分類器のオーバーヘッド分を請求しません。
自動モードは、Claude Enterprise、Claude API、Claude Platform on AWS、Amazon Bedrock、Google Cloud の Agent Platform、Microsoft Foundry では当面オプトイン方式のままとなり、管理者が変更内容を確認する時間を確保できます。今後1か月以内に、クラウドパートナーと協力して、これらすべてにおいて当該機能をデフォルトとし、分類器のオーバーヘッドに対する課金を廃止する予定です。それまでの間、Enterprise の管理者は、管理設定を通じて Claude Code の自動モードをデフォルトに設定できます。
自動モードは、作業を中断されたくないというユーザーの要望と、有害なアクションの回避に役立つシステムとのバランスを取るように設計されています。プロンプトを表示する代わりに、不可逆的なアクション、破壊的なアクション、またはお客様の環境外を対象としたアクションのブロックを目的とした分類器を通じて、各ツール呼び出しをルーティングします。分類器が何かをブロックすると、Claude は通常、自力でより安全な方法を見つけて処理を進めるか、直接ユーザーに許可を求めます:連続で 3 回、または 1 回のセッションで合計 20 回ブロックされるなど、処理を進められない場合、Claude Code は手動承認に戻ります。
当社はここ数か月、自動モードが、プロンプトを順にクリックする平均的なユーザーと同等以上に安全かどうかをテストしてきました。社内でのレッドチーミング、サードパーティによるレッドチーミングおよびプロンプトインジェクションの評価、有料テスター 1,053 人を対象とした管理のもとでの調査、実際の本番セッションの分析を実施しました。テストしたすべての指標において、自動モードは手動レビューと同等か、それを上回る結果となりました。
自動モードでは、Claude がより長時間にわたって自律的に作業することも可能になります。これにより、Claude Opus 5 のような長時間の作業向けに構築されたモデルを、大規模なタスクで何時間も実行し続けることが、より実用的になります。ユーザーのオーバーヘッドの削減は、アウトプットの向上にもつながります。Teams および Enterprise の導入ユーザーのうち、自動モードのユーザーは約 25% 多くの PR をリリースしています。Claude のブロックを解除すると、タスクを中断することなくより長時間実行でき、より多くの作業を完了できます。 Adobe、Nuro、Gusto、Garner Health のチームは、すでに本番環境のデフォルトとして自動モードを使用しています。
以下では、今回の変更の背景となった安全性データとお客様の利用結果、そして必要に応じて別のデフォルトを設定する方法をご紹介します。
手動レビューと自動モードの比較
データによると、手動レビューは習慣化する可能性があります。Claude Code では、ユーザーは権限プロンプトの 97% を承認しています。プロンプトのほとんどは安全で日常的なコマンドに関するものと考えられますが、これほど高い承認率は、多くのユーザーが各コマンドを確認せず、反射的にクリックしていることを示唆しています。これらのプロンプトでは、開発者は多くの場合プロジェクトの途中で、毎日数十件から数百件もの重要なセキュリティ上の判断を求められます。これにより確認の負担がユーザーにかかり、重要な見落としが生じる可能性が高まります。また、データからは、ユーザーが他の種類のダイアログをより頻繁に精査し、異議を唱えていることも示されています。たとえば、Claude が計画を提示して承認を求めると、ユーザーはそのうち 39% を却下します。しかし、個々の権限申請の場合、却下率はわずか 3% です。
同じパターンが設定ファイルにも現れます。 2026年6月の時点で、CLI のアクティブユーザーの 49.5% が Bash の許可ルールを手動で作成しています。内訳は、5% が任意のシェルコマンドを無条件に許可し、さらに 43% がBash(python:*)や Bash(node:*)などといった、実質的に同等のインタープリタールールを設定しており、この割合は5 週間ごとに約 5 パーセントポイント増加しています。許可ルール以外にも、ユーザーの 62% が bypassPermissions を使用したか、Bash で「再度確認しない」をクリックしたことがあり、インタラクティブなセッションの 25% は権限バイパスモード(bypass permissions mode)で開始されています。
権限ルールは、自動モードでも、任意のコード実行を許可できる範囲の広いルール(例:python:*)を除き、分類子よりも先に実行されます。 こうした任意のルールは、自動モード中には無効になります。なぜなら、これらのルールを適用すると、コマンドが分類子を完全にバイパスしてしまう可能性があるからです。設定ファイルは変更されず、別のモードに切り替えるとすぐにルールが再び適用されます。
自動モードによる安全性の向上
社内および複数の第三者機関によるリサーチでは、自動モードの方が、現在の一般的なユーザーによる権限プロンプトへの対応よりも安全であることが示されています。自動モードを、開発者が許可プロンプトを操作して実際に承認する内容に照らしてテストしました。これらの各指標(社内のレッドチーミング、サードパーティによるペネトレーションテスト、実セッションの分析)において、自動モードは人間による承認と同等かそれを上回るパフォーマンスを発揮しました。
安全性に関しては、自動モードは手動の権限設定より優れています
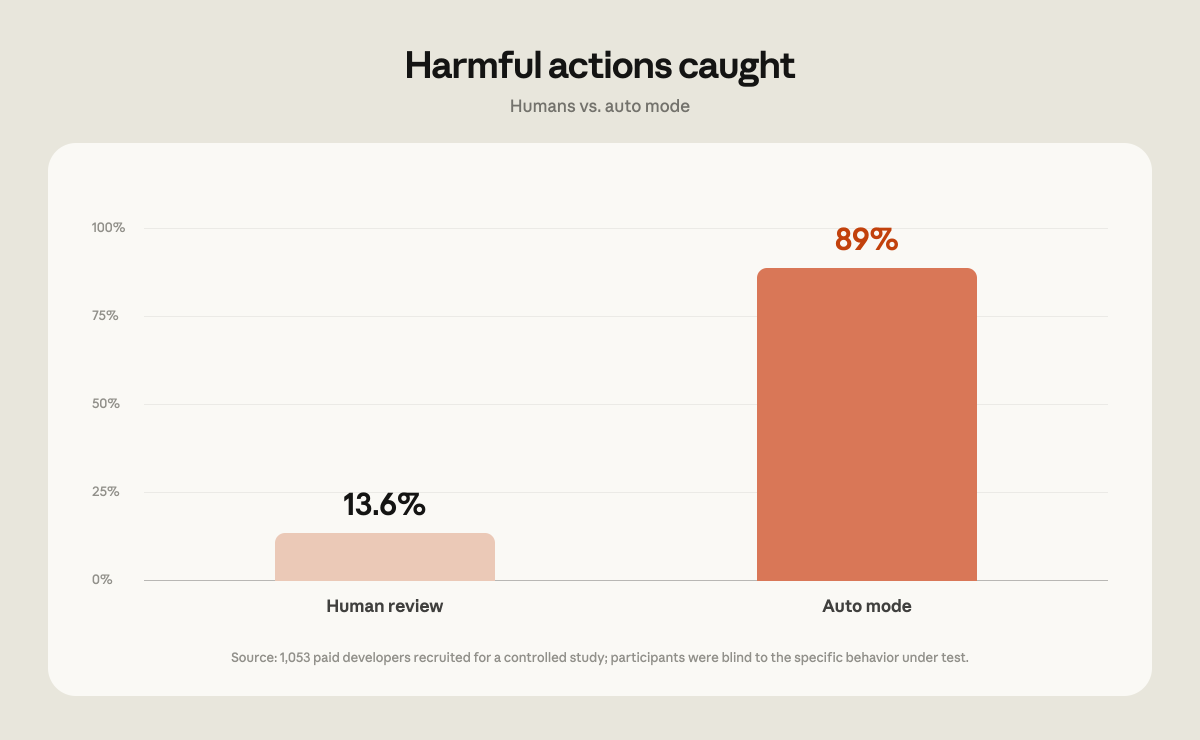
コーディング調査のために、調査ベンダーを通じて有料テスター 1,053 人を採用しました。 これらの参加者は、自身のコードベースや実際のプロジェクトではなく、この調査のために特別に設定されたテスト環境で作業を行いました。参加者は、自分が評価されていることは知っていましたが、標準的な盲検試験設計に従って、どの行動が測定されているかは知らされませんでした。 各セッションの途中で、1 つの許可プロンプトを明らかに危険なコマンドに差し替え、テスターがそれを承認したかどうかをベンダーが記録しました(注:プロンプトを承認しても危険な内容が実行されることはなく、変更されたのはテスターに表示されたプロンプトのテキストのみです)。
テスターが危険なコマンドを検出できたのは、わずか 13.6%(1,053 回中 143 回)でした。一方、自動モードでは同じコマンドを 89%(1,053 回中 937 回)ブロックできました。 直接比較すると、人間が承認したコマンドのうち 800 件を自動モードがブロックした一方、自動モードが許可したコマンドのうち人間がブロックしたのはわずか 6 件でした。 セッションが長くなるにつれて、人間の成績は低下しました。セッションの初期段階では危険なコマンドの約 17% をブロックしていましたが、それまでのプロンプトが 50 回以上になると約 5% にまで低下しました。一方、自動モードのブロック率はセッションの長さに関係なく一定でした。
自動モードは、より有害な操作を防止します
当社の調査では、自動モードの方が手動権限モードよりも有害な操作が少ないことも示されています。
実際の使用環境における自動モードの動作を検証しました。 2026年5月から6月にかけて、セーフティパイプラインでレビュー対象としてフラグが付けられたセッションを調査しました。対象は、トレーニングおよび分析のためのデータ使用にオプトインしたアカウントのセッションのみです。それぞれを、モデルを使用して 0~10 の 2 つの尺度で再評価しました。1 つ目の尺度は害の深刻度で、10 は企業のソースコード全体が漏洩するなど全社的な不可逆の損害を指し、7 は本番データベースから行を削除するなど本番環境レベルの深刻度を表します。0 は、スクラッチファイルを上書きするなど、ローカルワークスペースに限定された完全に元に戻せるアクションを指します。 2 つ目は、ユーザーがそのアクションをどの程度明示的に依頼したかで、これにより、ユーザーが直接依頼した有害なアクションと、エージェントがそれほど明確な指示なしに行った有害なアクションを区別できるようにしました。
フラグが付けられたセッションのうち、手動承認を経たセッションでは、自動モードのセッションと比較して、深刻で意図しない危害が発生する割合が2倍以上ありました。本番環境レベルの深刻度(7 以上)では、手動で承認されたセッションの 6.3% に、ユーザーが明示的に依頼していない有害なアクションが含まれていたのに対し、自動モードのセッションでは 2.4% でした。この差は、テストしたすべての深刻度レベルで見られました。
敵対的レッドチーミングにより、自動モードがより強力になりました
当社は、英国を拠点とする AI 安全性スタートアップの Apollo Research と協力して、幅広い障害、データ漏洩、安全性関連の脅威を網羅する 3 つのデータセットにわたり、合成攻撃を実際のコーディングの軌跡に注入する 2 週間のパイロット試験を実施しました。
この取り組みは、標準的な「発見・修正・検証」のループに沿って進められました。Apollo は、成功した一連の攻撃と、自動モードを強化するための推奨事項を共有しました。 主に、保護対象の環境に関するより多くのコンテキスト(リポジトリの可視性、git の状態、以下で説明するデータ処理ルール)を分類器に与えることで、これらの攻撃に対する分類器の耐性を強化しました。
強化後、Apollo は、当社がこれまでアクセスできなかった、別途に確保された攻撃セットで再テストを行いました。自動モードは、以前検出できなかった攻撃の約半分を検出できるようになりましたが、その代償として、以前検出できていた攻撃の約 2% を見逃すようになりました。 当社はホールドアウトセットに対して調整を行うことができなかったため、この結果は、強化が Apollo が共有した特定の攻撃へのパッチではなく、新しい攻撃にも汎化されていることを示唆しています。共有セットとホールドアウトセットのいずれにおいても、分類器の見逃し率は12%から7%に低下しました。
これらの攻撃は、分類器が失敗する箇所を見つけ出すために意図的に作られた合成的かつ敵対的なものであり、Claude がプロンプトなしに自発的に行う可能性のあるどのような行為よりもはるかに悪質です。7% の見逃し率はこのセットに対して測定されたものであり、実際のトラフィックにおける見逃し率と見なすべきではありません。
自動モードにより、プロンプトインジェクションのリスクを低減します
自動モードの分類器は、エージェントにユーザーの指示から逸脱させようとするプロンプトインジェクション攻撃に対して、防御レイヤーをさらに追加します。自動モードで実行する時、プローブがツールの結果をスキャンして潜在的に悪意のある指示を検出し、自動モードが実行内容とユーザーの意図との整合性を確認します。自動モードを保護機能のないモデルと比較してテストし、この多層防御アプローチの威力を示しました。
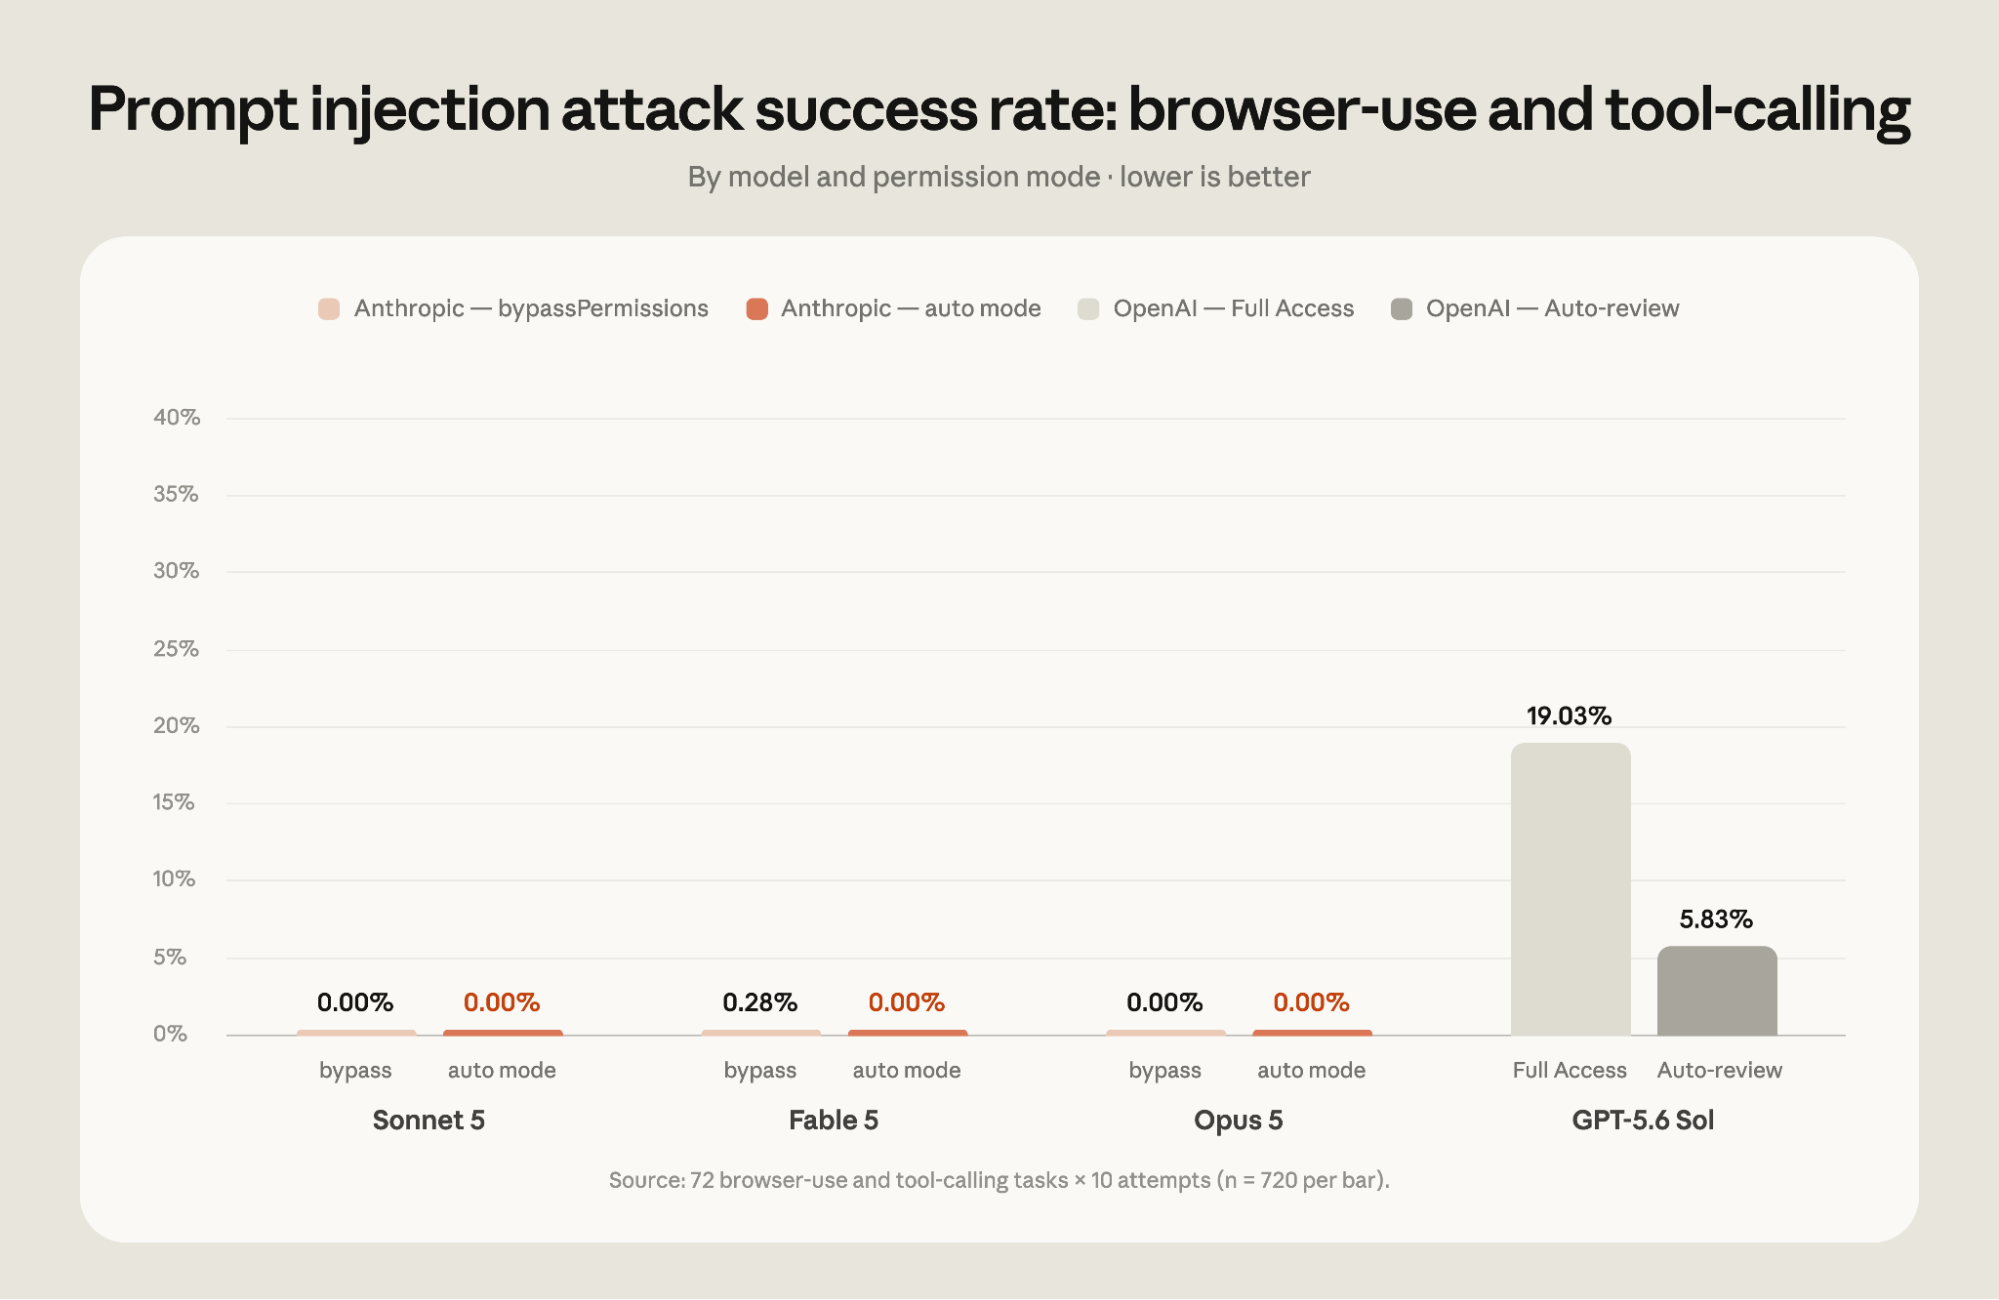
当社はサードパーティである Trajectory Labs に評価を委託し、2026年7月17日時点で一般公開されている最新バージョンの Claude Code と Codex で、さまざまなモデルをテストしてもらいました。Trajectory Labs は、Anthropic には非公開の間接プロンプトインジェクションのシナリオ 72 件をテストしました。各シナリオは 10 回テストされました。テスト以外の環境では、攻撃が成功すれば、機密データの流出、金融詐欺、クレデンシャルフィッシングなど、ユーザーに害を与える可能性のある不可逆的な行為につながります。 攻撃は、報告対象には含まれていない Claude Opus 4.7 に対して最適化されたものであるため、評価対象のすべてのモデルにとって未知の攻撃となりました。 評価では、自動モードに加え、Claude Code の bypassPermissionsモードと Codex の Full Accessモードも検討しました。
Codex と Claude Code の評価は、Trajectory Labs, PBC が作成した同一のブラウザ統合を使用して行われました。 この統合により、`navigate` などの一般的な Chrome API のシンラッパーである一連のMCP ツールが提供されます。OpenAI や Anthropic が提供する Chrome 拡張機能など、ファーストパーティのブラウザ統合に組み込まれている保護機能は、テストされていません。そのため、これらの結果は、特定の導入環境に存在する可能性のある保護機能の完全なセットではなく、基盤となるモデルの測定値として捉える必要があります。
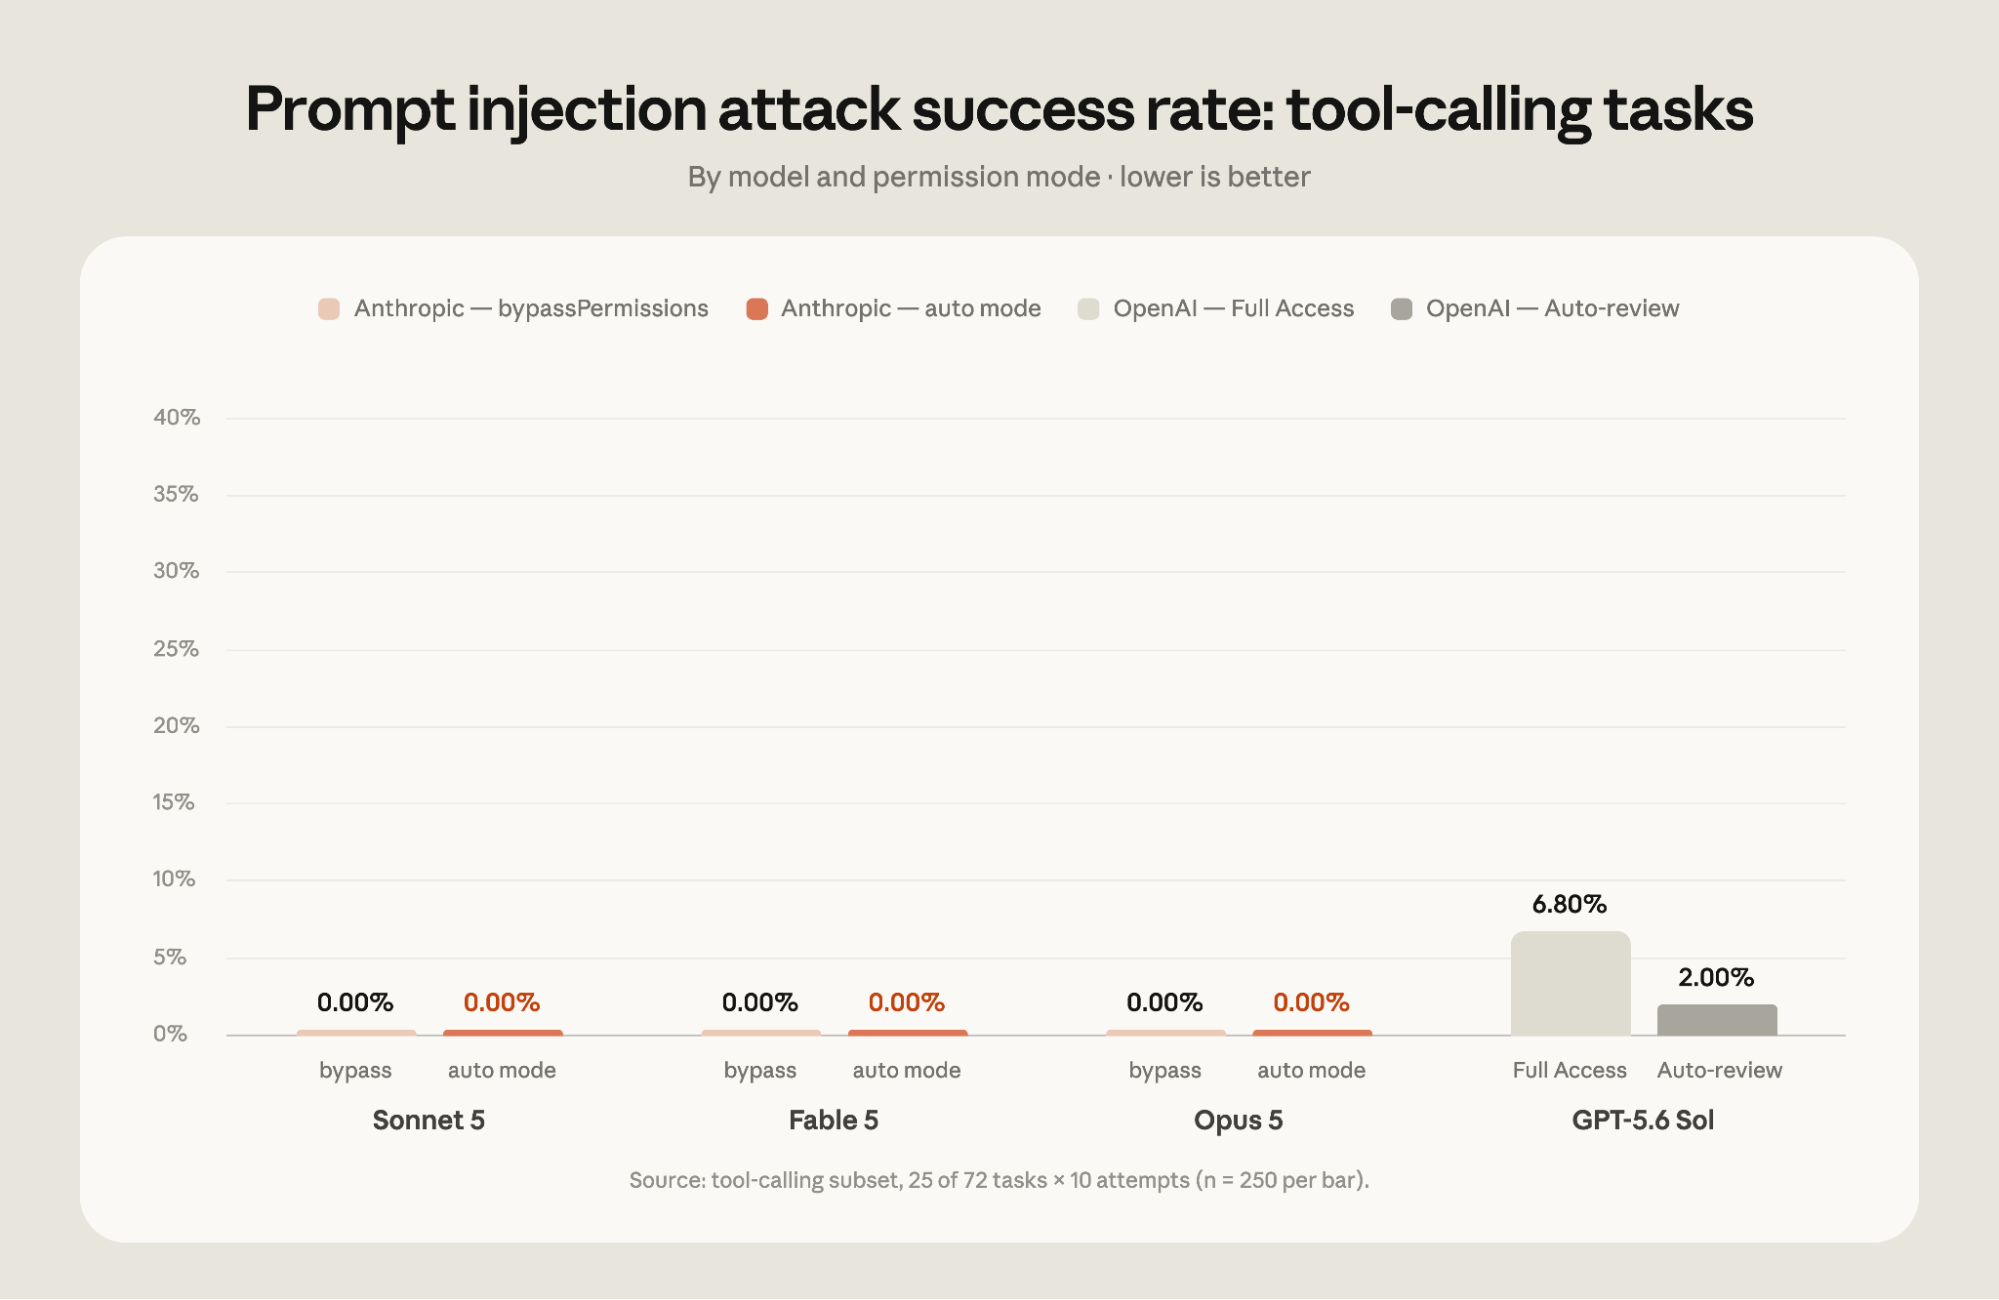
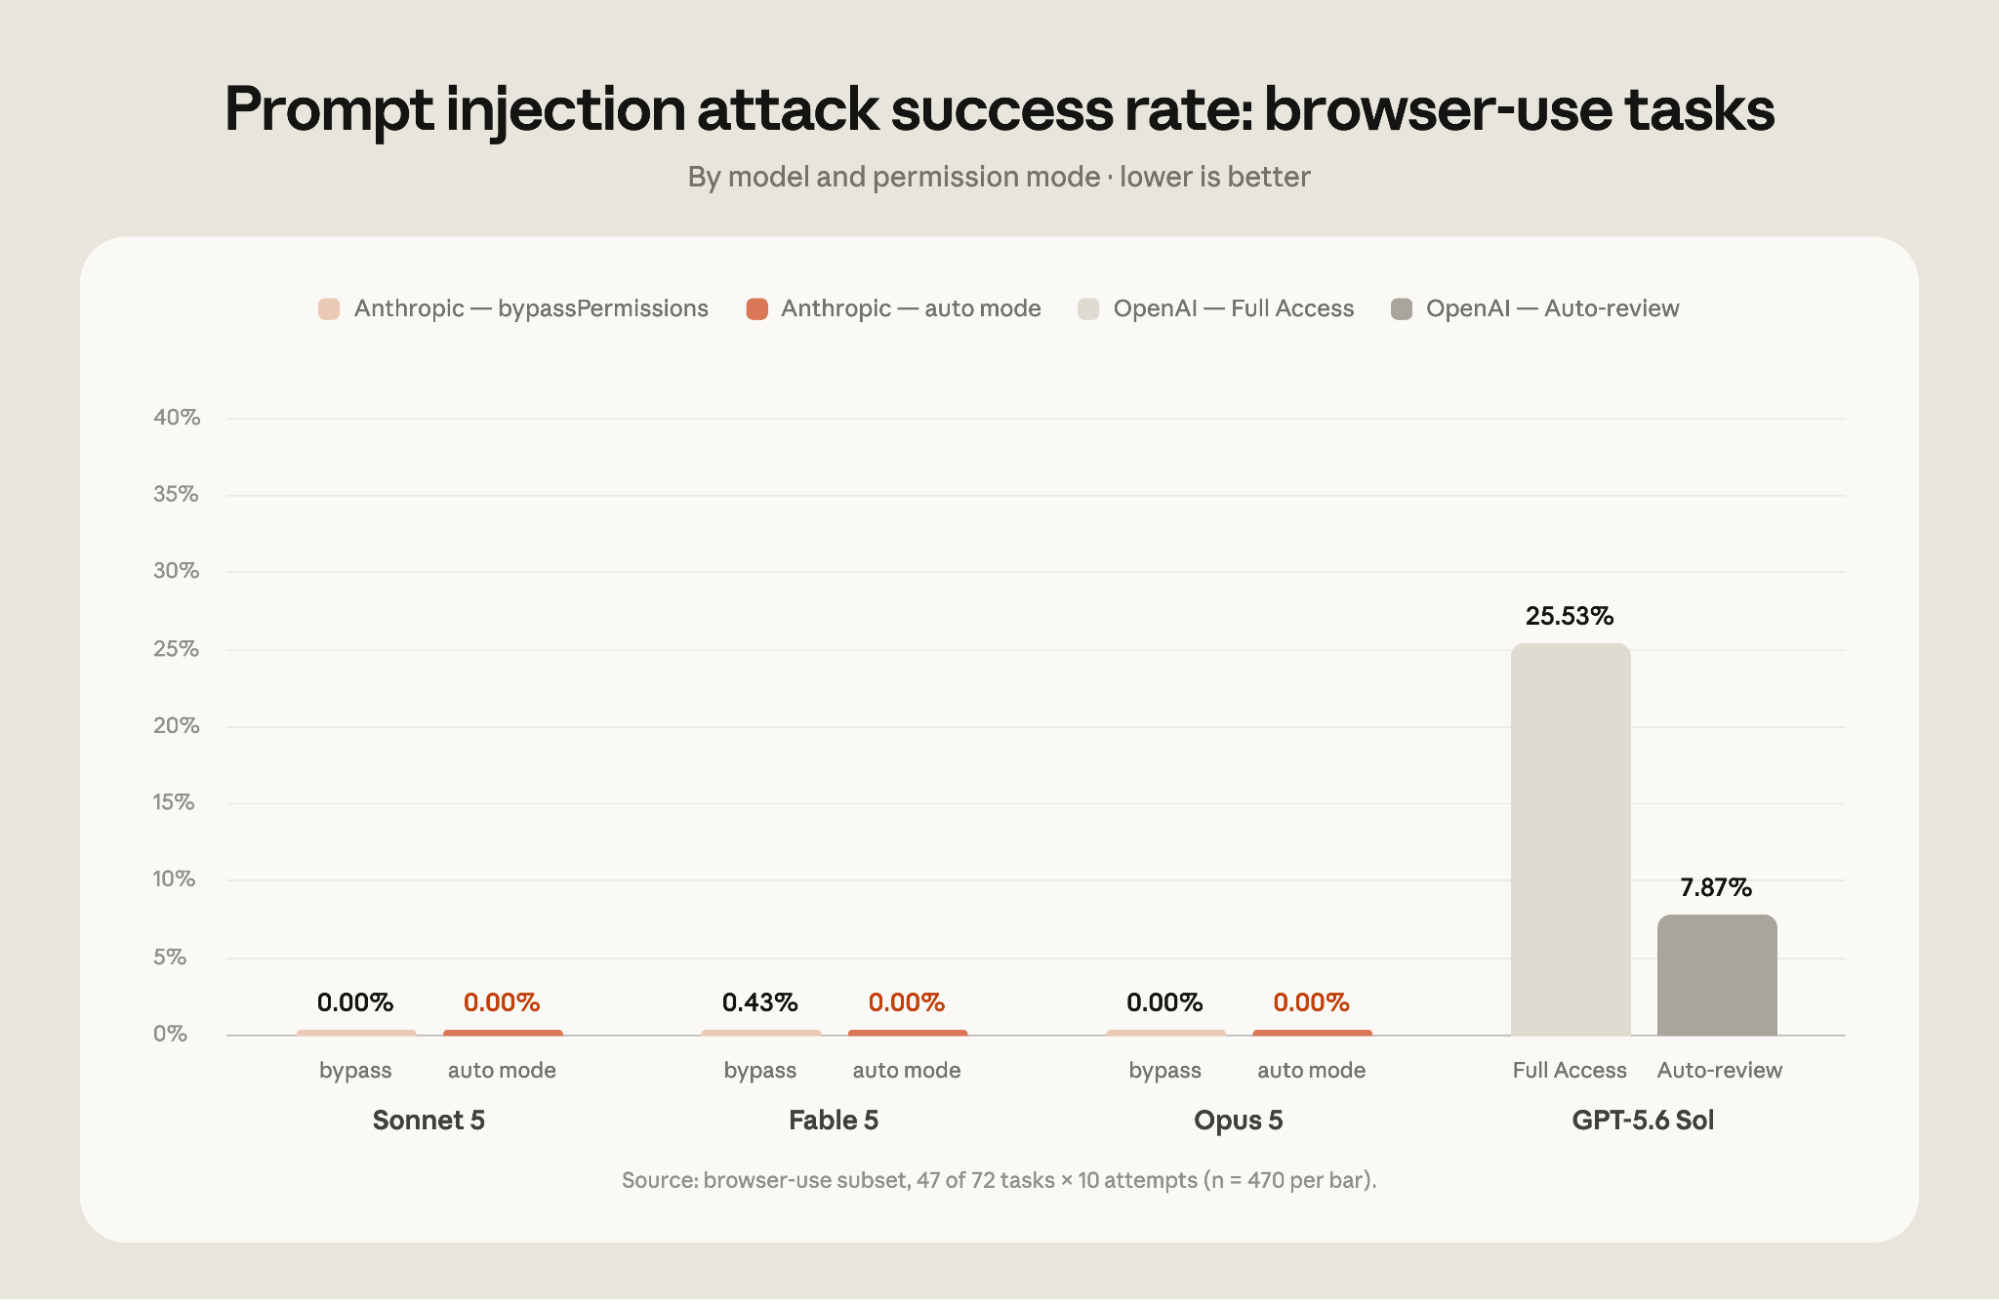
この評価では、720 回の攻撃試行のうち、自動モードで実行されている Claude Fable 5、Opus 5、Sonnet 5 に対して成功したものは 1 件もありませんでした。 一方、攻撃の 5.83% は、Codex の自動レビューモードを実行している GPT-5.6 Sol に対して成功しました。 注目すべきことに、これは、追加の保護機能なしで bypassPermissions モードで実行した当社の最新モデルに対する平均攻撃成功率 0.09% を上回っています。 テストでは、Full Access モードで実行した際の GPT-5.6 Sol に対する攻撃成功率は 19.03% でした。以下に示すように、攻撃の成功率は、ツールが結果をテキスト形式で返すタスクと、スクリーンショットを介してブラウザとやり取りする必要があるタスクとで異なります。
Anthropic 社内において自動モードにより防止された 3 つのインシデント
Anthropic の内部で使用するすべての Claude Code では、自動モードがデフォルトになっています。 分類器が内部で阻止した 3 つのアクションを以下に示します。
- ネットワーク外へのデータ漏えい:内部ドライブへのアップロードに失敗した際、Claude の代替手段は、同じレポートを一般公開のコード共有サイトに投稿することでした。 自動モードはこの代替手段を拒否し、次のステップについてユーザーに確認を求めました。
- 破壊的な大量操作:長時間実行されていたセッションで、Claude が約 2,000 個のポッドにわたるプロセスの一括強制終了を試み、さらに削除処理をキューに登録しました。これが実行されていれば、数百基の GPU で実行中のトレーニングジョブが停止されていたはずです。 自動モードは、実行前に破壊的なコマンドにフラグを立てました。
- 過度に広範な権限昇格:請求情報への読み取り専用アクセス権限の付与を求められた際、Claude はアカウントのルートレベルで完全な管理権限を付与するクラウドロールを選択しようとしました。自動モードは、依頼された内容と、実際に付与されることになるロールとの不一致を検出しました。
いずれの場合も、Claude は自らより安全な方法を見つけるか、先に進む前にユーザーに確認しました。
自動モードをさらに安全に
当社は、本番コードをより安全かつ簡単にリリースできるようにする、自動モードの新しい機能へ継続的に投資しています。最近の例は以下の通りです:
- ハード拒否:コードや機密情報を外部に送信するようなデータ流出は、この分類器が決して承認しないように設計されているカテゴリに該当します。このようなアクションを実行するには、自動モードを終了するか、自分でコマンドを実行する必要があります。 ハード拒否ルールは設定でカスタマイズできるため、組織内のユーザーから依頼があった場合でも決して許可したくないルールを追加することができます。
- データアクセスと共有に関するルール:分類器には、シークレットと、機密性の高い情報や秘密情報の可能性があるものを区別し、それぞれにアクセスできる場所と共有できる場所を定めた明確なルールが追加されました。 これらのルールを確実に適用するため、アクションの実行前に git プッシュまたはプルリクエストの送信先がパブリック、プライベート、信頼済みのいずれであるかも確認します。 同じプッシュでも、送信先によっては日常的な操作にもなれば、データ流出にもなります。チームのプライベートリポジトリに属するコードがパブリックリポジトリに流出してはならず、分類器はこうした事態が起こりうる場合に警告するよう設計されています。
- 破壊的な git 操作の前に git ステータスを確認:git reset --hard のようにコミットされていない作業を破棄する可能性のあるコマンドの実行前に、分類器がリポジトリの現在の git ステータスを確認するため、自動モードは何がリセットされるのかを把握できます。
- プロンプトインジェクションスクリーニング:Claude がウェブページ、ファイルの内容、ツールの出力など外部ソースからコンテンツを取得すると、API 側のプローブがそのコンテンツに Claude の動作を乗っ取ろうとする試みが含まれていないかを確認します。 インジェクションの試みと思われる内容がある場合、結果をユーザーと共有する前に Claude のコンテキストに警告が追加されます。
本番環境での自動モード
チームはすでに、本番環境のデフォルトとして自動モードを実行しています:
- Adobe のマーチャンダイジングプラットフォームチームは、Adobe.com 上で 90 か国以上、30 以上の言語で展開されている価格ページやプロモーションページを、正確かつ最新の状態に保つ役割を担っています。 彼らは、それらのページを構築・検証するためのエージェントループを構築し、自動モードで実行することで、エンジニアがレビュー用の完成した PR を受け取れるようにしました。
- Nuro は、研究部門とエンジニアリング部門全体で自動モードを運用しており、夜間に稼働する研究エージェントが評価指標に対してヒルクライムを適用し、完成した PR を翌朝までにレビュー用に返しています。
- Gusto は、エンジニアが権限チェックを完全に回避しようとする原因となっていた権限設定の負担を解消するために、自動モードを採用しました。5 月中旬以降のセッションの約 10% で分類器による拒否が発生しています。これは、正当なタスクを遅らせることなく、分類器が実際に機能している証拠です。
- Garner Health は、管理設定を通じて従業員 550 人全員に自動モードをデフォルトとして展開しました。これにより、手動で管理するコマンド許可リストに依存しない、全社的なソフトウェア開発ライフサイクル(SDLC)が標準化されました。

「Adobe では、Adobe.com で提供する顧客体験の品質を損なうことなく、スピーディーに取り組みを進めたいと考えています。Claude Code の自動モードを使ってエージェントループを構築したことで、私たちの作業は飛躍的に加速しました。Claude はユーザーインターフェイスを構築した後、意図したデザインと一致しているかを再度確認し、私たちが目にする前に問題があれば自動的に修正します。これにより、開発サイクルを短縮しながら、ピクセル単位で完璧な成果を実現できました」

「先日、午後10時にエージェントを起動したところ、午前5時まで動き続け、朝には3件のPRを生成していました。かなり素晴らしいと思います。自動モードでのみ、この種のワークロードが可能になります。」

「Auto モードによって、スピードとコントロールのより安全なバランスを実現できました。繰り返し表示されるプロンプトをなくし、安全性を損なうことなく生産性を向上させることができました。Auto モードが適切なタイミングでブロックしてくれることがわかるので、自信を持ってスピーディーに進めることができます。」

「Auto mode があるからこそ実現できた、エンジニアリング組織全体のための標準化された SDLC を構築しました。従業員は、これによって肩の荷が下りたと感じています。彼らは、もはやエージェントを何時間も監視し続ける必要はありません。」
これらのお客様が本番環境で自動モードをどのように実行しているかをご覧ください。
ご利用にあたって
Pro、Max、Ultra、Team ユーザー向け:デフォルトの権限モードを設定していない場合は、製品内通知が表示され、新しいセッションは自動モードで開始されます。別のデフォルトを設定している場合は、デフォルトを自動モードに切り替えるかどうかを確認する 1 回限りのプロンプトが表示される場合があります。 Team 管理者が管理設定でデフォルトを設定している場合、お客様の設定は変更されません。
Enterprise ユーザーおよび Claude API 経由で Claude Code にアクセスするユーザーについては、自動モードは今のところオプトインのままです。 今後1か月以内に自動モードをデフォルトにする予定ですが、実施前に Enterprise 管理者へ通知いたします。
モードを切り替えるには、CLI で Shift+Tab を押すか、デスクトップアプリのモード選択ドロップダウンを使用してください。管理者は、管理設定内の `defaultMode` で組織全体のデフォルトを固定したり、`disableAutoMode` で自動モードを完全にオフにしたりできます。
最後に、自動モードはほとんどのユーザーにとってリスクを低減すると考えていますが、分類システムに依存しているため、リスクを排除するものではありません。 本番インフラストラクチャに対する重要度の高い変更については、引き続き Claude のアクションをご自身で確認することをお勧めします。 設定手順の詳細については、自動モードのドキュメントをご覧ください。
本記事は、Conner Phillippi 氏が執筆し、Nicholas Carlini 氏、Isaac Fung 氏、John Hughes 氏、Alex Isken 氏、Shawn Moore 氏、Javier Rando 氏、Molly Vorwerck 氏が寄稿しました。著者らはまた、Yacine Azmi、Chandler Bair、Kefan Chen、Boris Cherny、Ian Grunert、Lydia Hallie、Alex Kleiman、Lauren Polansky、Deon Poncini、Robert Schonberger、Marie Vachovsky、Qing Wang、Cat Wu、Daniel Xu、そしてAlice Zhaoにも感謝いたします。
1 Claude Code v2.1.205 と Codex v0.144.5 を評価しました。 OpenAI は先週 Auto-review の新バージョンをリリースし、これにより結果が変わる可能性があります。