MCPサーバーにおけるリソースは、典型的なHTTPサーバーにおけるGETリクエストハンドラーと同様に、クライアントにデータを公開できるようにします。これらは、アクションを実行するのではなく情報を取得する必要があるシナリオに最適です。
例を通してリソースを理解する
ユーザーが@document_nameと入力してファイルを参照できる、ドキュメントメンション機能を構築したいとします。これには2つの操作が必要です。
- 利用可能なすべてのドキュメントのリストを取得する(自動補完用)
- 特定のドキュメントの内容を取得する(メンションされたとき)
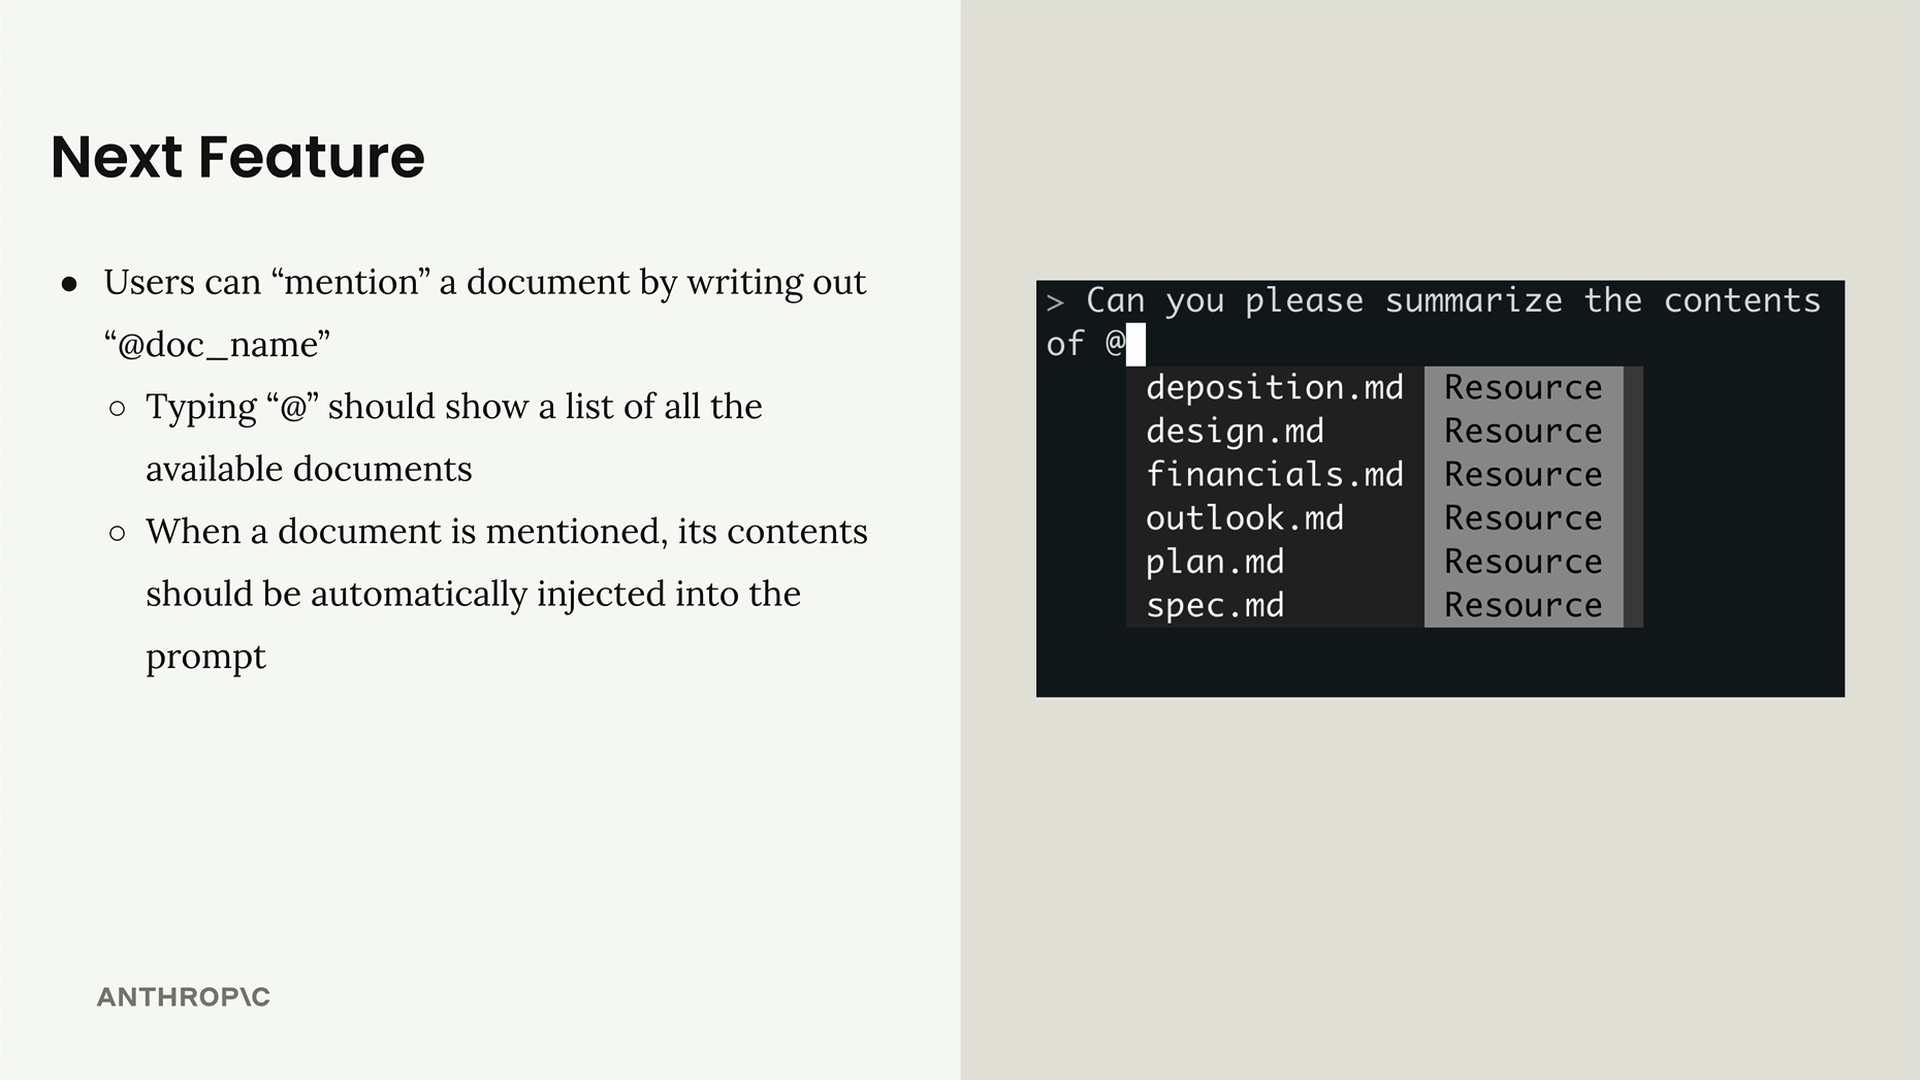
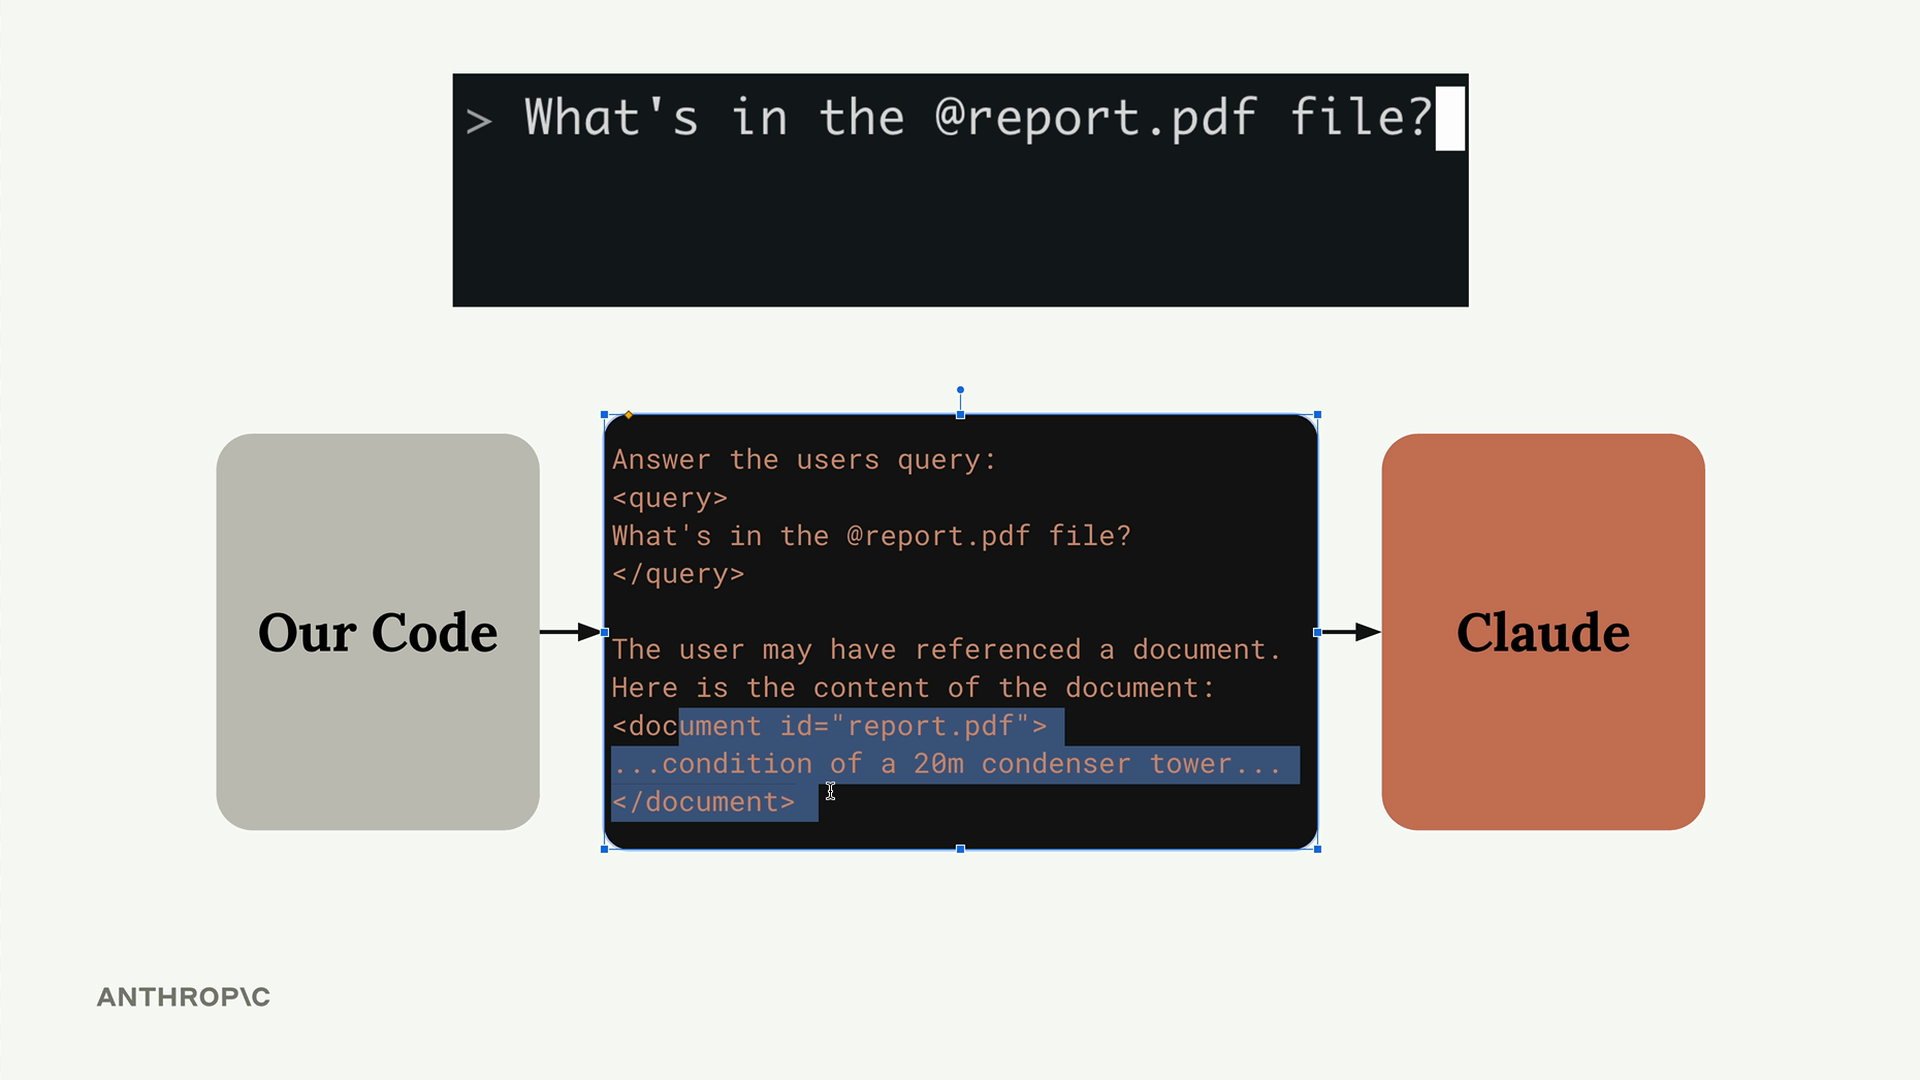
ユーザーがドキュメントをメンションすると、システムは自動的にそのドキュメントの内容をClaudeに送信されるプロンプトに注入し、Claudeが情報を取得するためにツールを使用する必要がなくなります。
リソースの動作方法
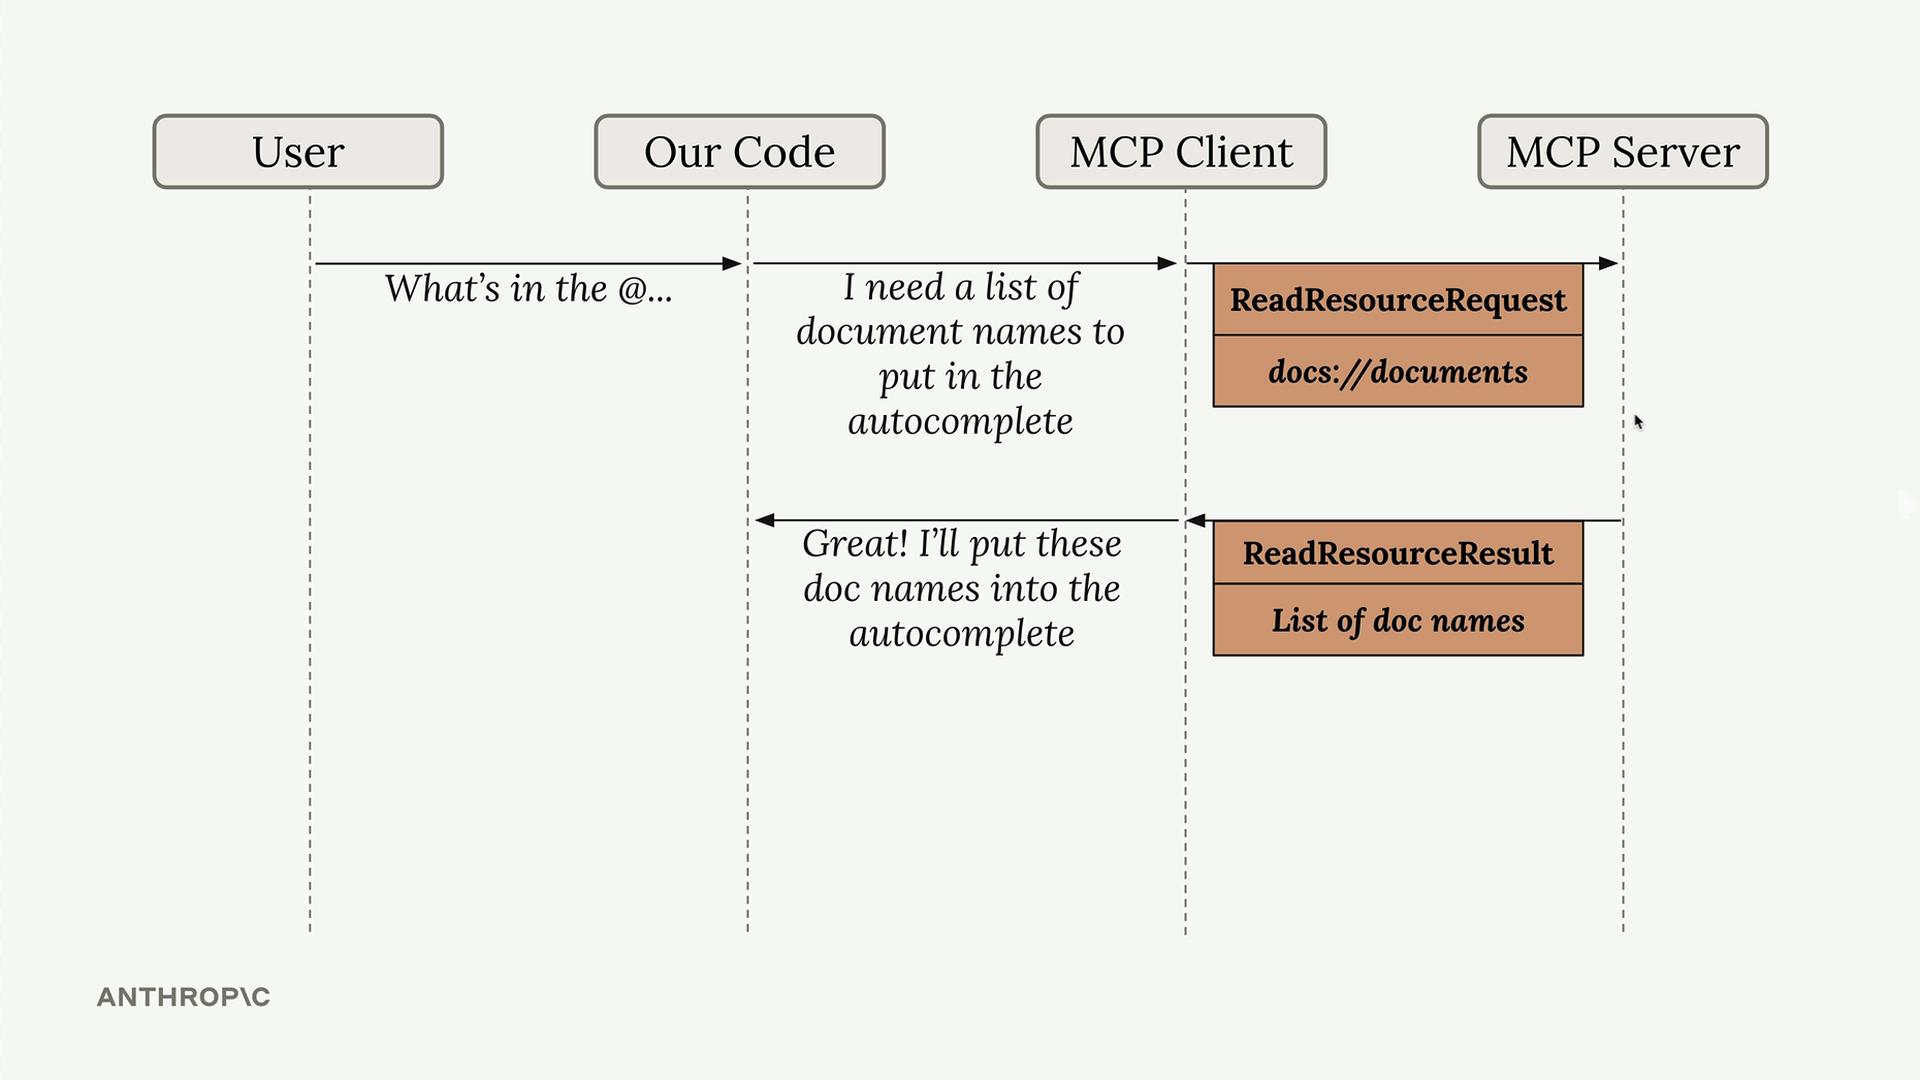
リソースはリクエスト・レスポンスパターンに従います。クライアントがデータを必要とする場合、どのリソースを要求するかを識別するためにURIを含むReadResourceRequestを送信します。MCPサーバーはこのリクエストを処理し、ReadResourceResultでデータを返します。
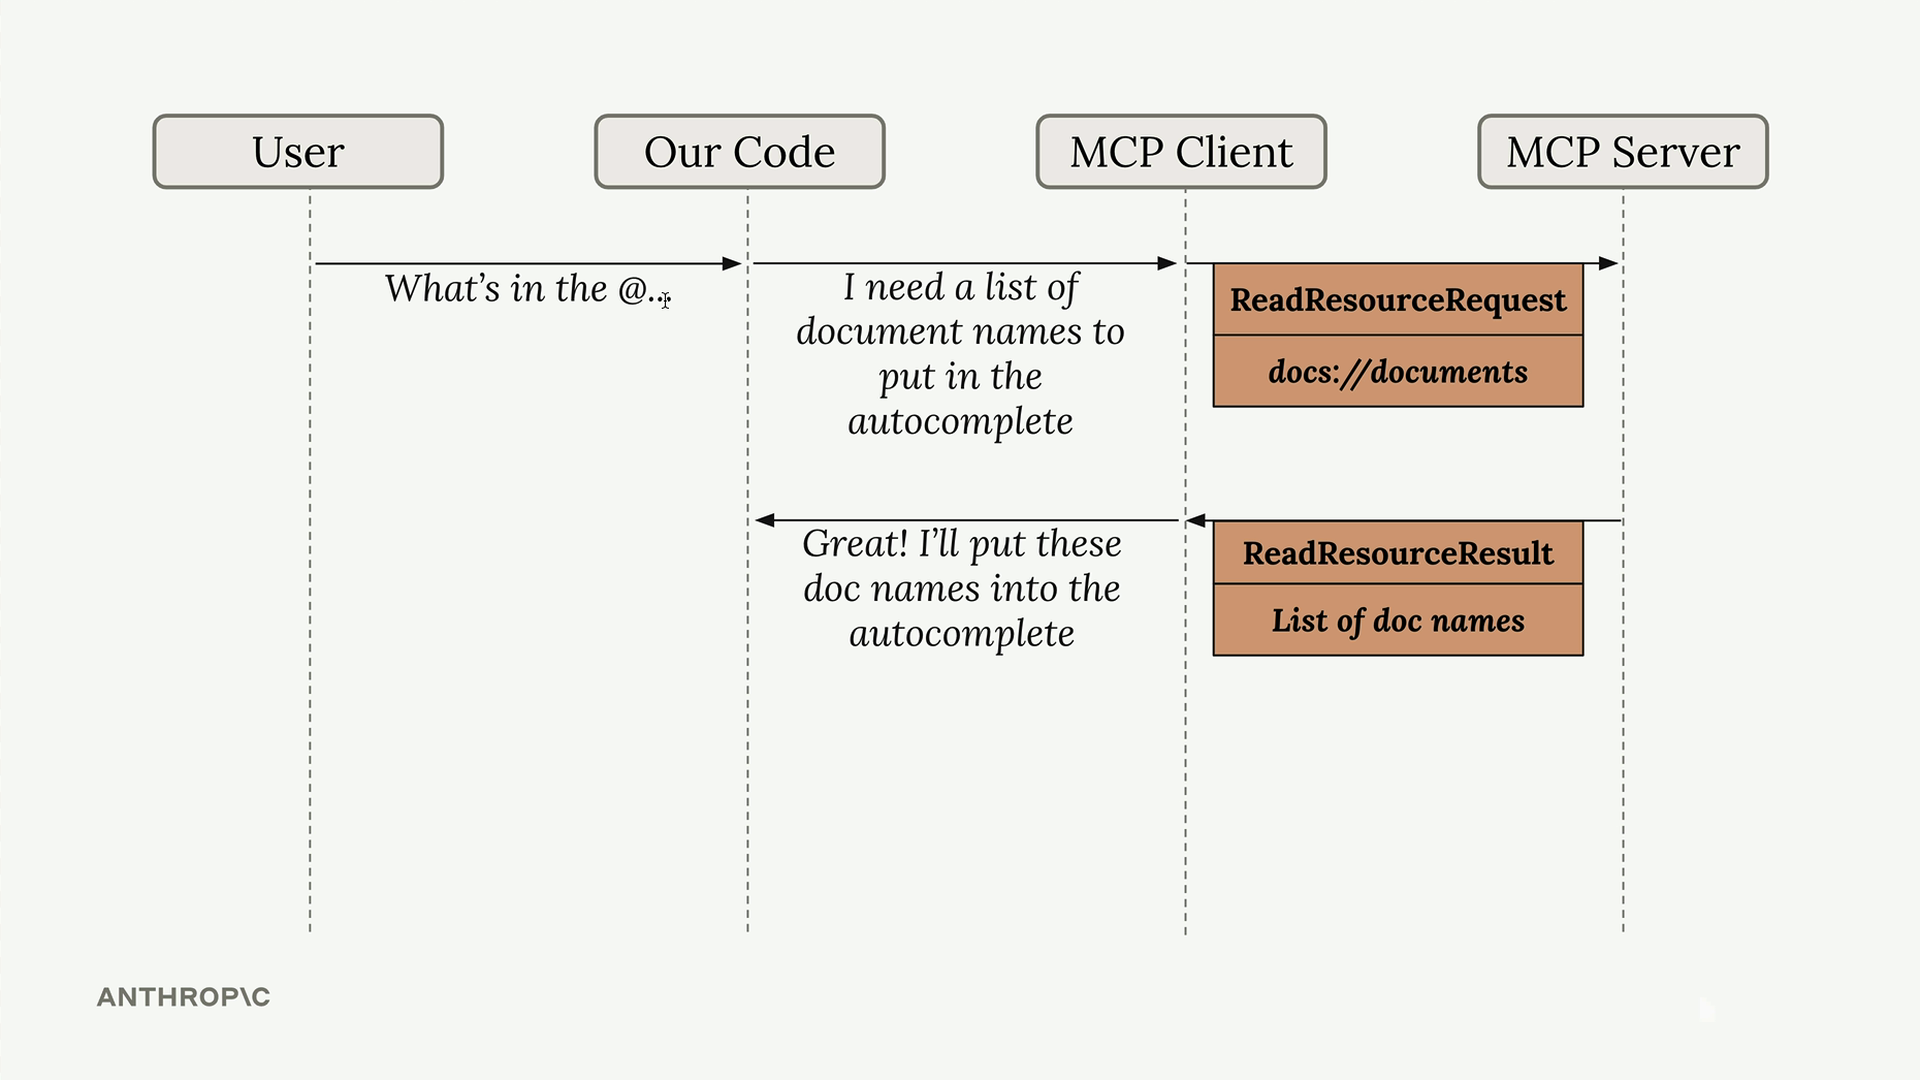
フローは次のようになります。あなたのコードはMCPクライアントにリソースを要求し、クライアントはそのリクエストをMCPサーバーに転送します。サーバーはURIを処理し、適切な関数を実行して結果を返します。
リソースの種類
リソースには2つの種類があります。
直接リソース(Direct Resources)
直接リソースは決して変化しない静的なURIを持ちます。パラメータを必要としない操作に最適です。
@mcp.resource(
    "docs://documents",
    mime_type="application/json"
)
def list_docs() -> list[str]:
    return list(docs.keys())
テンプレート化リソース(Templated Resources)
テンプレート化リソースは、URIにパラメータを含みます。Python SDKはこれらのパラメータを自動的に解析し、関数へのキーワード引数として渡します。
@mcp.resource(
    "docs://documents/{doc_id}",
    mime_type="text/plain"
)
def fetch_doc(doc_id: str) -> str:
    if doc_id not in docs:
        raise ValueError(f"Doc with id {doc_id} not found")
    return docs[doc_id]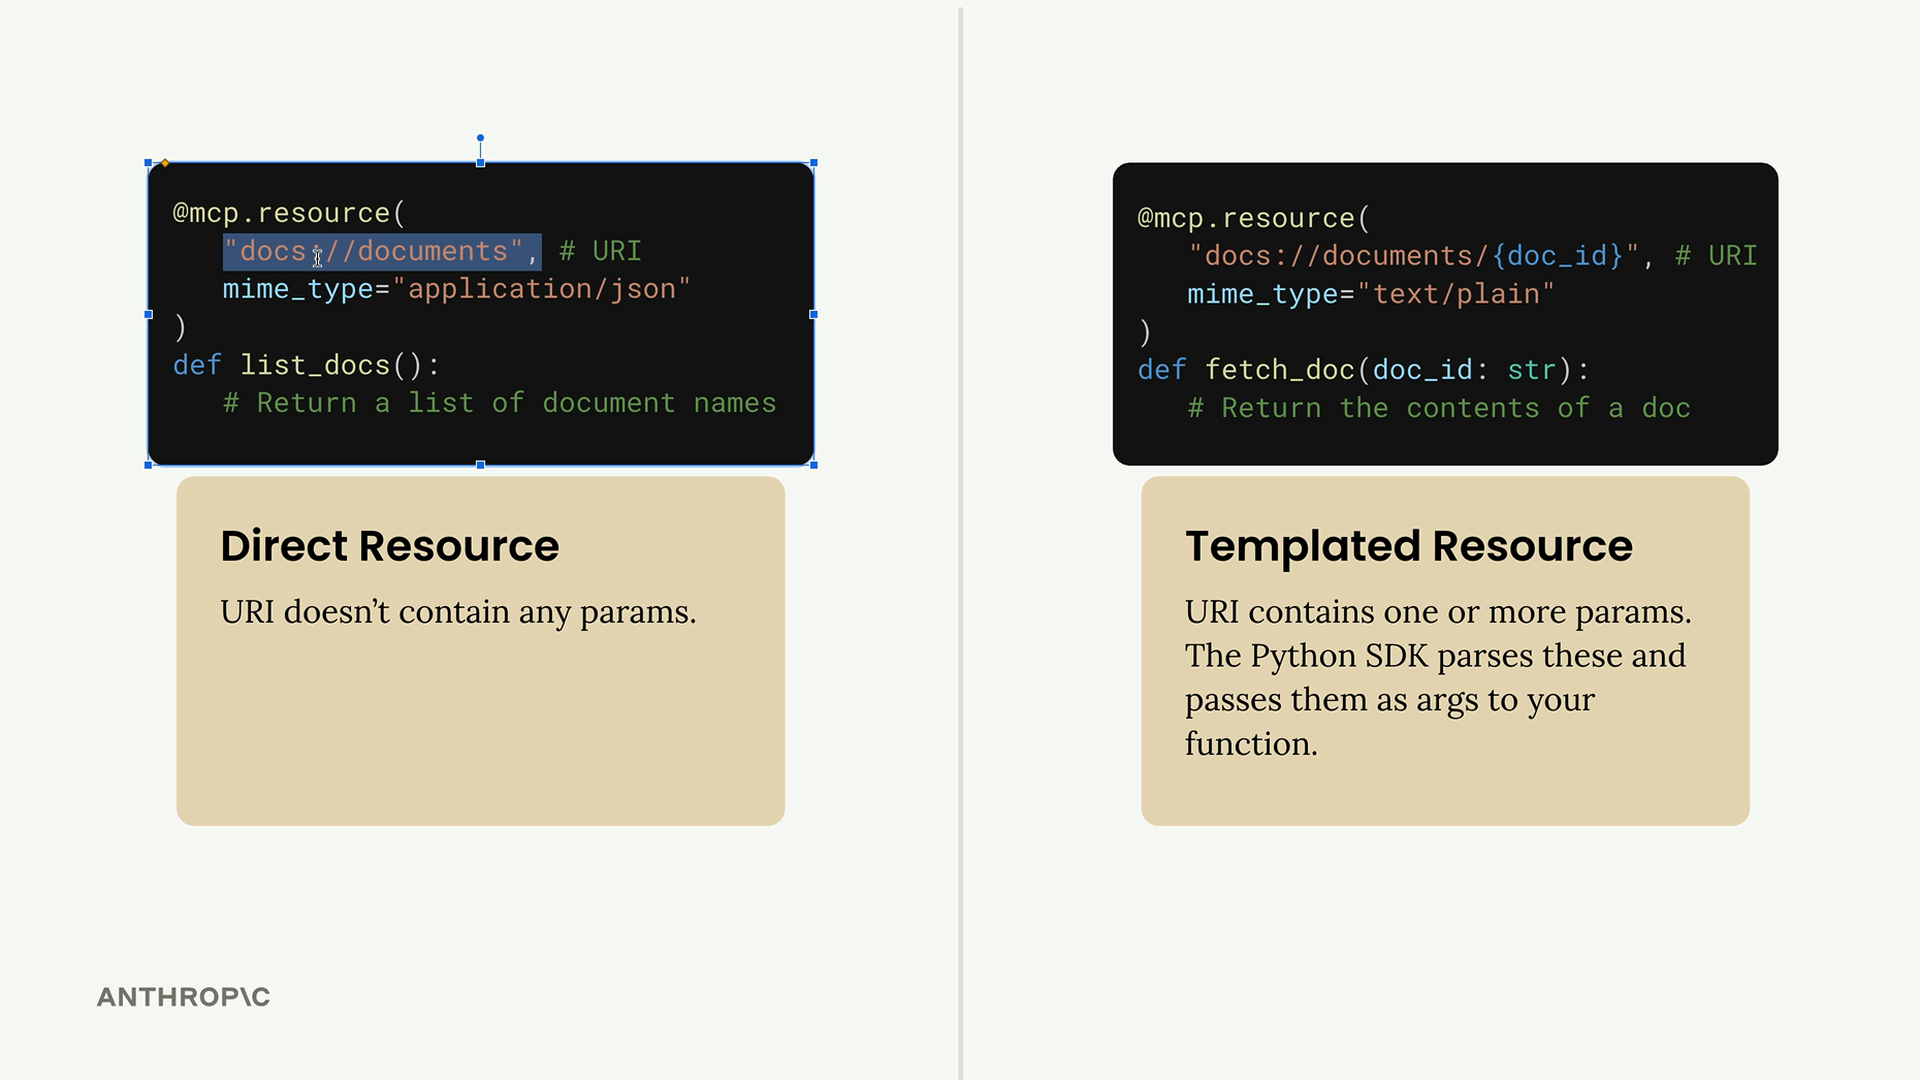
実装の詳細
リソースは、文字列、JSON、バイナリデータなど、任意の種類のデータを返すことができます。mime_typeパラメータを使用して、返しているデータの種類についてクライアントにヒントを与えます。
- 構造化データには
"application/json" - プレーンテキストには
"text/plain" - バイナリファイルには
"application/pdf"
MCP Python SDKは戻り値を自動的にシリアライズします。オブジェクトを手動でJSON文字列に変換する必要はありません。データ構造を返すだけで、SDKがシリアライズを処理します。
リソースのテスト
MCP Inspectorを使用してリソースをテストできます。以下でサーバーを起動します。
uv run mcp dev mcp_server.py次に、ブラウザでインスペクターに接続します。2つのセクションが表示されます。
- Resources - 直接/静的リソースの一覧を表示します
- Resource Templates - テンプレート化リソースの一覧を表示します
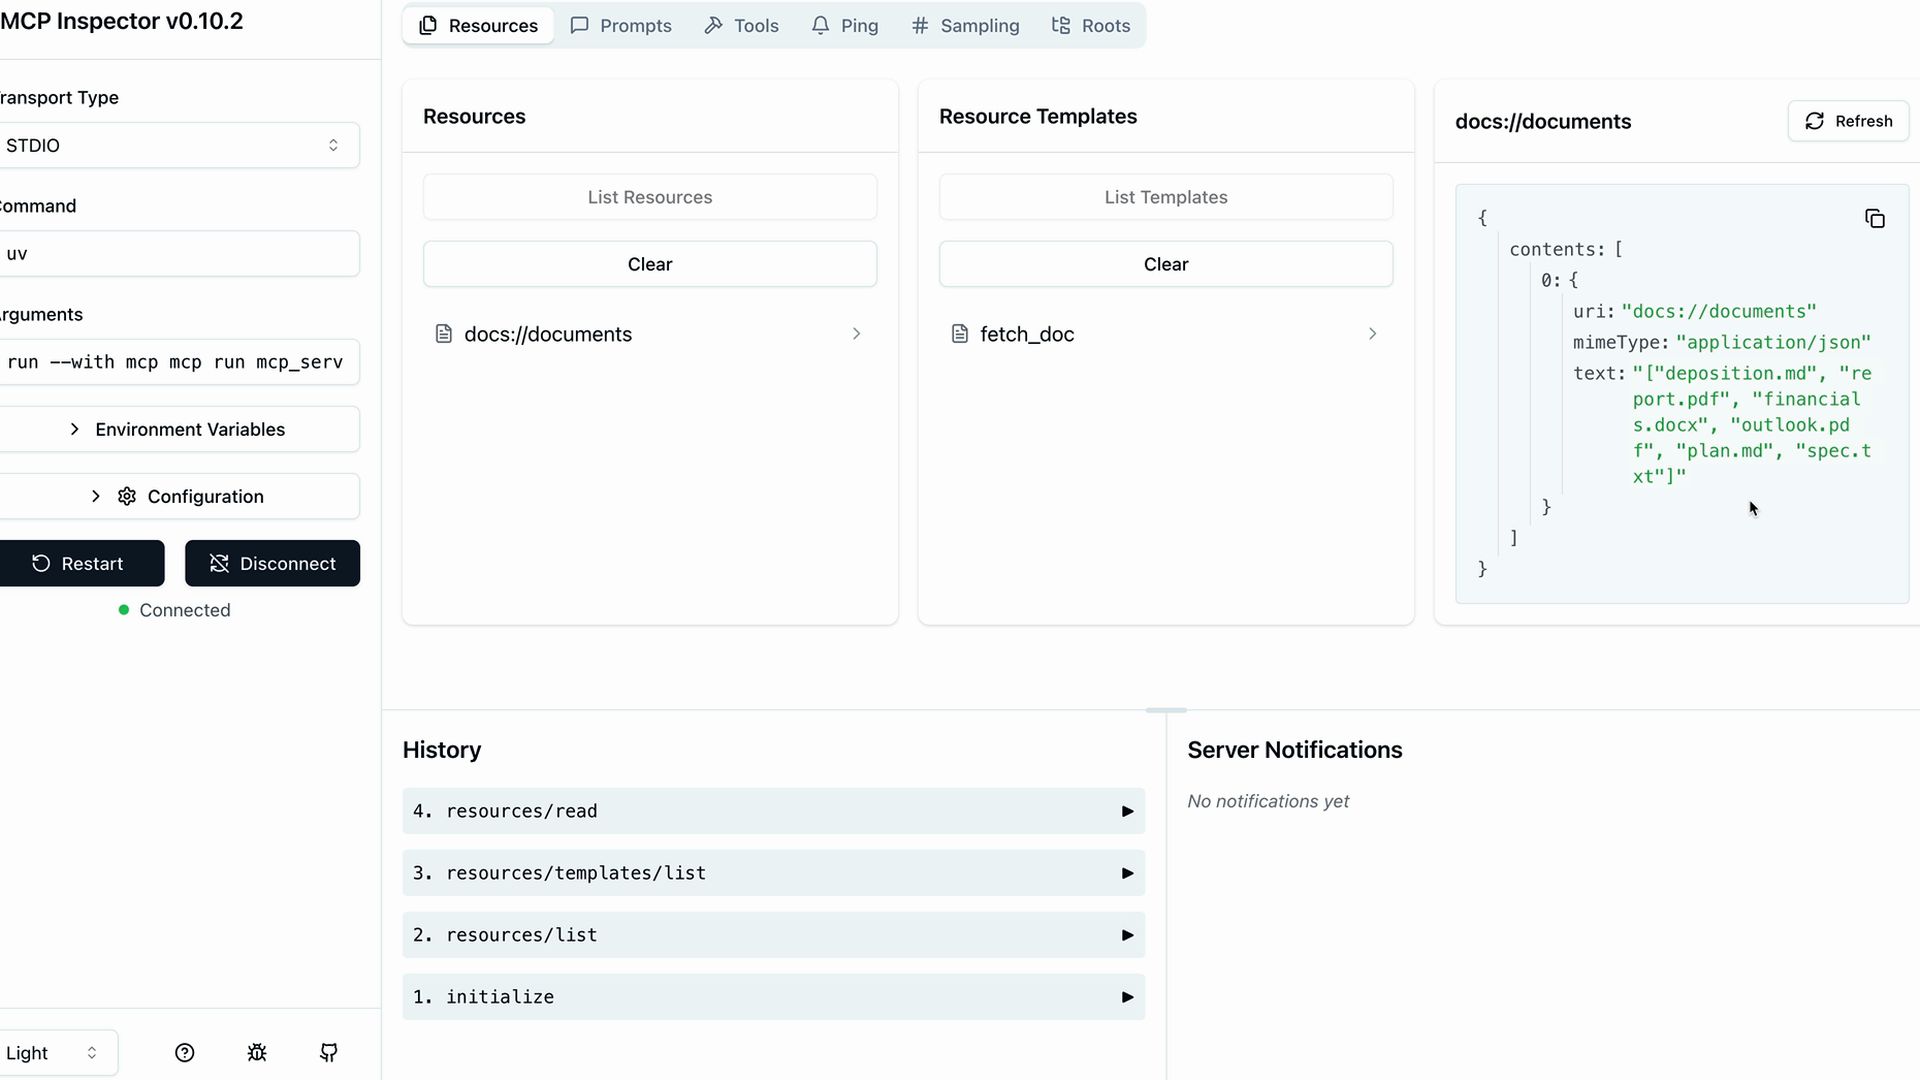
任意のリソースをクリックしてテストします。テンプレート化リソースの場合、パラメータの値を指定する必要があります。インスペクターは、MIMEタイプとシリアライズされたデータを含む、クライアントが受け取る正確なレスポンス構造を表示します。
リソースは、MCPサーバーから読み取り専用データを公開するためのクリーンな方法を提供し、クライアントがツール呼び出しの複雑さなしに情報を取得できるようにします。