適切なモデルの選択
あなたはClaudeを使ったアプリをリリースしようとしています。どのモデルを選びますか?最も賢いモデルをデフォルトにすれば、APIの請求額に驚くことになるでしょう。最も安いモデルを選べば、出力が十分でないかもしれません。各モデルにはそれぞれ異なるトレードオフがあり、正しいモデルを選ぶことは品質とコストの両方に影響します。
モデルの階層
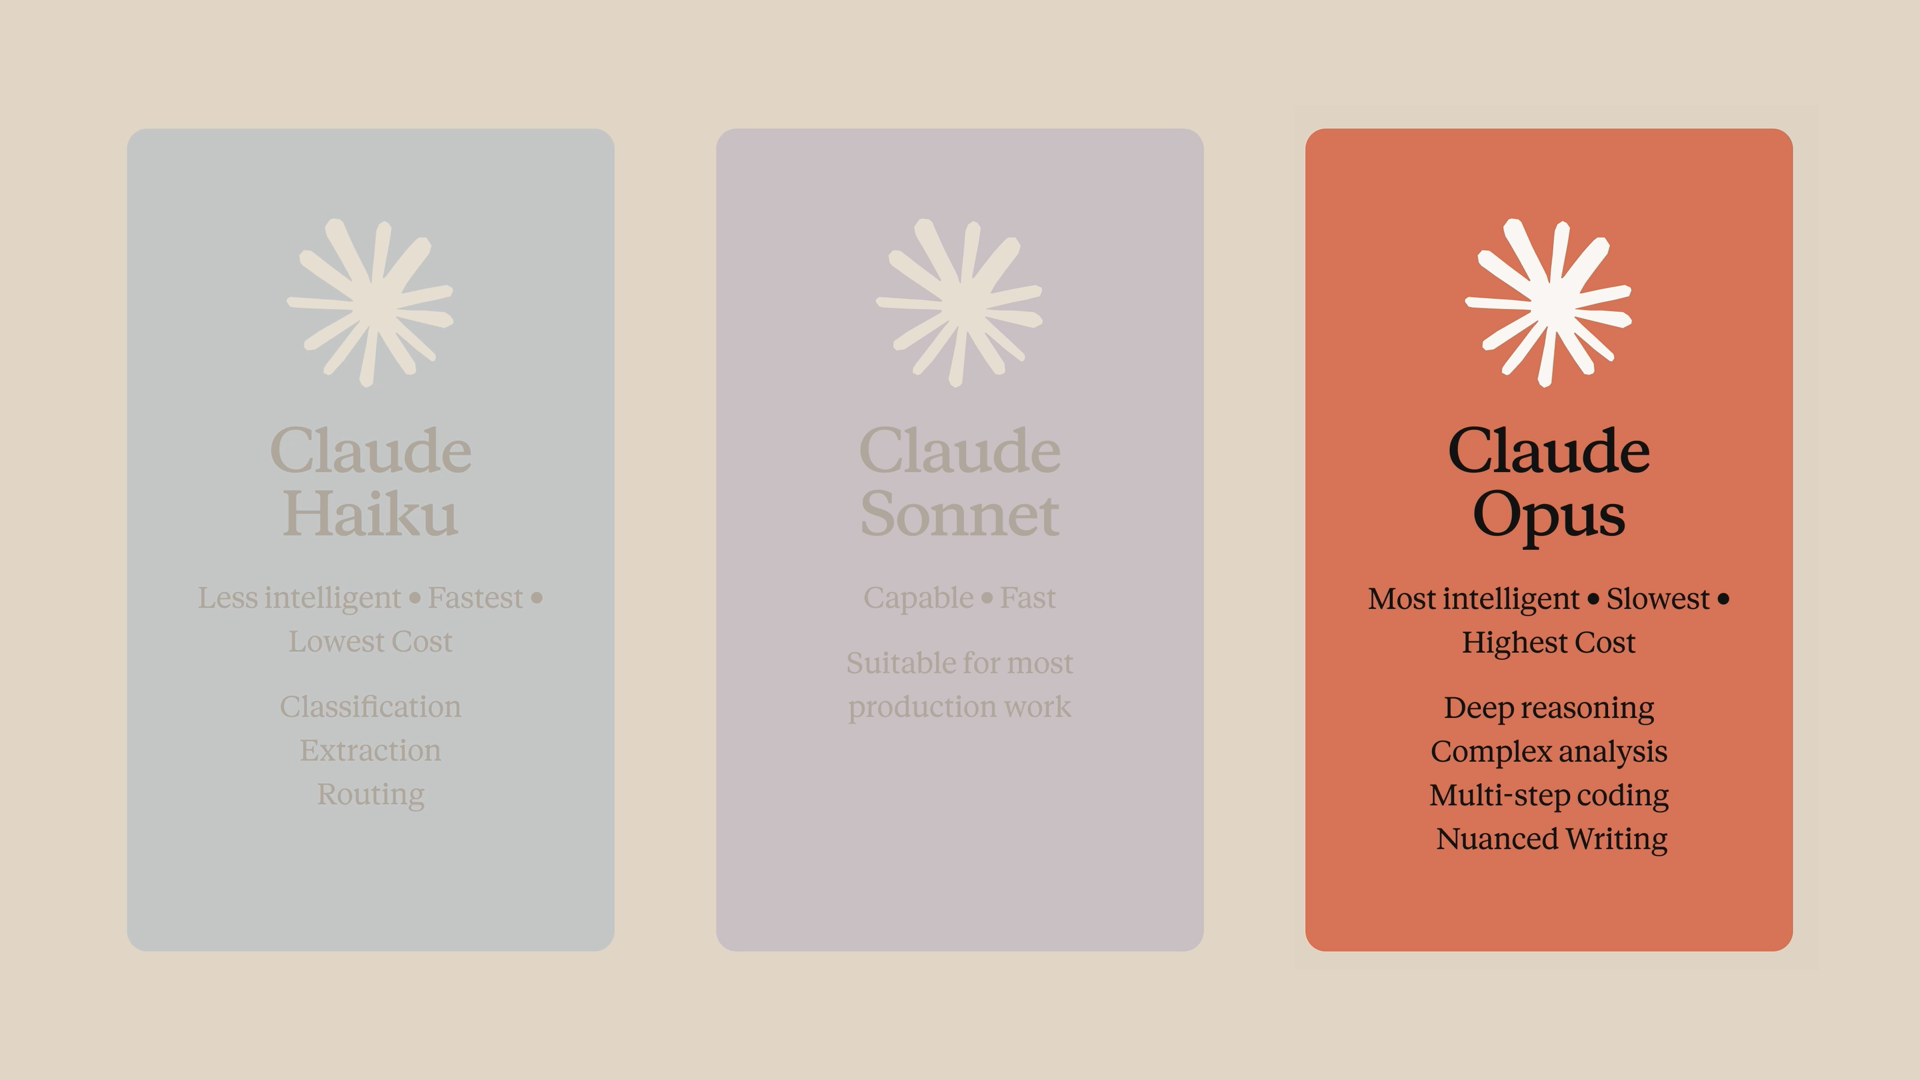
Anthropicは現在4つのモデル階層を提供しており、APIコールのmodelパラメータでそれらを選択します。
- Claude Fableは、これまでで最も高性能なモデルであり、Opusの上に位置する新しい階層で、最も難易度の高い課題のために構築されています。Opusよりもコストが高いため、その追加の性能に対して対価を払う価値のある作業のために取っておきましょう。現行のFableモデルはClaude Fable 5.1(
claude-fable-5-1)です。 - Claude Opusは3つの中核モデルファミリーの中で最も高性能ですが、同時に3つの中で最も低速かつ最もコストが高いモデルでもあります。深い推論、複雑な分析、複数ステップにわたるコーディング、そして繊細な文章作成に使用してください。現行のOpusモデルはClaude Opus 5.5(
claude-opus-5-5)です。 - Claude Haikuは最も高速かつ最も低コストで、最大限の知能よりも速度とコスト効率を重視して最適化されています。分類、抽出、ルーティングなど、大量かつ低複雑度の作業に使用してください。現行のHaikuモデルはClaude Haiku 4.5(
claude-haiku-4-5)です。 - Claude Sonnetはちょうど良い位置にあります。知能、速度、コストのバランスが取れた組み合わせで、ほとんどの本番作業にうまく機能します。現行のSonnetモデルはClaude Sonnet 5(
claude-sonnet-5)です。
シンプルな評価から始める
本番用のコードを書く前に、シンプルな評価(evaluation)を設定しましょう。これは、各モデルに通して実行し、自分のユースケースにとって良い出力とは何かという基準に照らしてスコアを付ける、サンプル入力のセットです。凝ったものは必要ありません。実際のワークロードから抽出した20〜30件程度の代表的な例で始めるには十分です。
そして、階層を順に上がっていきます。
- まずHaikuでサンプルを実行します。品質が保たれていれば、それで完了です。しかも多くのコストを節約できたことになります。
- 保たれなければ、Sonnetに引き上げます。
- タスクにそれが必要な場合にのみOpusに手を伸ばします。
各階層を横並びで比較する
階層間の違いについて話すだけでなく、実際に見てみましょう。同じプロンプトを3つのモデルすべてに送り、レイテンシとトークン数を観察します。
models = ["claude-haiku-4-5", "claude-sonnet-5", "claude-opus-5-5"]

for model in models:
    response = client.messages.create(
        model=model,
        max_tokens=300,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, response.usage)
ここで起きていることは2つあります。
- ループは各リクエストで
modelフィールドを入れ替えます。プロンプトも最大トークン数も同じで、変わるのはモデルだけです。 response.usageは、APIから直接返される入力トークンと出力トークンの数を教えてくれます。これが、あなたの請求額の計算基準になるものです。
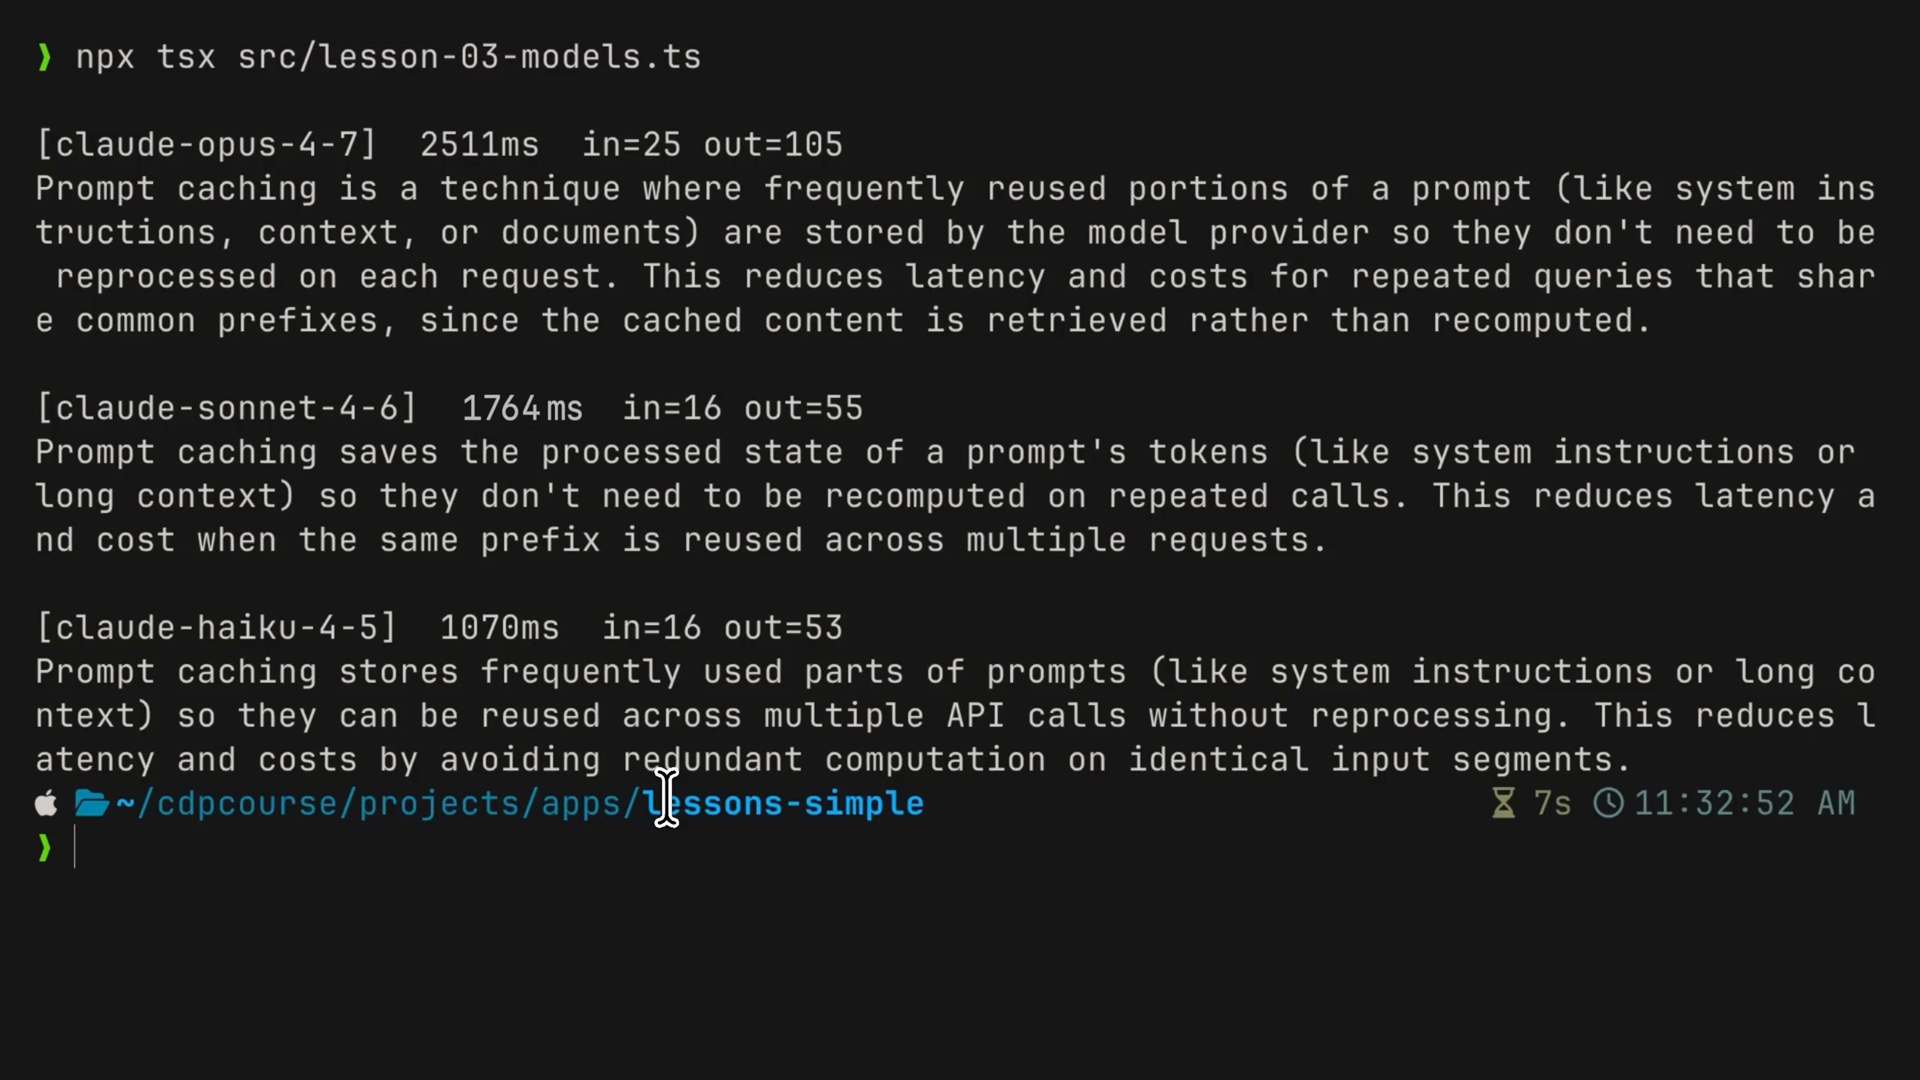
これを実行すると、3つのモデルと3組の数字が確認できます。Opusは最も時間がかかり、最も洗練されて読めますが、2文程度の定義文には、その洗練さは無駄になります。Sonnetは文章を少し引き締めます。そしてHaikuは、しばしば1秒未満で、十分に優秀な2文の回答を返してきます。率直に言って、この種のシナリオには最適です。
そして、これこそが核心です。適切なモデルとは、実際にそのまま出荷できる出力を生成する、最も安いモデルのことです。定義文であればHaikuで十分です。規制当局への回答文を起案する場合であれば、同じ比較を行い、おそらく最終的にOpusに行き着くでしょう。評価の形は毎回同じです。
異なる作業を異なるモデルにルーティングする
実際のアプリでは、同じエンドポイント内で異なる種類の作業を異なるモデルにルーティングすることになります。ドキュメント処理ルートを持つオペレーションダッシュボードを例に考えてみましょう。
- 受信するすべてのファイルはHaikuで分類されます。
- クライアントへの更新はSonnetで起案されます。
- RFP(提案依頼書)への回答だけがOpusに手を伸ばします。
1つのキュー、3つのモデル、タスクごとに選択されます。
まとめ
- Anthropicは4つのモデル階層を提供しています。利用可能な最高の性能のためのFable、難しい問題のためのOpus、日常業務のためのSonnet、そして大量処理のためのHaikuです。
- 本番用のコードを書く前に、実際のワークロードから抽出した20〜30件の代表的な例で、シンプルな評価を設定しましょう。
- Haikuから上に向かって評価を実行し、実際にそのまま出荷できる出力を生成する最も安いモデルで止めましょう。
response.usageは入力トークンと出力トークンを報告し、これがあなたの請求額の基準になります。- 本番環境では、すべてに1つのモデルを選ぶのではなく、同じエンドポイント内で異なるタスクを異なるモデルにルーティングしましょう。