에이전트 구축: 서브 에이전트를 메인 에이전트 루프에 통합해야 하는 시점
Claude Platform에서 에이전트를 구축할 때 서브 에이전트 수를 줄이고 대신 컨텍스트와 도구를 점진적으로 공개하는 방식을 활용하면 비용과 지연 시간을 줄이는 동시에 품질을 개선할 수 있습니다. 마이그레이션 시점과 방법을 알아봅니다.
Claude Platform에서 여러 서브 에이전트로 구성된 에이전트를 구축했다면, 마이그레이션 키트를 활용해 어떤 서브 에이전트를 메인 에이전트 루프에 통합하는 것이 적절할지 확인해 보세요. 가이드 워크플로우를 실행하여 패턴을 식별하고, 대안을 평가한 뒤 최적의 접근 방식을 검증합니다. 여기에는 에이전트에서 실행하기 전에 모의 시스템에서 시험해 볼 수 있는 데모가 포함되어 있습니다.
서브 에이전트는 자체 컨텍스트 창, 도구, 지침을 갖추고 코디네이터가 조율하는 에이전트로, 에이전트 설계의 핵심 구성 요소입니다. 검증, 병렬 작업, 모듈식 권한 부여에 효과적입니다. 저희는 Claude Platform으로 구축한 여러 자체 에이전트(예: 멀티 에이전트 리서치 시스템)에서 서브 에이전트를 활용하고 있습니다.
그러나 최근 Applied AI 팀은 라우터, 플래너, 도메인 서브 에이전트를 메인 에이전트 루프에 통합하여 이점을 얻은 엔터프라이즈 에이전트 배포 패턴을 발견했습니다. 여러 엔터프라이즈 배포 환경을 비교한 결과, 스킬을 갖춘 단일 에이전트가 단일 프롬프트로 모든 것을 처리하는 설계와 서브 에이전트 설계 방식보다 품질 면에서 우수한 성능을 보이는 경우가 많았으며, 작업당 비용과 지연 시간도 더 낮은 경우가 많았습니다.
예를 들어, 한 회사는 고객 대상 에이전트 내에 있는 12개의 전문 서브 에이전트 때문에 브랜드에 부합하는 일관된 경험을 유지하기 어렵고, 지연 시간이 늘어나 사용자 경험이 저하된다는 사실을 확인했습니다.
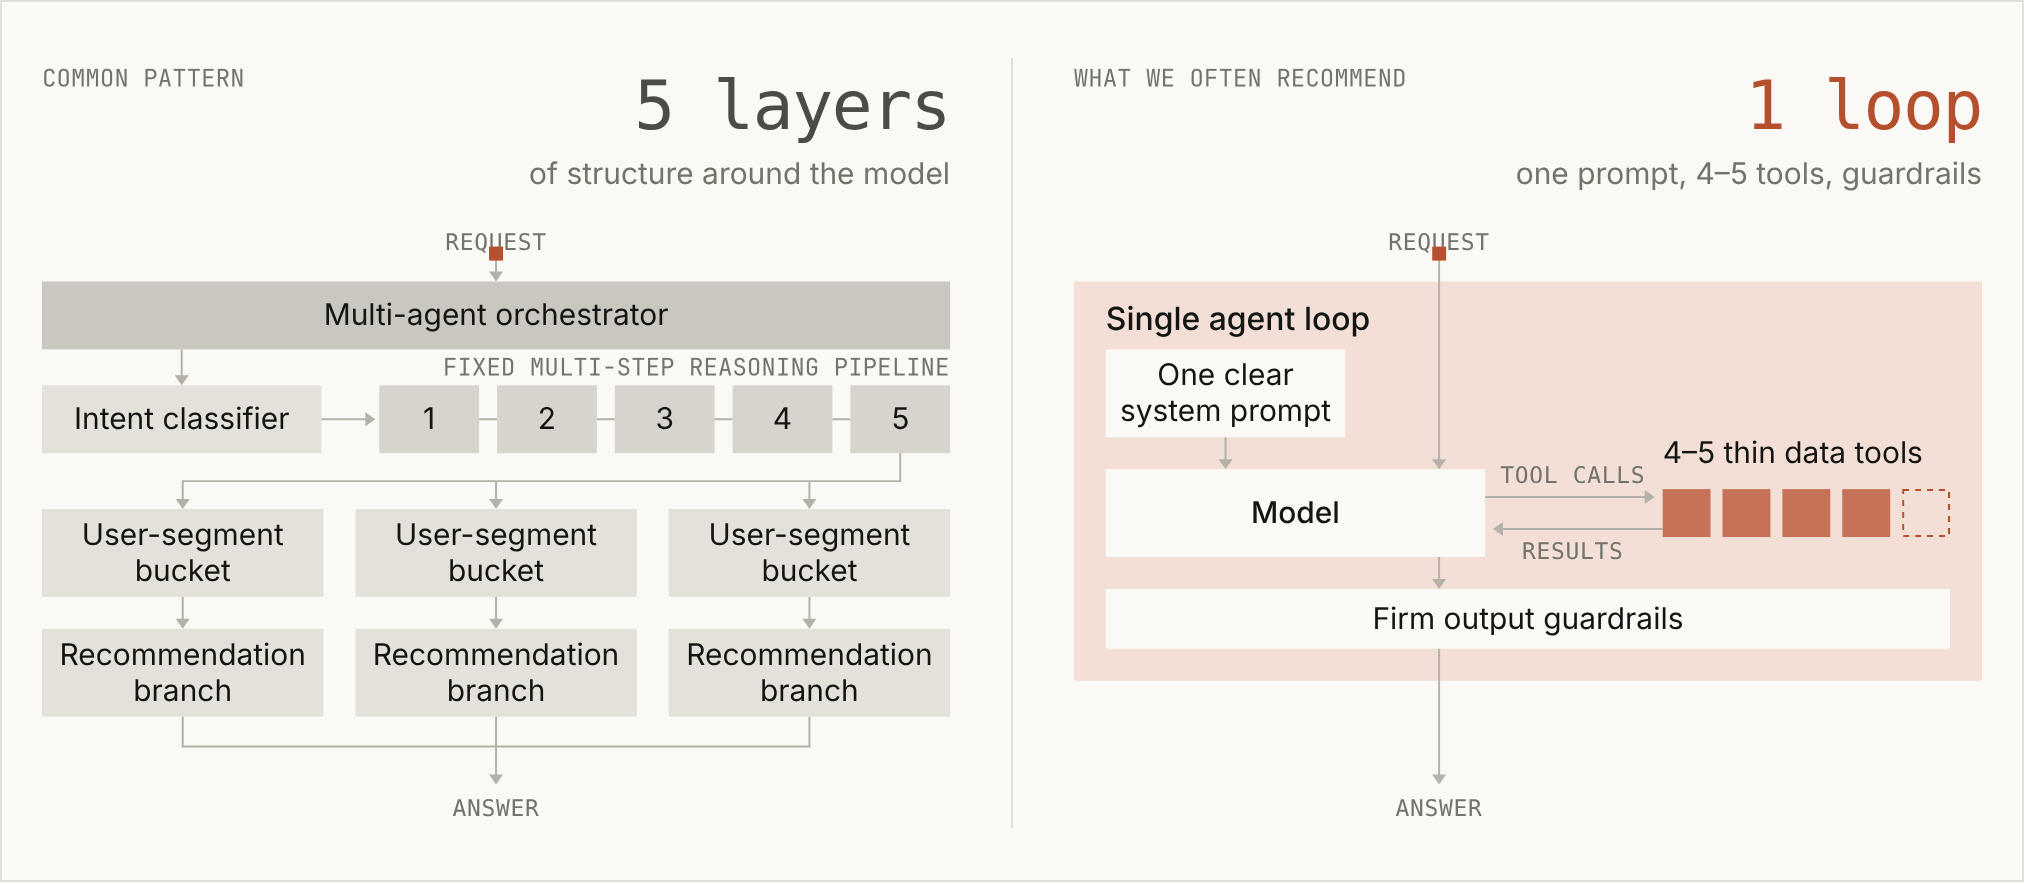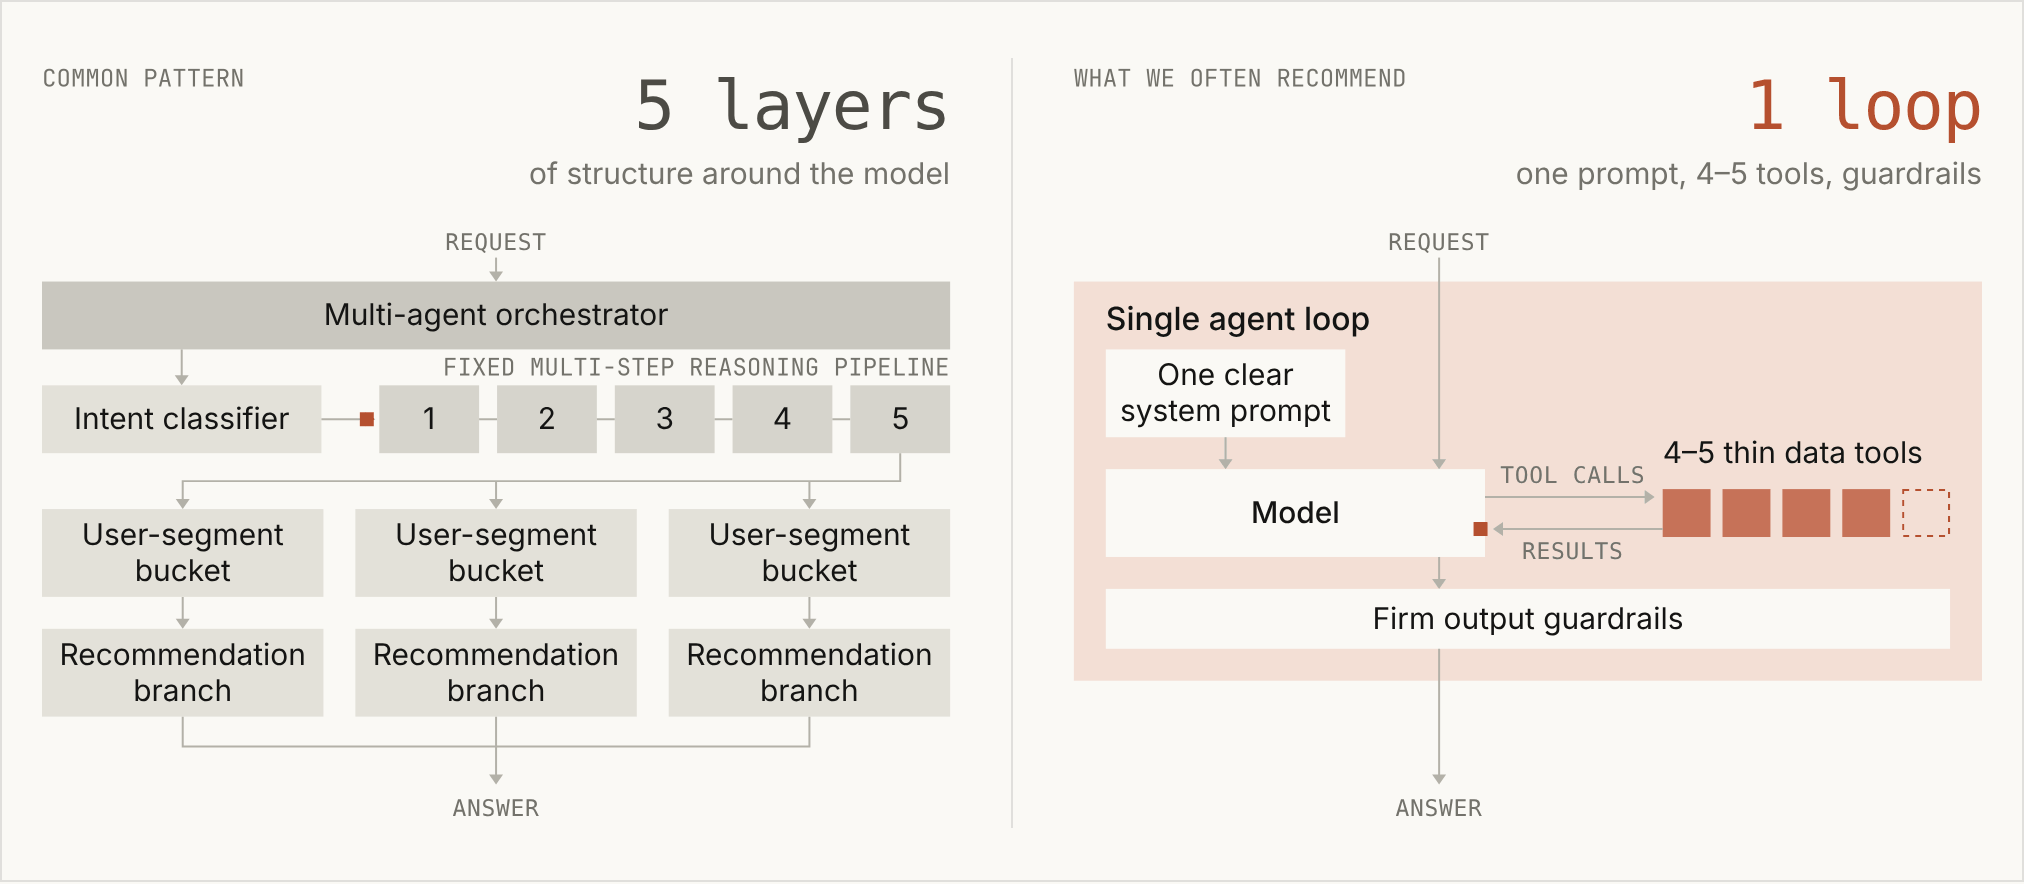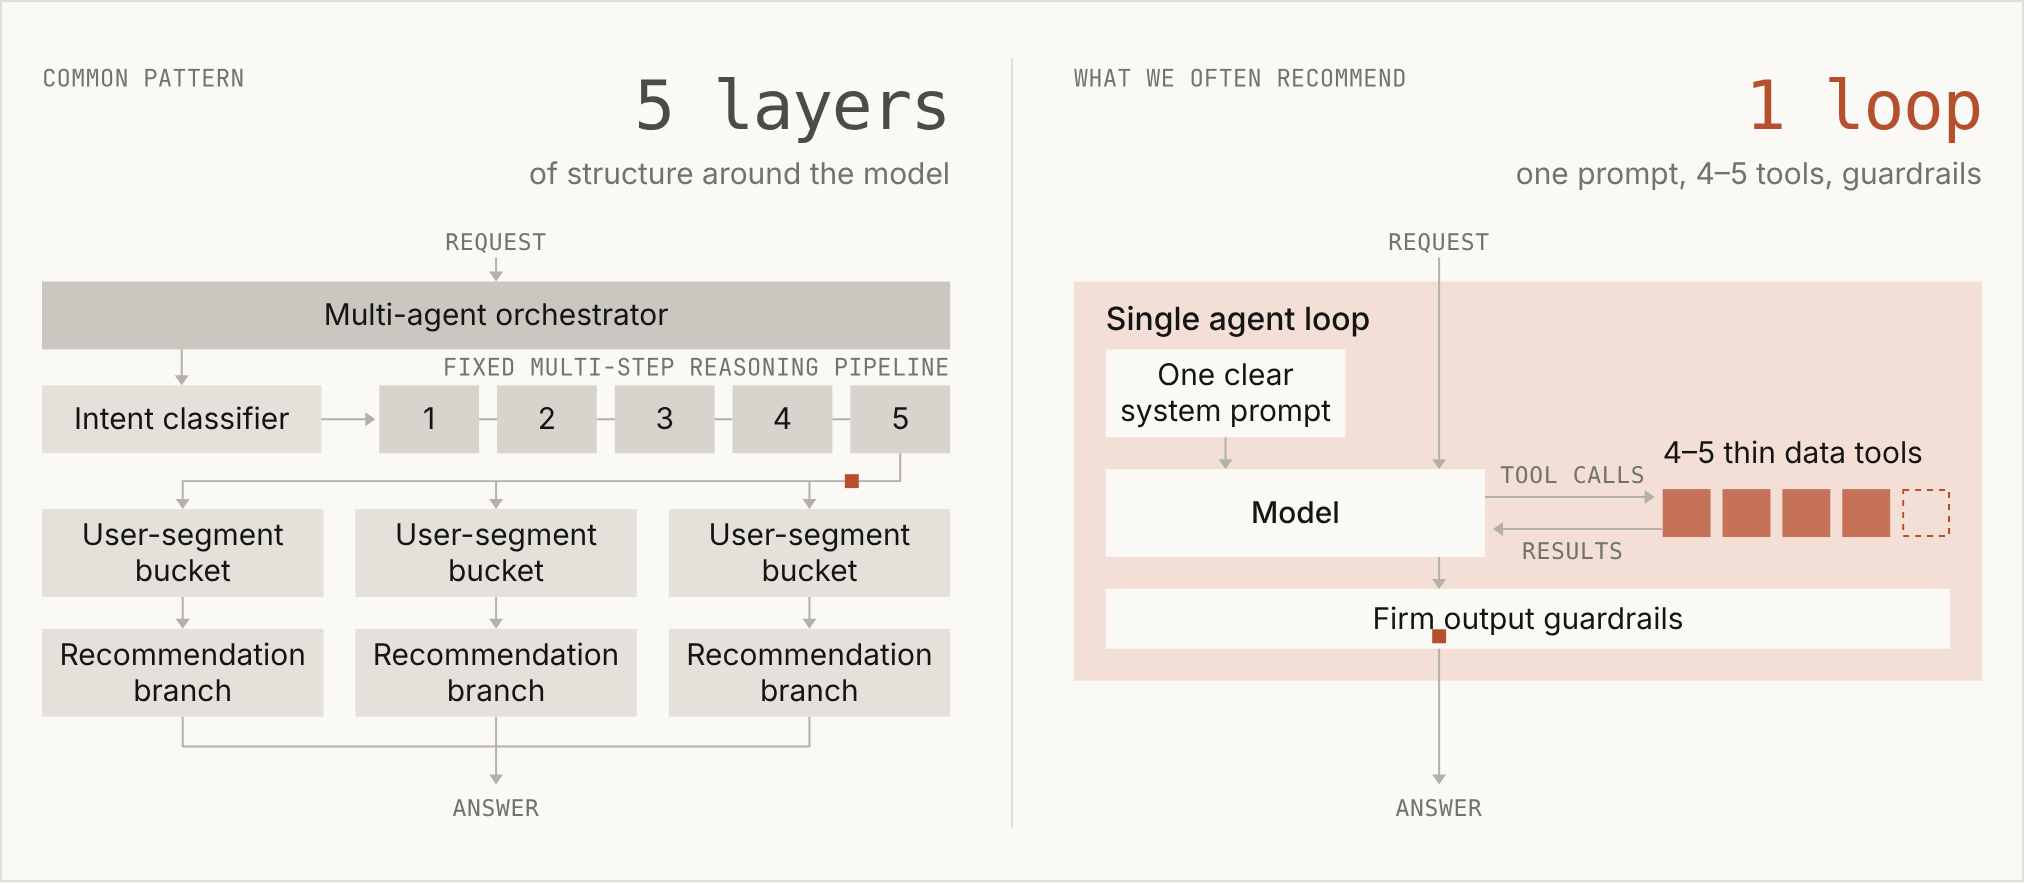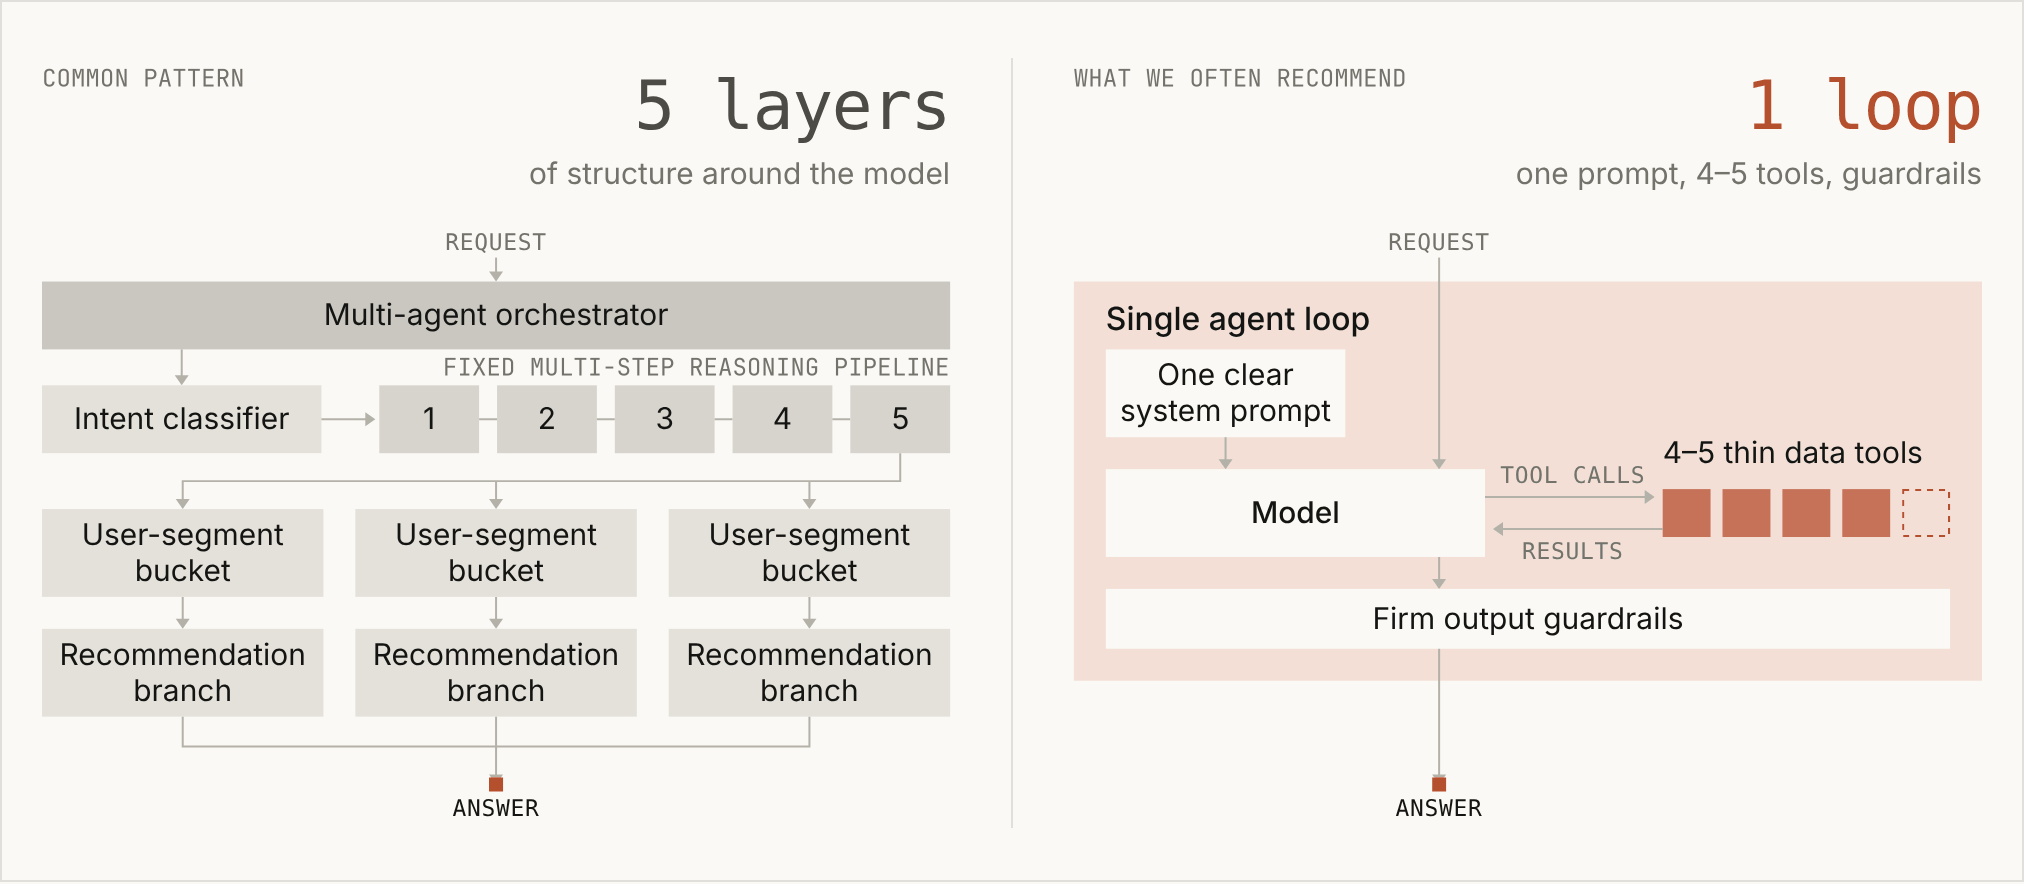
또한 의도 분류기, 고정된 다단계 추론 파이프라인, 사용자 세그먼트 분류, 별도의 추천 브랜치, 그리고 최상단의 멀티 에이전트 오케스트레이터로 이어지는 익숙한 흐름을 따르는 에이전트 설계안을 자주 접합니다.
이러한 경우 피드백은 대개, 해당 구조의 상당 부분이 이제 모델이 스스로 처리할 수 있는 작업을 대신 수행하고 있었으며, 명확한 시스템 프롬프트 하나, 4~5개의 경량 데이터 도구, 엄격한 출력 가드레일만으로도 대부분의 사용 사례를 처리할 수 있다는 것입니다.
명확히 하자면, 서브 에이전트는 최첨단 연구 분야를 포함해 여전히 활용 분야가 있습니다. 다음의 경우에 사용하세요.
- 단일 에이전트 루프가 컨텍스트가 과도하게 늘어나 측정 가능한 수준의 성능 저하를 겪거나,
- 작업이 완료되면 폐기할 수 있는 새로운 컨텍스트 창을 사용해 여러 작업을 병렬로 처리해야 하거나,
- 단일 에이전트가 적절한 도구를 선택하는 데 어려움을 겪거나, 시스템 프롬프트에 상충하는 지침이 포함된 경우.
그러나 기업이 각 팀이나 문제 유형마다 별도의 서브 에이전트를 할당하다 보니, 에이전트 아키텍처가 자사 조직도를 그대로 복제하는 경우가 너무 많습니다. (콘웨이의 법칙을 보여주는 사례입니다)
이 글에서는 대규모 조직에서 에이전트를 구축하며 얻은 모범 사례와 함께 서브 에이전트를 메인 에이전트 루프에 통합하는 것을 고려해야 하는 시점을 설명합니다.
대규모 조직의 에이전트 구축 실패 모드
기업은 여러 제품과 기능을 하나의 고객 인터페이스로 결합하는 에이전트를 구축하고자 하는 경우가 많습니다.
일반적으로 각 기능은 별도의 팀이 담당하므로, 기업은 먼저 각 팀이 자체 에이전트를 구축하도록 한 다음, 중앙 플랫폼 팀이 이를 기반으로 오케스트레이터를 구축합니다. 이는 오케스트레이터-서브 에이전트 구조나 특정 에이전트를 MCP 도구로 노출하는 단일 에이전트 구조 등 여러 형태를 취할 수 있습니다.
가장 간단한 솔루션처럼 보이지만, 곧바로 다음과 같은 측면에서 복잡성을 초래합니다.
- 컨텍스트 관리: 에이전트 간에 어떤 컨텍스트를 교환할지 결정해야 하며, 주고받는 과정에서 세부 정보가 손실되는 경우가 많습니다.
- 서브 에이전트의 무분별한 증가: 모든 팀이 자체 서브 에이전트를 배포하므로, 기업에는 적용되는 표준이나 명확한 소유자도 없이 서로 중복되는 서브 에이전트가 수백 개씩 존재하게 됩니다.
- 프랑켄프롬프트: 모든 팀이 시스템 프롬프트에 문장을 하나씩 추가하면서, 규칙이 서로 충돌하고 일관된 어조를 유지하기 어려워집니다.
- 검증되지 않고 지나치게 국소적인 평가: 각 팀이 자신의 하위 작업에 지나치게 최적화된 자체 평가를 추가합니다. 전체 평가 체계를 총괄하거나 관리하는 사람이 없으며, 경영진은 평가의 의미가 희석된 지나치게 국소적인 점수를 바탕으로 결정을 내립니다.
- 지연 시간: 멀티 에이전트 아키텍처의 복잡성으로 지연 시간이 증가합니다. 멀티 에이전트 하네스를 단일 에이전트 루프와 비교 평가한 한 고객은 후자의 실행 시간이 약 2배 더 빠르다는 사실을 확인했습니다.
점진적 공개 방식의 에이전트 루프 사용
위에서 설명한 오케스트레이터-서브 에이전트 설계는 여러 팀에서 구축한 전문 에이전트를 조정하는 합리적인 접근 방식이지만, 스킬을 통해 컨텍스트를 점진적으로 공개하고 도구 검색을 통해 도구를 점진적으로 공개하는 방식이 더 효과적인 경우가 많습니다. 다시 말해 에이전트는 스킬과 도구에 대한 간단한 설명만 확인하며, 스킬과 도구는 필요할 때만 전체 정보를 로드합니다.
이러한 접근 방식이 합리적인 이유는 세 가지입니다.
- 공유 컨텍스트를 통한 답변 품질 향상: 장시간 실행되는 에이전트의 경우, 여러 작업의 컨텍스트를 메인 컨텍스트 창에 함께 유지하는 것이 좋습니다. 이전 각 단계의 결과를 확인한 에이전트가 이를 연결할 수 있으며, 이를 통해 서브 에이전트가 반환하는 요약 세트보다 더 풍부한 결과물과 더 나은 인사이트를 얻을 수 있습니다. 또한 컨텍스트 창의 수가 줄고 손실이 발생하는 인계 작업도 감소한다는 의미이기도 합니다.
- 점진적 공개로 컨텍스트 팽창 방지: 이 기법을 통해 팀은 모든 컨텍스트를 하나의 긴 시스템 프롬프트에 즉시 로드하지 않고도 다양한 작업을 수행할 수 있는 단일 에이전트를 구축할 수 있습니다. 이를 통해 팀이 이전에 여러 서브 에이전트에 작업을 분할했던 주된 이유가 사라집니다. 실제로 더 고급 모델용 Claude Code의 시스템 프롬프트를 80% 이상 줄였으며, 여기에는 스킬과 도구를 점진적으로 공개하는 방식과 관련된 내용의 감소도 포함되었습니다.
- 모델의 역량 강화: Opus 4.5부터 모델은 대부분의 팀이 예상했던 것보다 훨씬 더 많은 작업을 단일 루프로 관리할 수 있게 되었습니다. Opus 5.5와 Fable 5.1에서는 사고 기능을 끌 수 없으며, 최근 모델은 작업을 진행하면서 진행 상황을 설명하고 스스로 작업 내용을 확인하는 경우가 점점 늘어나 일부 하네스 요소가 필요하지 않게 되었습니다. 새로운 모델이 출시될 때마다 더 많은 의사 결정을 하네스에서 모델 자체로 옮길 수 있습니다. 또한 루프가 더 간단해지면 다음 모델로 전환하기도 쉬워집니다. 저희가 지원한 고객의 마이그레이션 사례에서는 경직된 멀티 에이전트 구조 때문에 새로운 모델이 더 많은 작업을 수행하지 못하는 경우가 많았습니다.
단일 에이전트 루프 설계에는 체계적인 규율이 필요합니다. 즉, 세심하게 관리되는 시스템 프롬프트, 적절한 시점에 트리거되는 스킬 및 도구 설명, 그리고 컨텍스트 창, 메모리, 메모 작성을 신중하게 처리해야 합니다. 이 글의 다음 섹션에서는 마이그레이션과 설계 고려 사항에 대해 더 자세히 설명합니다.
하나의 중앙 팀이 엔드투엔드 품질과 시스템 프롬프트를 담당하고, 모든 새로운 도구와 평가를 배포하기 전에 검토해야 합니다. 중앙 팀을 소규모로 유지하면 반복 작업을 빠르게 진행하고, 대규모 조직 전반의 조정 비용을 낮추는 데 도움이 됩니다.
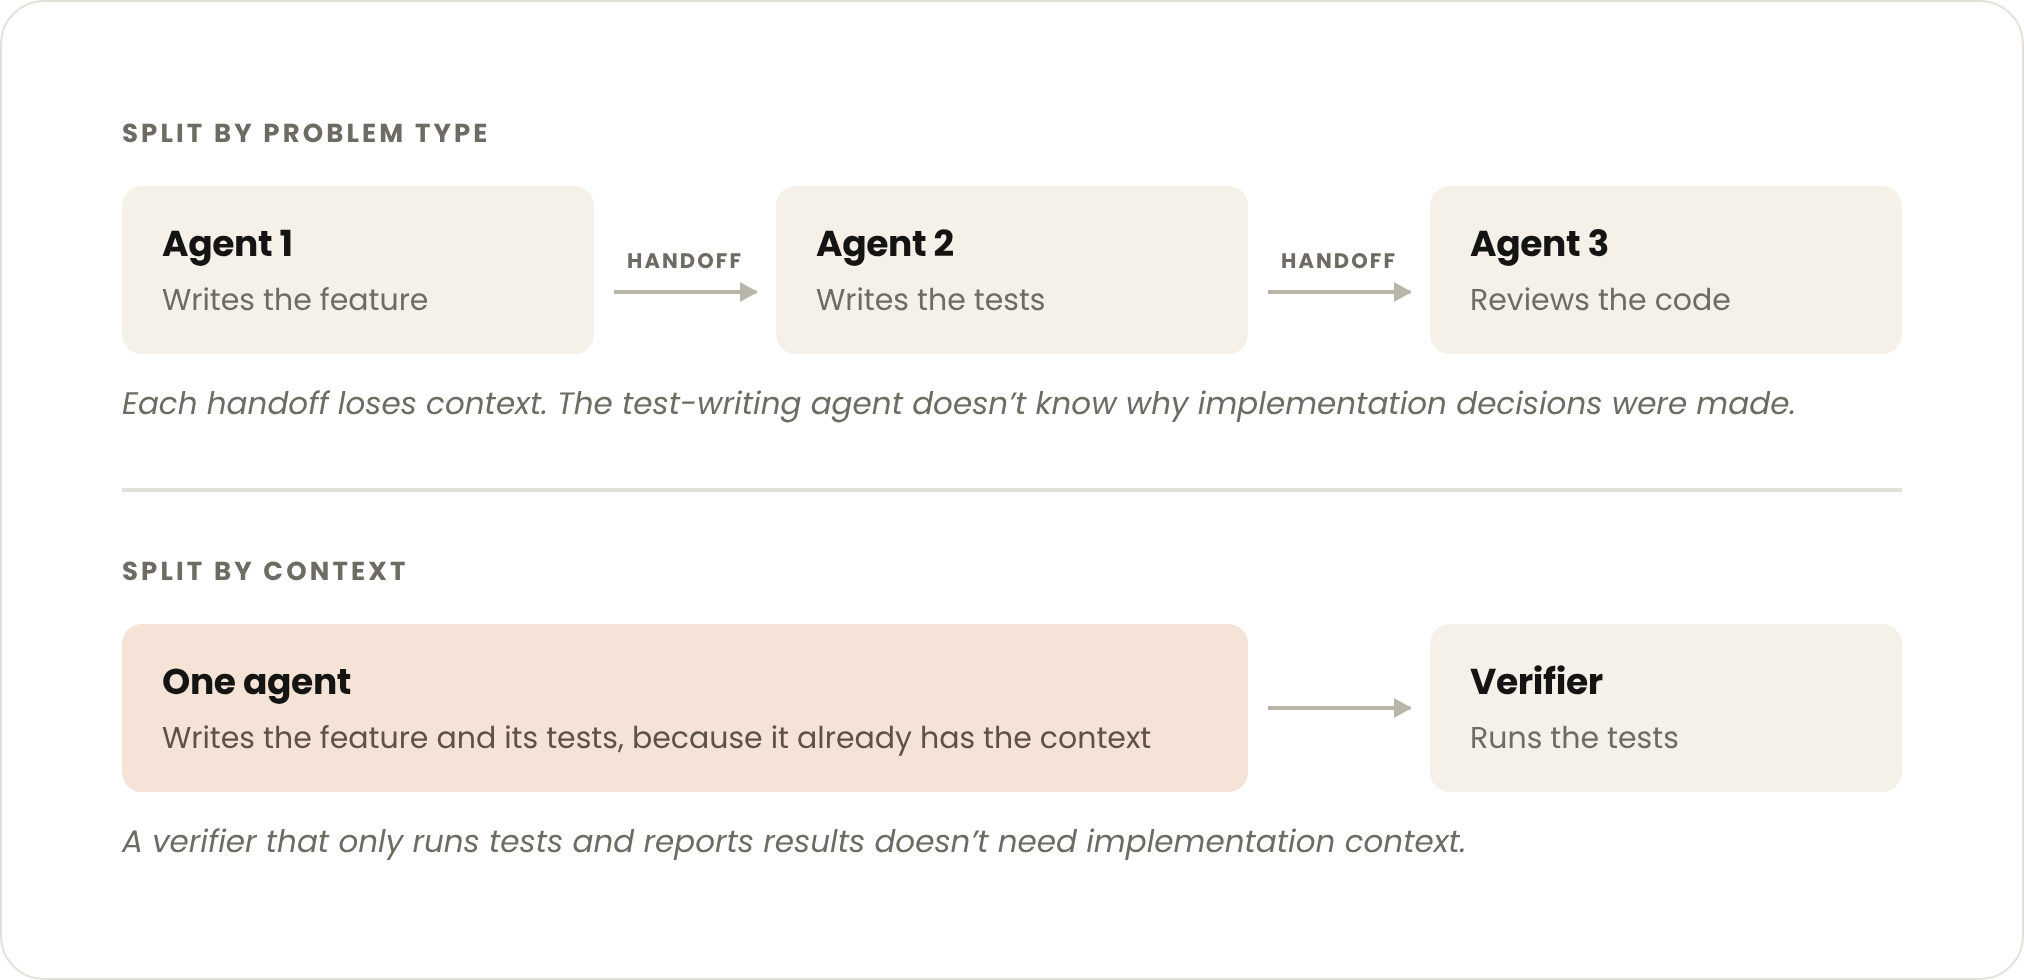
멀티 에이전트 방식을 택한다면, 작동할 수 있는 가장 간단한 패턴(생성기-검증기, 오케스트레이터-서브 에이전트 등)으로 시작하세요. 컨텍스트 기준으로 나누어 경계를 효과적으로 설정해야 합니다. 각 서브 에이전트에 시스템의 나머지 부분이 거의 필요 없는 작업을 맡기고, 간결한 결과를 반환하도록 합니다(독립적인 리서치 경로, 인터페이스가 명확한 개별 컴포넌트, 블랙박스 검증 등이 좋은 예입니다). 에이전트가 문제 유형으로 분류되면, 핸드오프마다 정보를 앞뒤로 전달하는 '전화 게임'에 참여하게 되어 정보의 충실도가 떨어집니다.
서브 에이전트를 메인 에이전트 루프에 통합하는 방법
많은 팀이 이미 프로덕션 환경에서 오케스트레이터와 전문 에이전트 세트를 사용하고 있습니다. 다음은 저희가 구현하기를 권장하는 단일 루프 설계입니다.
- 하나의 모델과 하나의 컨텍스트 창이 개방형 도구 루프를 실행하며, 제한(턴 및 비용 예산, 쓰기 게이트)은 하네스에서 설정합니다.
- 턴마다 모델은 도구 호출 배치를 생성합니다. 하네스는 이들을 병렬로 실행하고, 원시 결과를 동일한 모델에 반환합니다. 모델은 또 다른 배치, 사용자에 대한 질문, 답변 중 다음 단계를 결정합니다.
- 모델이 답변을 제공하거나 예산 한도에 도달하면 루프가 중지됩니다. 답변 후에는 선택적으로 목표 확인 또는 검증기 검사를 실행할 수 있습니다.
- 모델은 첫 번째 턴에 컨텍스트 내에서 계획을 작성하고, 결과가 도착하면 이를 수정합니다. 이것이 오케스트레이터 및 전문 에이전트 구성과 비교했을 때의 주요 차이점입니다. 계획을 작성하는 모델이 실행까지 진행하므로, 턴 도중에도 계획을 변경할 수 있습니다.
- 컨텍스트는 여전히 로드되며, 에이전트가 직접 관리합니다.
- 모델이 각 단계를 결정하므로, 규칙 카탈로그에 따라 계획을 다시 작성하는 코드 단계가 더 이상 필요하지 않습니다.
- 순서 지정 및 도메인 절차는 스킬로 이전됩니다.
- 엄격한 제한(검증, 승인 게이트)과 대화 중에 발생하는 기타 작업(예: 메모리 조회)은 도구로 옮겨집니다.
- 코드는 여전히 비용이 저렴하고 거의 항상 관련성이 높은 항목(예: 엔티티 확인 단계)을 로드하고, 루프가 호출하는 도구 내에서 기계적인 부분(페이로드 구성, 스트림 파싱, 명확화 요청 후 재개)을 처리하는 데 사용할 수 있습니다.
또한 이 단일 루프 설계는 에이전트가 학습한 모든 정보를 하나의 컨텍스트에 유지하므로, 많은 팀이 목표로 노력하는 최종 상태(사용자의 높은 목표를 이해하고 사용자를 대신해 행동하는 에이전트)의 달성에도 도움이 됩니다.
다음 제안은 팀이 멀티 에이전트 시스템에서 단일 에이전트 루프로 단계적으로 전환하는 방법, 그리고 그 과정에서 여러 팀이 해당 에이전트에 지속적으로 기여하는 방법입니다.
작업 완료 평가
첫 번째 단계는 서브 에이전트를 메인 에이전트 루프에 포함할지 결정하는 데 도움이 되는 평가 세트를 만드는 것입니다. 저희가 효과를 확인한 평가 구조는 중앙 팀이 소유한 하나의 공유 엔드투엔드 세트와, 각 스킬을 소유한 팀이 해당 스킬과 함께 제공하는 소규모 평가 세트로 구성됩니다. 골든 예시 10개만으로도 평가를 시작할 수 있습니다.
루브릭에 따라 에이전트의 최종 메시지를 평가하는 것은 답변 품질을 추적하기 위한 좋은 출발점입니다. 아직 오케스트레이터가 있다면, 라우팅 정확도도 추적해야 합니다(오케스트레이터가 올바른 서브 에이전트를 선택했는가). 서브 에이전트가 통합된 후에는 대신 에이전트가 올바른 스킬을 로드했는지 또는 올바른 도구를 호출했는지 확인이 필요합니다. 점진적으로 작업 완료 평가를 갖춰 나가는 것이 좋습니다. 아키텍처를 비교할 때 이것이 가장 중요하기 때문입니다.
내부 시스템을 재생하기 어렵고 사용자 참여를 시뮬레이션하기도 어려운 환경에서는 이러한 작업이 복잡할 수 있습니다. 저희가 내부적으로 효과를 본 접근 방법 중 하나는 중요한 이벤트의 타임스탬프를 기록해 두었다가, 나중에 재생하여 타깃 평가를 실행하는 것입니다.
서브 에이전트의 점진적 축소
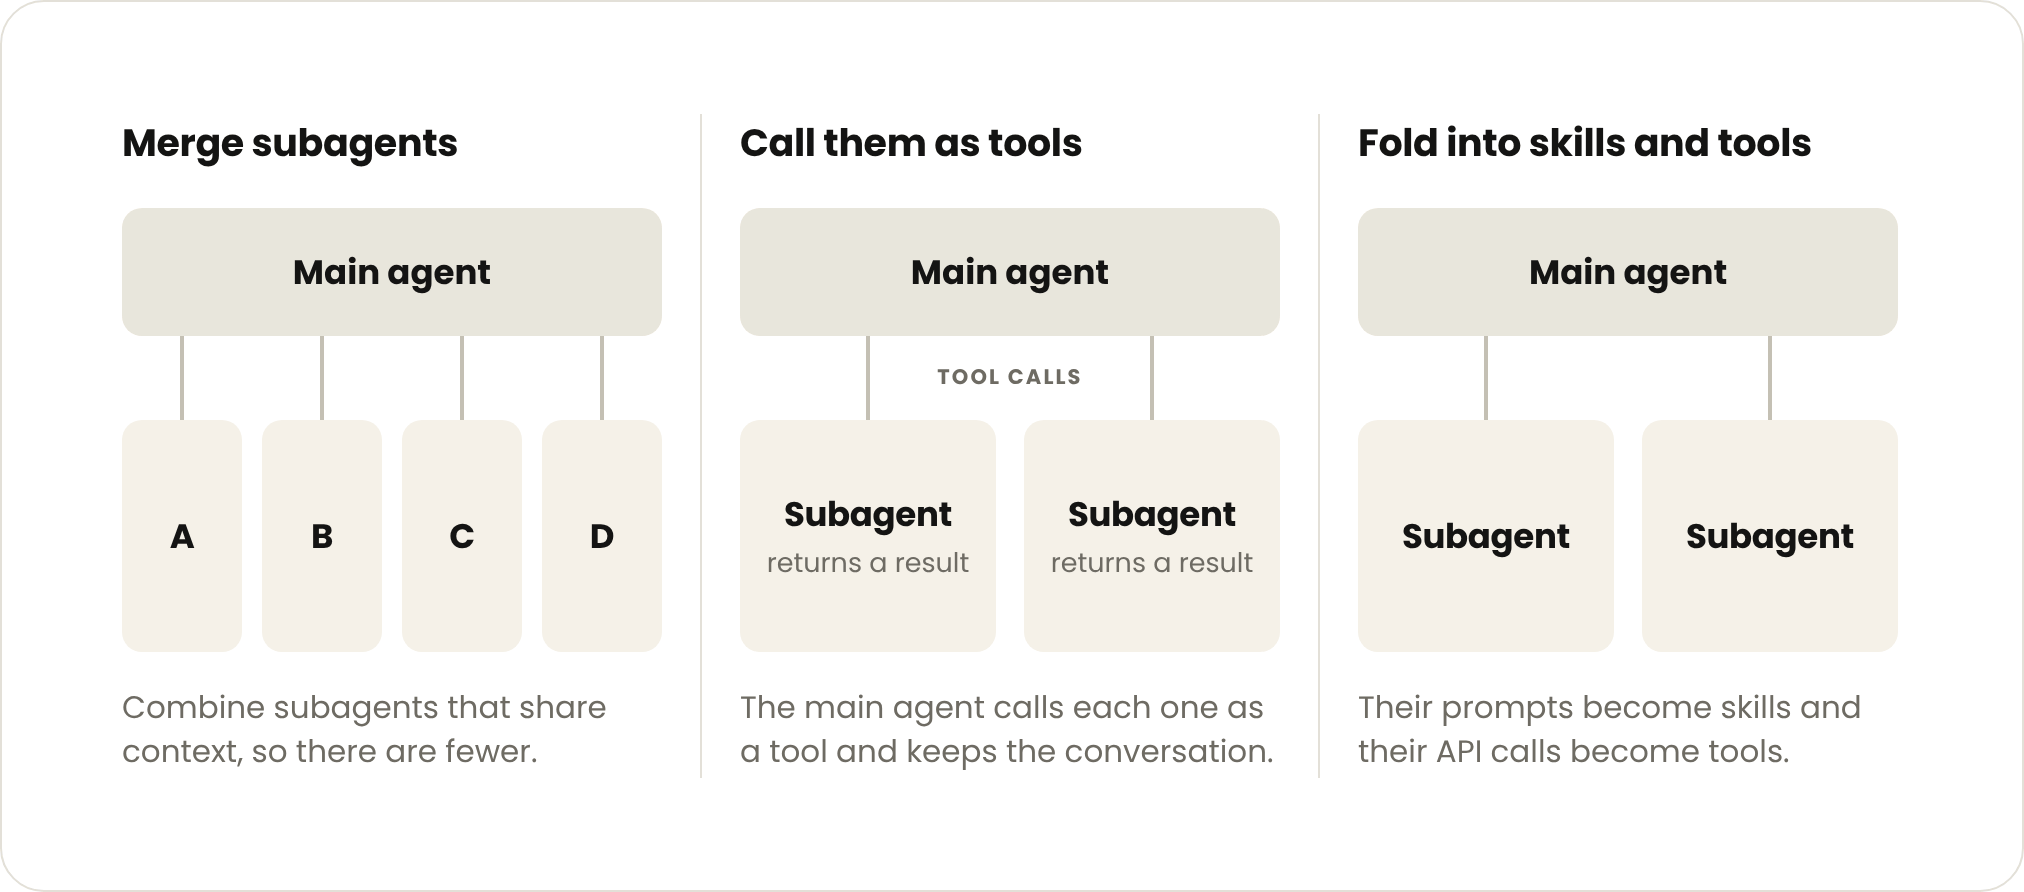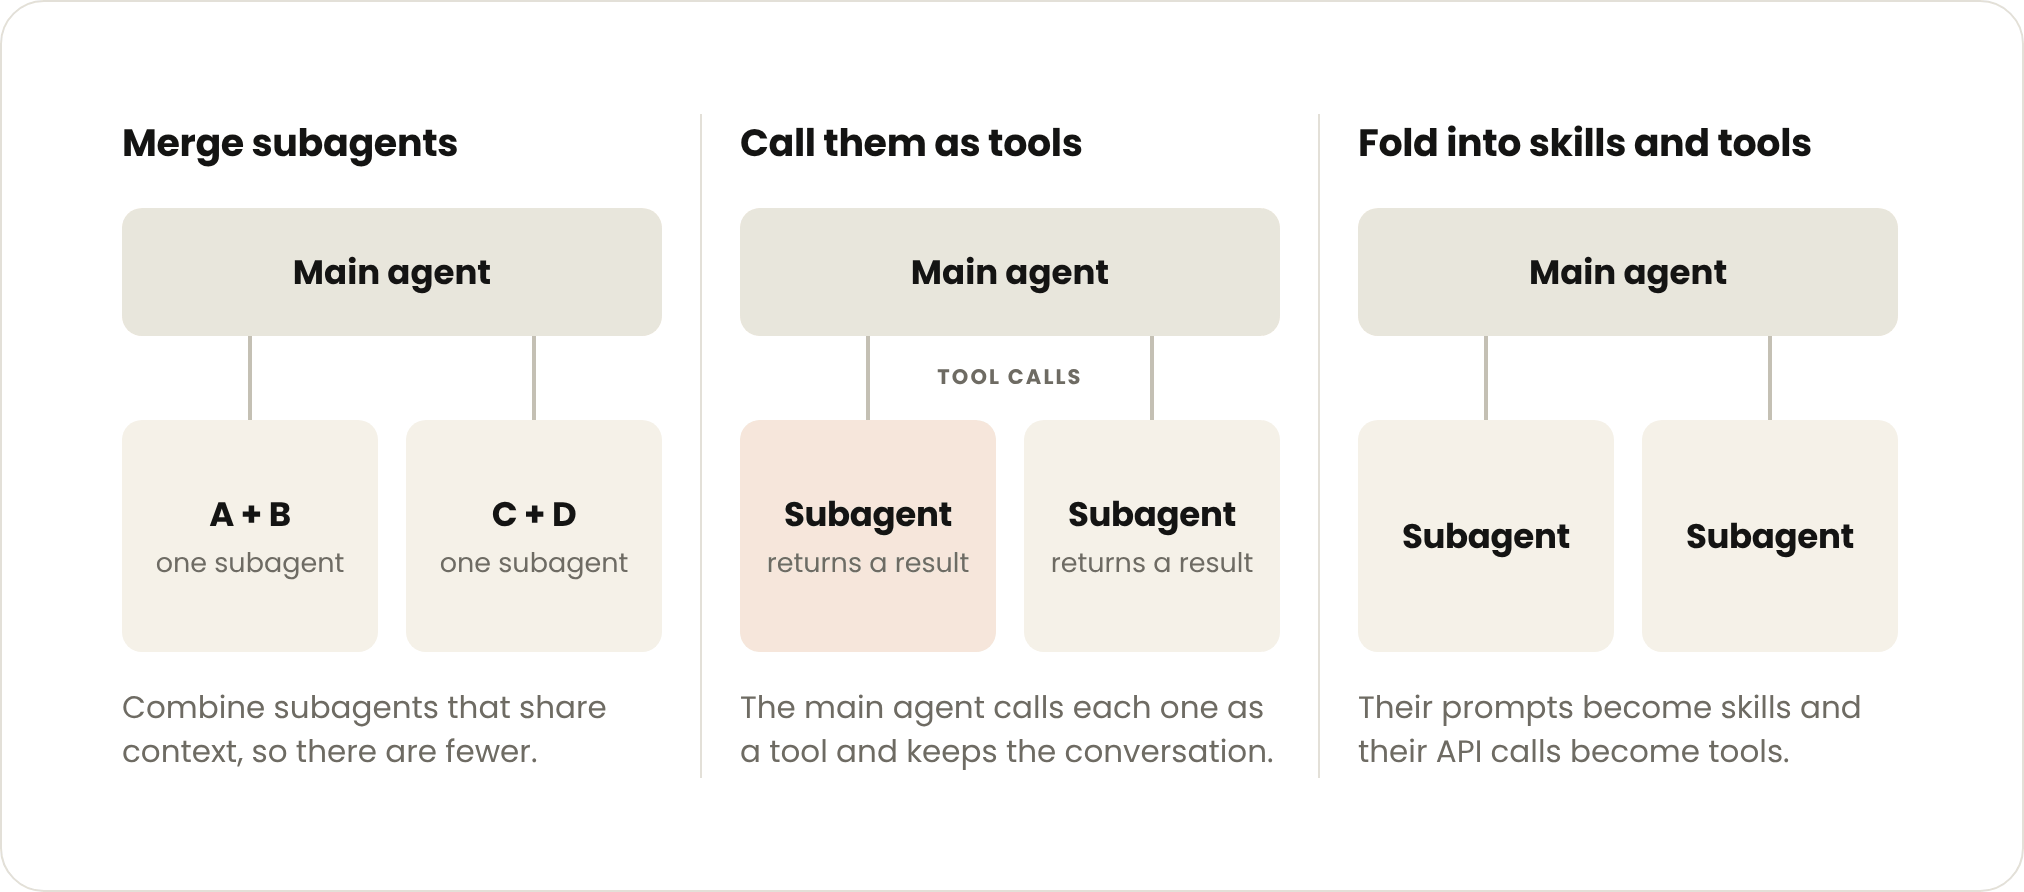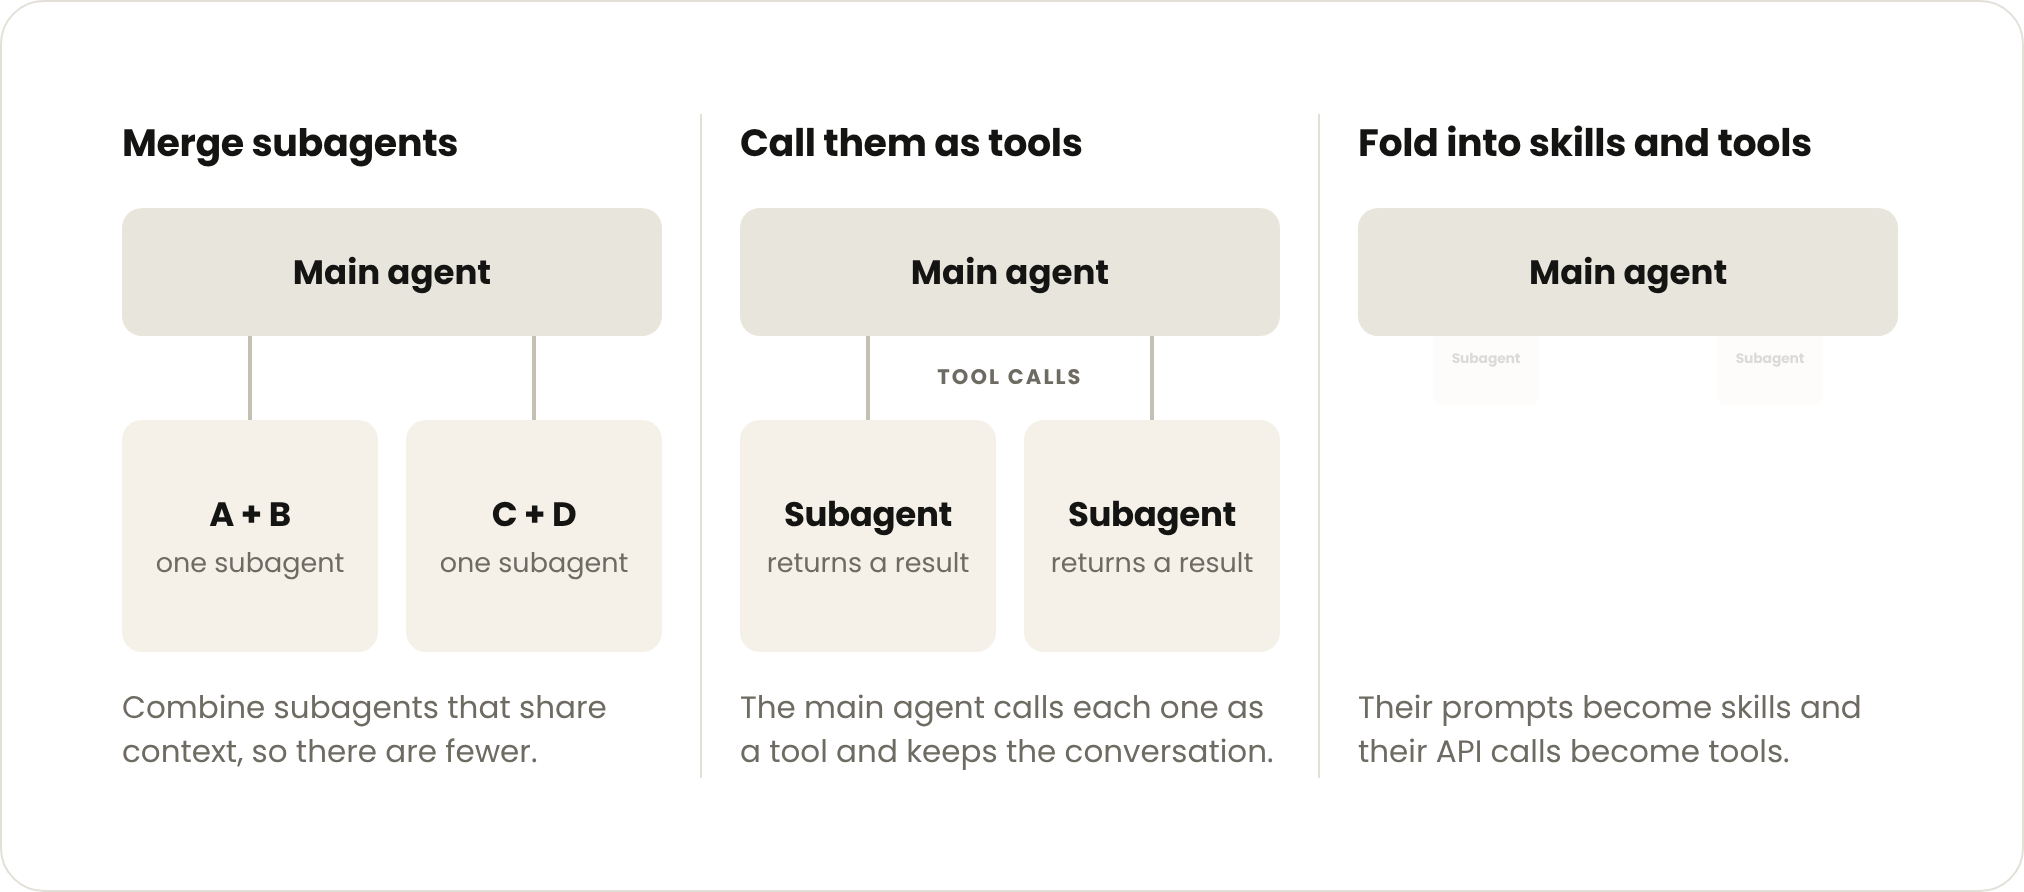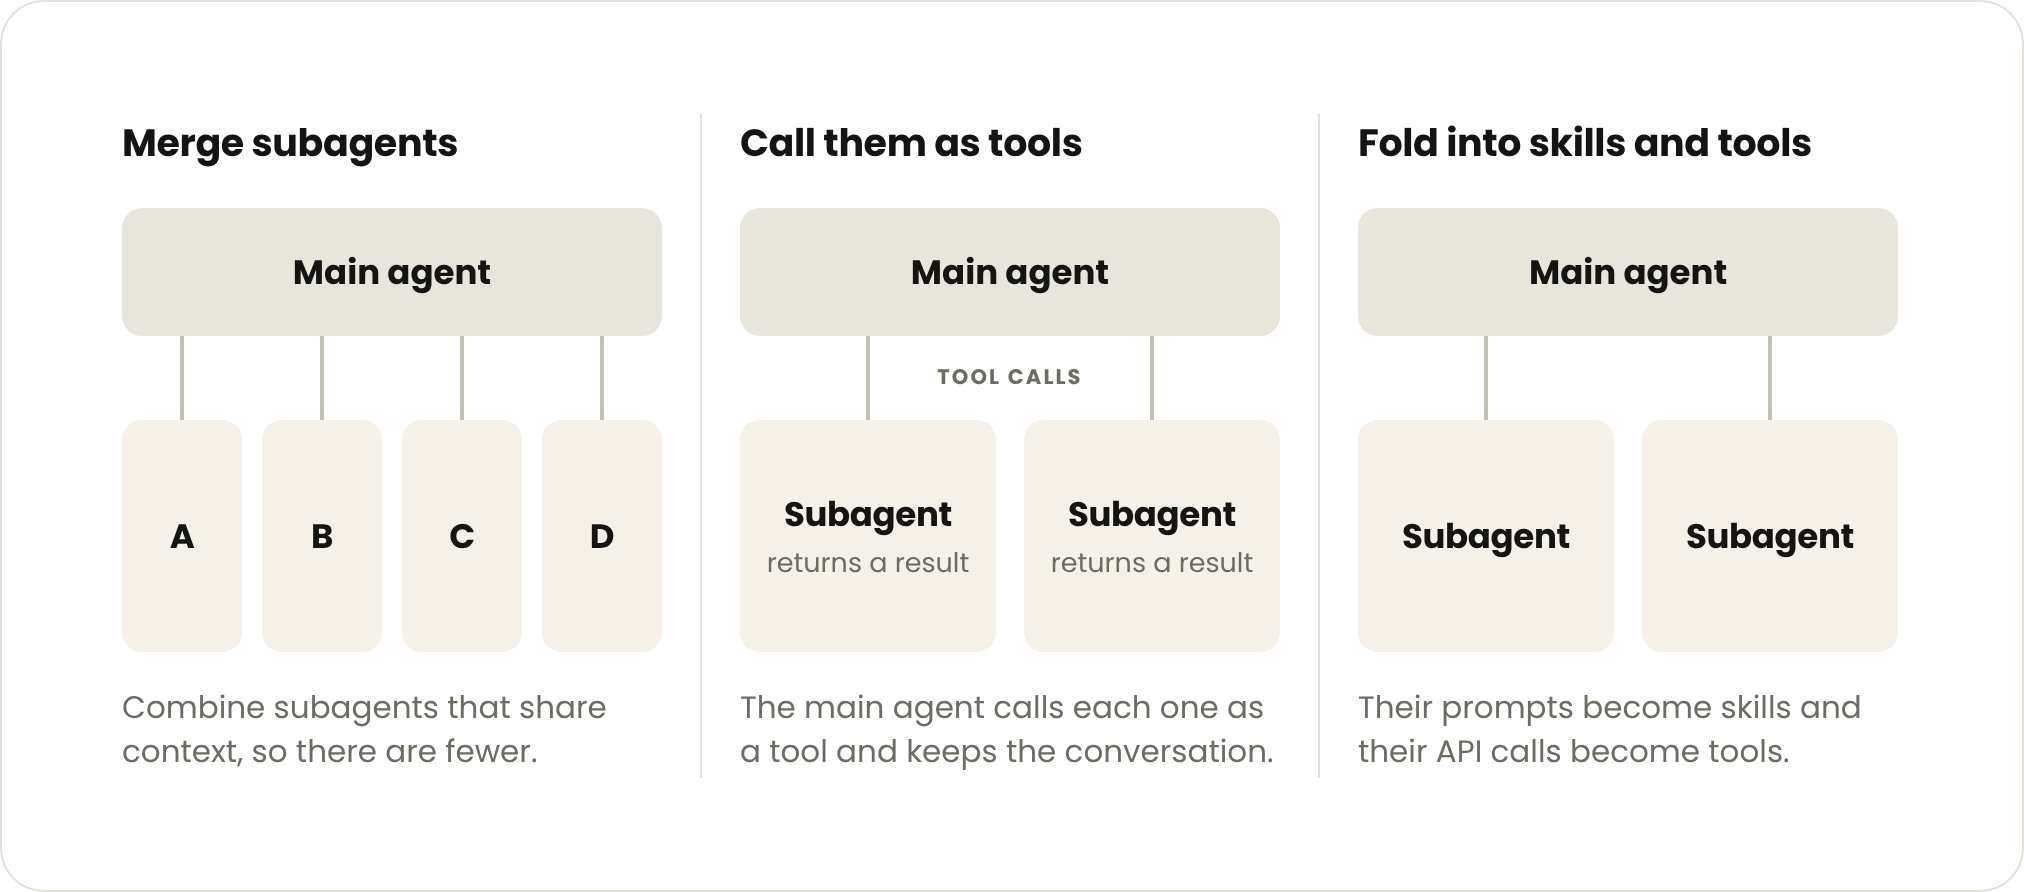
단일 에이전트 루프로 발전하려면 서브 에이전트를 도구와 스킬로 통합하는 작업이 필요합니다. 이를 위해 도메인 서브 에이전트를 병합하거나, 도구로 호출하거나, 스킬과 도구로 대체하여 수행할 수 있습니다.
도메인 에이전트 결합
첫 번째 병합 전에 소규모 엔드투엔드 평가를 구축하세요. 그런 다음 가장 많이 사용되는 서브 에이전트부터 시작하여 공유 컨텍스트를 기준으로 통합합니다.
서로의 출력을 이어받거나, 동일한 데이터를 처리하거나, 자주 함께 호출되는 전문 에이전트를 병합하세요. 예를 들어, 프로덕션 트래픽의 상당 부분이 한 전문 에이전트에 이어 두 번째 전문 에이전트를 호출하는 형태라면, 이는 긴밀하게 결합된 관계이므로 하나의 도메인 에이전트로 병합하기에 적합합니다.
도구로 호출되는 서브 에이전트
위의 세 가지 조건 중 하나에 해당하여 서브 에이전트를 유지하는 경우, 메인 에이전트가 서브 에이전트를 도구로 호출하게 하면 메인 에이전트가 사용자와의 대화를 계속 이어갈 수 있으므로 효과적입니다.
서브 에이전트가 대화를 이어받는 완전한 핸드오프는 서브 에이전트가 사용자와 직접 대화해야 하는 경우에만 권장합니다. 그 외의 모든 작업은 메인 루프 안에서 스킬과 도구로 처리할 수 있습니다.
This will allow you to define a shared response schema for subagents, verify the conclusion against real data with the main agent, and trim the input to any final synthesis step. This is a good first step, as you don’t need to rewrite the subagents. It also gives you a baseline on the task-completion eval before deciding to fold any subagents into the main agent.
그러나 일부 실패 모드는 여전히 남아 있습니다.
- 전문 에이전트마다 고유한 프롬프트, 컨텍스트, 소유자 팀, 평가를 가지고 있습니다.
- 각 호출은 여전히 손실된 요약을 반환합니다.
- 모든 호출은 중첩 모델 루프이므로, 지연 시간이 발생합니다.
스킬과 도구를 통해 서브 에이전트를 메인 에이전트에 통합
각 서브 에이전트의 프롬프트는 스킬로, API 호출은 MCP 도구로 변환하여 서브 에이전트를 하나씩 메인 에이전트에 통합하세요. 서브 에이전트가 포함된 경우와 없는 경우의 평가 성능을 비교합니다. 그런 다음 어느 쪽을 유지할지 판단하세요.
비교할 때는 최종 점수만 확인하지 말고, 어떤 작업의 결과가 바뀌었는지도 살펴보세요. 샘플 지원 에이전트에서 이를 테스트한 결과, 서브 에이전트 하나를 다른 에이전트에 통합하자 지연 시간은 줄었지만 기존에 통과하던 프로세스가 실패하기도 했습니다. 메인 에이전트가 주문 조회 도구를 가지고 있었기 때문에, 배송 전문 에이전트에 배송 날짜를 묻지 않고 스스로 답변한 경우였습니다.
변경하기 전에 매번 평가에 프로덕션 환경에서 함께 실행되는 모든 에이전트 체인과 에이전트가 절대 위반해서는 안 되는 모든 규칙에 대한 작업이 포함되어 있는지 확인하고, 각 작업을 여러 번 실행해야 합니다. 앞서 발생한 문제도 2번의 실행 중 1번에서만 나타났기 때문입니다.
여러 팀이 단일 에이전트에 기여하는 방법
도메인 추론은 지식 베이스, 스킬, MCP 도구에서 불러올 수 있습니다. 개별 팀은 에이전트 대신 스킬과 도구를 담당할 수 있으며, 한 소규모 중앙 팀이 시스템 프롬프트와 엔드투엔드 품질의 소유권을 유지합니다. 여기에는 새로운 스킬, 도구, 평가를 배포하기 전에 검토하는 작업이 포함됩니다.
MCP 도구
에이전트가 작업을 수행하거나, 시스템에서 실시간 데이터를 읽거나, 고정된 형태로 결과를 반환해야 할 때는 도구가 가장 적합합니다. 또한 마이그레이션하는 동안 도구를 활용해 서브 에이전트를 계속 호출할 수도 있습니다. 시스템 프롬프트의 도구 정의가 30~50개를 넘으면 도구 선택의 정확도가 떨어지는 경향이 있으므로, (API당 도구 하나가 아니라) 사용자 의도별로 도구를 그룹화하는 것이 좋습니다.
지연 로딩의 도구 검색을 사용하고, 엄격한 전제 조건은 최소화하며, 필요한 전제 조건은 도구 내부로 옮기세요. 예를 들어, Y가 X의 결과물을 필요로 하면, Y의 도구가 이를 확인한 뒤 모델이 수행할 수 있는 지침을 반환합니다. 사용자별 권한도 동일하게 처리합니다. 각 도구는 호출한 사용자가 조회하거나 수행할 수 있는 작업을 확인하고, 권한이 없는 경우 모델이 읽을 수 있는 간단한 거부 메시지를 반환합니다. 따라서 권한 수준별로 별도의 에이전트를 두지 않고도 하나의 루프로 서로 다른 액세스 권한을 가진 사용자를 지원할 수 있습니다.
Skills
스킬은 에이전트가 팀의 작업 방식, 즉 기존 전문 서브 에이전트의 프롬프트에 담겨 있던 단계, 규칙, 판단 기준 등을 알아야 할 때 적합합니다.
확장하는 스킬 라이브러리에 대한 저희의 접근 방식은 유지 관리 작업을 스킬을 작성자에게 맡기는 것입니다. Claude는 다른 스킬을 구축하고, 테스트하며, 정리할 수 있는 스킬을 활용해 번거로운 작업을 대신 처리할 수 있습니다.
스킬의 무분별한 증가를 방지하려면 팀별 DRI가 해당 스킬을 소유하도록 하고, 각 스킬이 잘 설계되어 있으며, 서로 명확히 구분되고, 적절한 평가와 함께 제공되도록 할 수 있습니다.
- /skill-creator를 사용하면 처음부터 구조가 잘 갖춰진 새 스킬을 작성하고, 기존 스킬을 점검해 정리하며, 중복을 제거하고, 재구성할 수 있습니다.
- /skill-doctor를 사용하면 라이브러리의 각 스킬에 드는 비용과 실제 사용 빈도를 확인하고, 불필요한 스킬을 삭제할 수 있습니다.
지식 베이스
지식 베이스는 에이전트가 가끔 필요로 하는 참조 자료에 적합합니다. 사실 정보와 참조 자료(정책, 지표 정의, 제품 사양)는 모델이 호출하는 검색 또는 조회 도구를 통해 제공하거나, 스킬 내부의 참조 파일로 포함할 수 있습니다. 코드가 이 컨텍스트를 검색하여 프롬프트에 붙여 넣는 방식은 피해야 합니다.
이 작업을 가속화하는 도구
최근에 위에 언급한 대부분의 작업을 지원하는 Claude API 스킬 세트를 출시했습니다. 저희의 마이그레이션 키트는 이러한 스킬을 하나의 가이드형 워크플로로 연결하여 멀티 에이전트 시스템을 평가하고 단일 에이전트 루프로 전환할 수 있도록 지원합니다. 실제 환경에서 실행하기 전에 시도할 수 있는 데모가 포함되어 있습니다:
- /claude-api build-eval: 중앙 팀이 소유하는 첫 번째 엔드투엔드 평가 세트를 만들거나, 각 팀이 자체 스킬과 함께 제공하는 소규모 평가 세트를 만드는 데 도움이 됩니다.
- /claude-api prompt-audit: 프롬프트, 스킬, 도구 설명에서 이전 모델용으로 작성된 지침을 찾아 표시하고, 수정 사항을 비교 형식으로 제시할 수 있습니다. 시스템 프롬프트에서 이 기능을 실행하면 이전 모델을 위해 추가되었지만, 지금은 에이전트의 속도를 늦추거나 유연성을 낮추는 규칙을 찾을 수 있습니다. 각 팀의 DRI도 자체 스킬과 도구 설명을 대상으로 이를 실행할 수 있습니다.
- /claude-api hillclimb: 기존 평가를 기준으로 앱을 반복적으로 개선할 수 있습니다. 이 기능은 '통합과 유지'의 비교(하나의 서브 에이전트를 스킬과 도구로 통합한 후, 스킬과 도구 설명을 반복적으로 개선하게 하여 통합된 버전이 서브 에이전트와 동등하거나 더 우수한지 확인)뿐만 아니라 시스템 프롬프트 개선에도 활용할 수 있습니다.
- /claude-api cost-optimize: 호출이 어디에서 발생하는지 분석하고, 프롬프트 캐싱, 불필요한 입출력 토큰 축소, 노력 수준 조정, 모델 선택 등의 옵션을 통해 한 번에 하나씩 변경하며 비용 절감 방안을 찾습니다. 이는 특정 설계의 비용과 지연 시간을 줄이는 데 도움이 될 수 있습니다.
모델이 발전하면서, 모델을 최적으로 활용하는 방법에 대한 이해와 모범 사례에 관한 지침도 발전합니다. 따라서 특정 아키텍처보다는 그 이면의 원칙이 더 중요합니다. 바로, 측정하고, 한 번에 하나씩 변경하며, 효과가 검증된 것은 유지하는 것입니다.
이는 그러한 사례 중 하나입니다. 모델의 역량이 강화되고 에이전트의 실행 시간이 길어지면서, 더 많은 서브 에이전트를 스킬과 도구로 대체할 수 있습니다. 하지만 이러한 전환을 한 번에 할 필요는 없습니다. 소규모 엔드투엔드 평가를 구축하고, 서브 에이전트 하나를 통합한 후, 통합된 버전의 점수가 더 낮은 경우에만 서브 에이전트로 유지합니다. 그리고 이 과정을 반복하세요.