Erstellung von Agenten: Wann Subagenten in Ihre Hauptagentenschleife integriert werden sollten
Bei der Erstellung von Agenten auf der Claude Platform kann die Verwendung von weniger Subagenten zugunsten von schrittweise offengelegtem Kontext und bereitgestellten Tools die Qualität bei niedrigeren Kosten und geringerer Latenz verbessern. Hier erfahren Sie, wann und wie Sie migrieren sollten.
Wenn Sie einen Agenten in der Claude Platform entwickelt haben, der mehrere Subagenten enthält, prüfen Sie mithilfe unseres Migrationskits, bei welchen es sinnvoll sein könnte, sie in die Hauptagentenschleife zu integrieren. Es führt einen geführten Workflow aus, um Ihre Muster zu identifizieren, Alternativen zu bewerten und den besten Ansatz zu überprüfen. Er enthält eine Demo, die Sie in einem Simulationssystem testen können, bevor Sie ihn für Ihren Agenten ausführen.
Subagenten – Agenten mit eigenem Kontextfenster, eigenen Tools und eigenen Anweisungen, die von einem Koordinator orchestriert werden – bilden eine Kernkomponente des Agentendesigns. Sie eignen sich gut für die Verifizierung, parallele Abläufe und modulare Rechtevergabe. Wir setzen sie in vielen unserer eigenen Agenten ein, die wir mit der Claude Platform entwickeln, beispielsweise in unserem Recherchesystem mit mehreren Agenten.
Vor kurzem hat das Applied AI-Team jedoch ein Muster bei Bereitstellungen von Unternehmensagenten festgestellt, die davon profitiert haben, Router, Planer und Domänensubagenten in die Hauptagentenschleife einzubinden. In unseren Vergleichen über mehrere Unternehmensbereitstellungen hinweg hat ein einzelner Agent mit Skills sowohl das One-Prompt-for-Everything-Design als auch das Subagentendesign hinsichtlich der Qualität häufig übertroffen – oft bei niedrigeren Kosten und geringerer Latenz pro Aufgabe.
Ein Unternehmen stellte beispielsweise fest, dass das Dutzend spezialisierter Subagenten innerhalb seines kundenorientierten Agenten es schwierig machte, ein konsistentes, markengerechtes Erlebnis aufrechtzuerhalten, und zusätzliche Latenz verursachte, die sich negativ auf das Nutzererlebnis auswirkte.
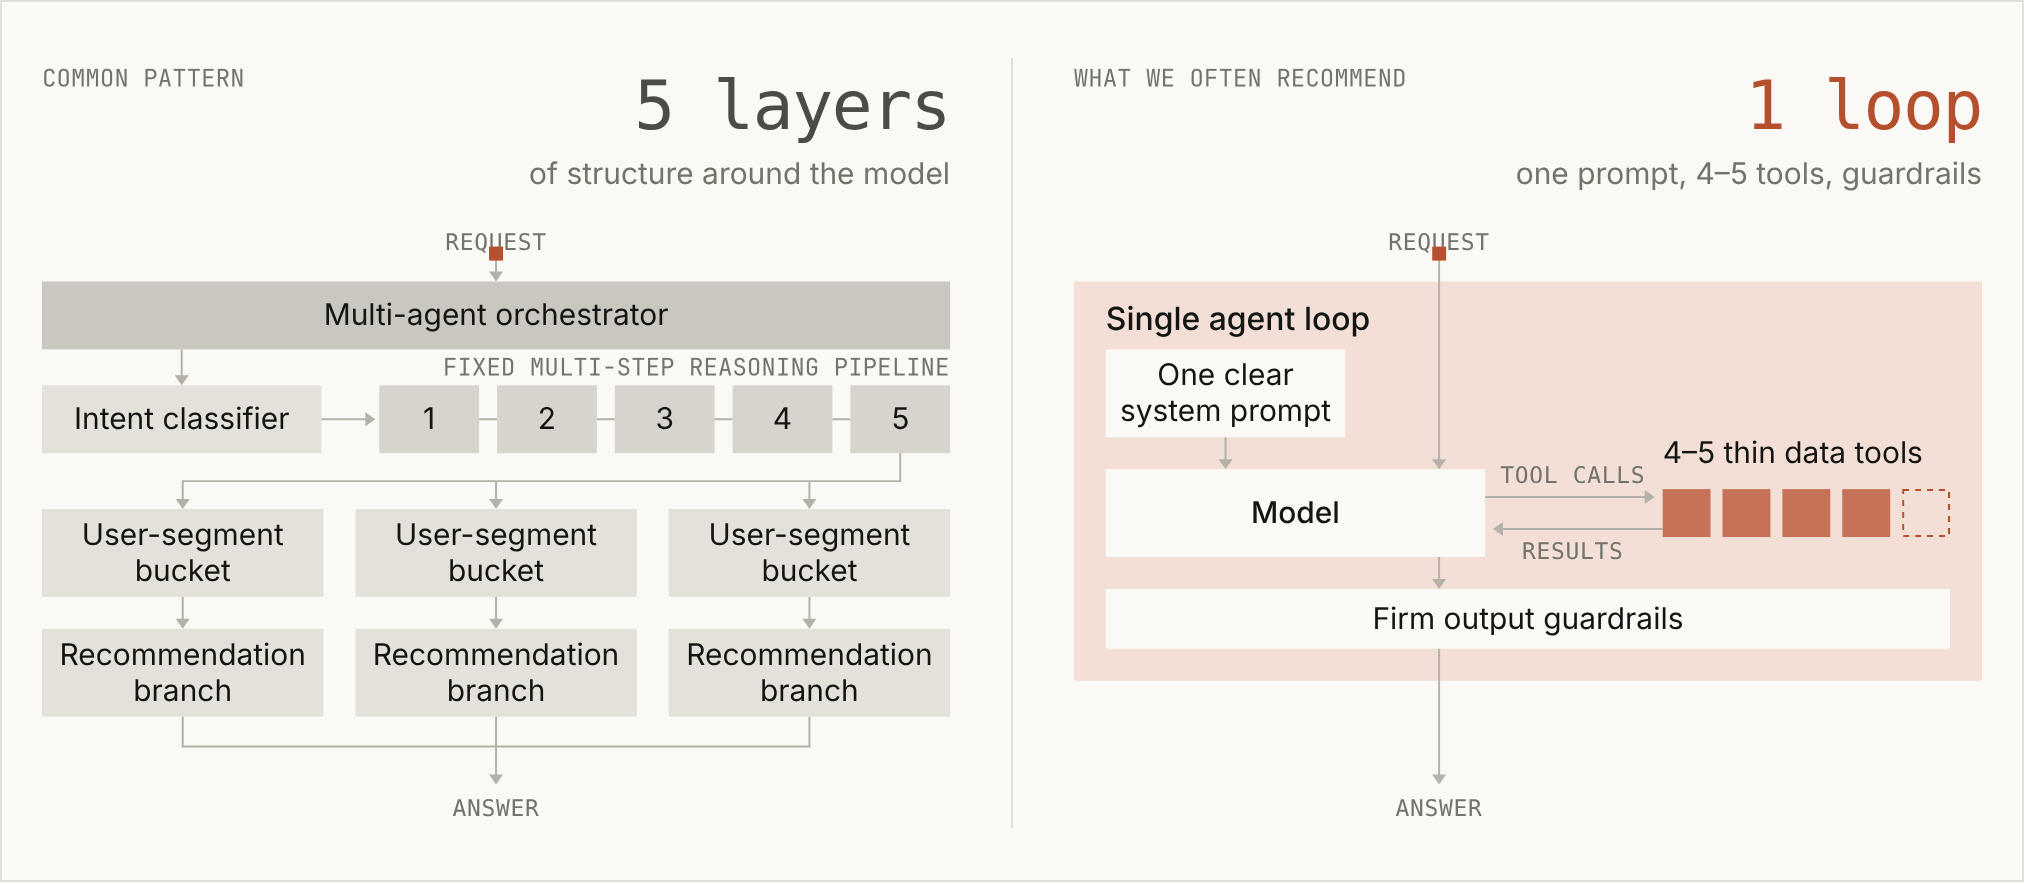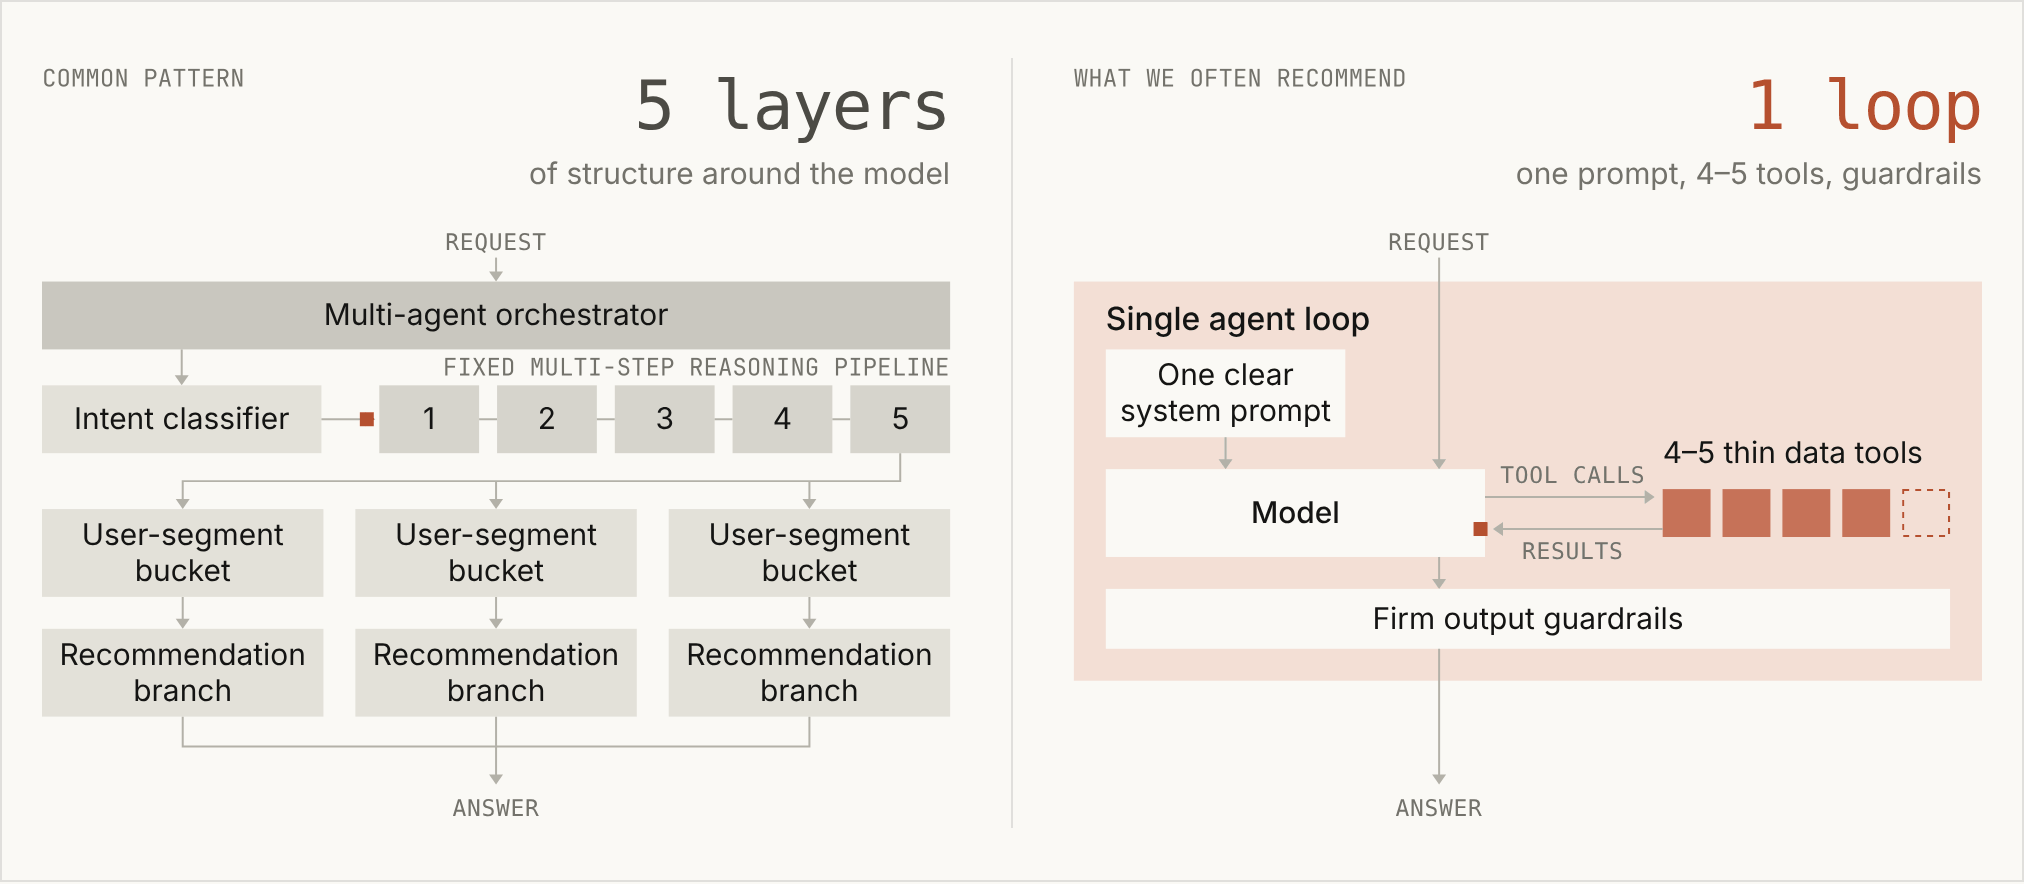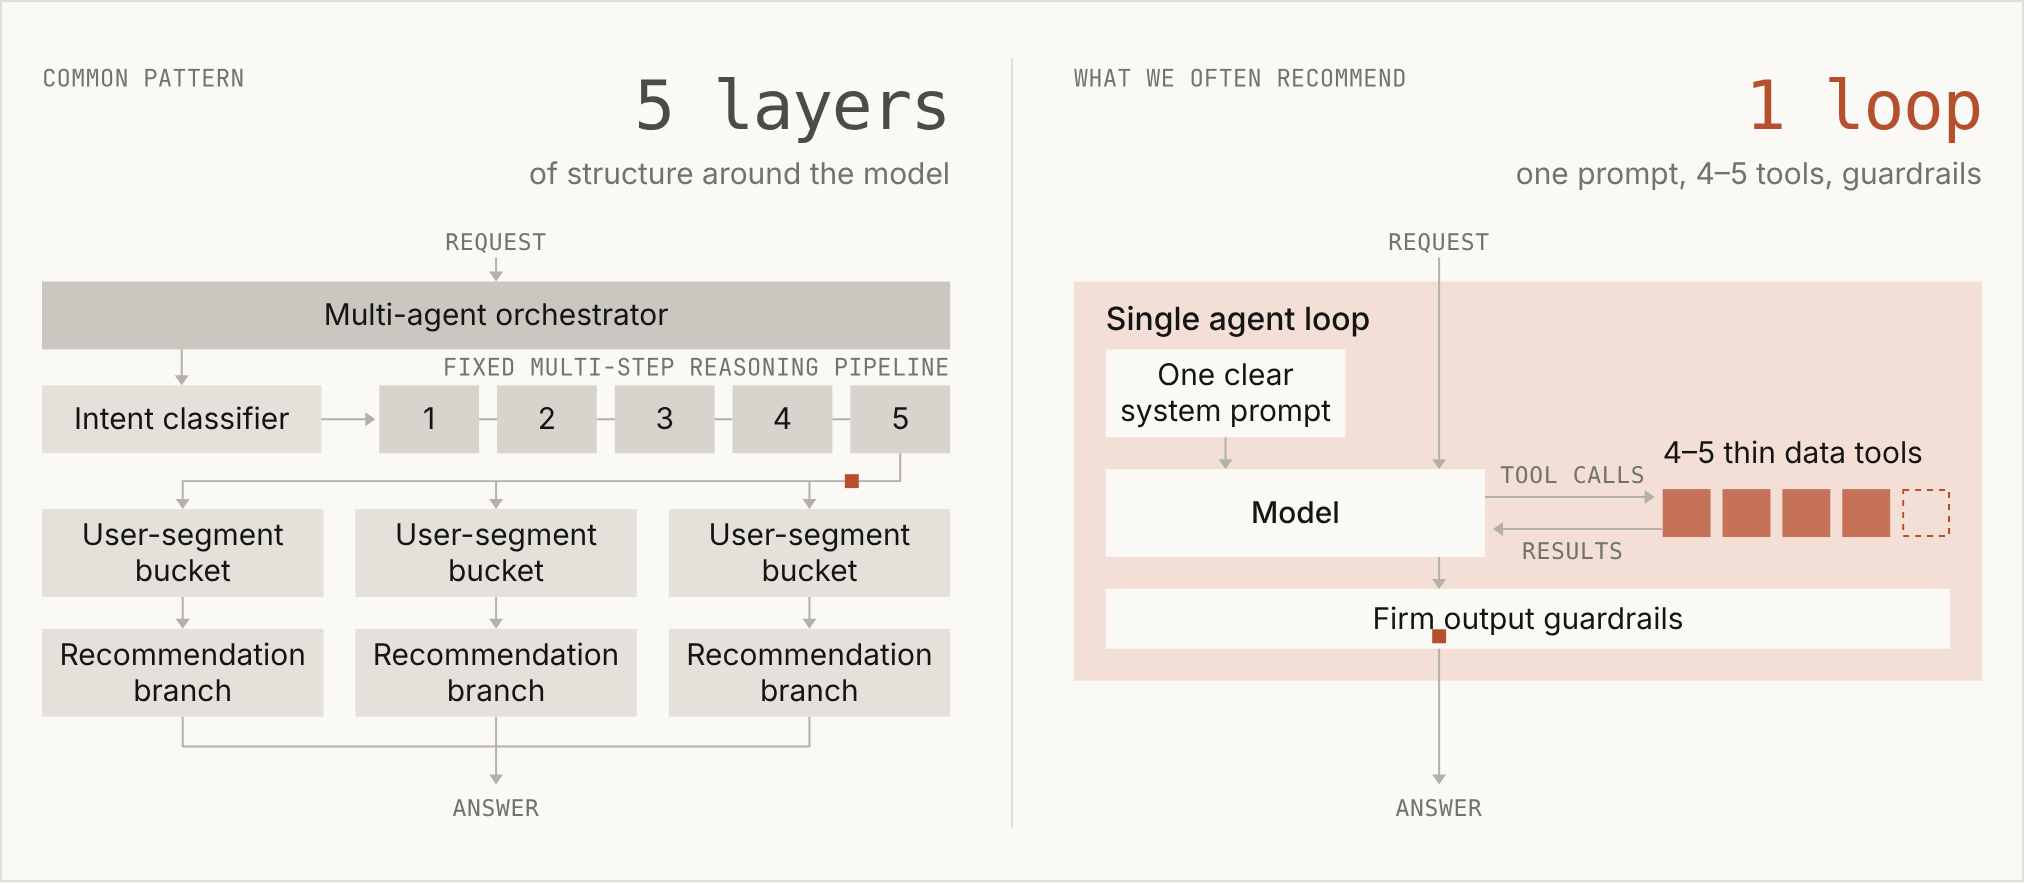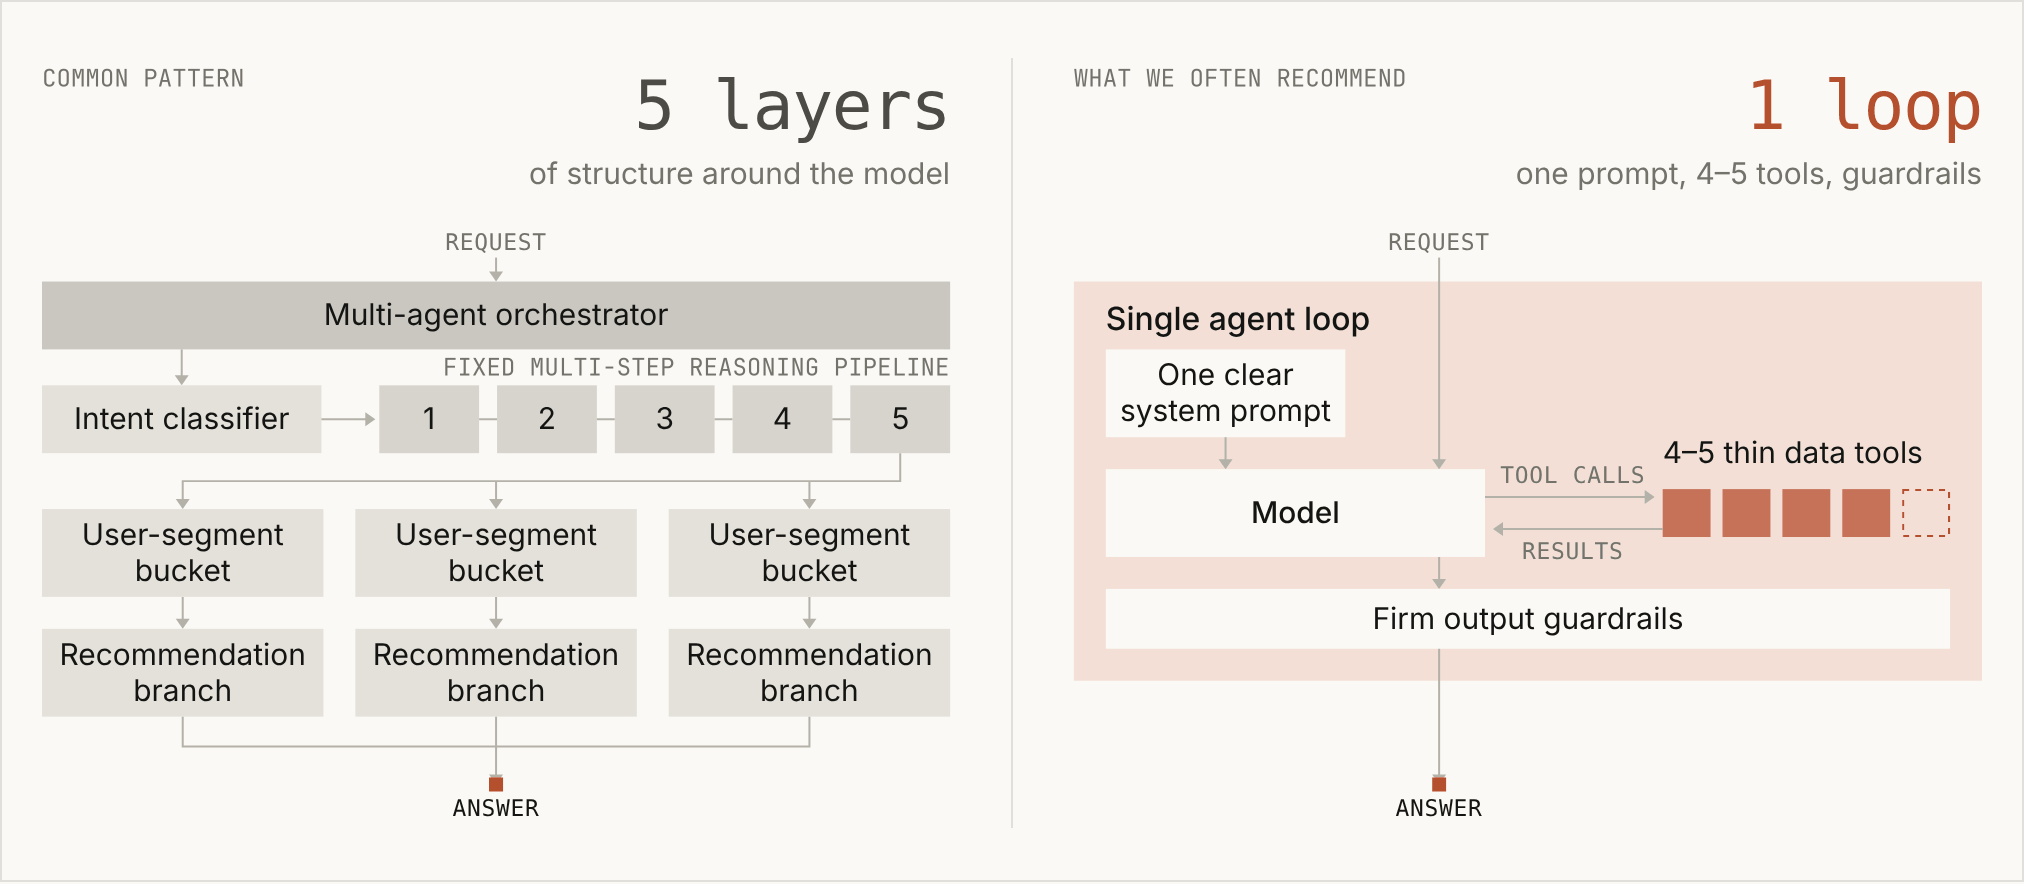
Wir sehen auch oft vorgeschlagene Agentendesigns, die einer vertrauten Progression folgen: ein Intent-Klassifizierer, eine feste, mehrstufige Reasoning-Pipeline, Nutzersegment-Buckets, separate Empfehlungszweige und darüber ein Multiagentenorchestrator.
In diesen Fällen lautet das Feedback oft, dass ein Großteil dieser Struktur Arbeit erledigte, die das Modell nicht mehr benötigte, und dass ein klarer Systemprompt, 4 bis 5 schlanke Datentools und strikte Leitplanken für die Ausgabe den größten Teil des Anwendungsfalls abdecken würden.
Um es klar zu sagen: Subagenten haben nach wie vor ihre Berechtigung, auch an vorderster Front bei Forschungsarbeiten. Greifen Sie darauf zurück, wenn:
- sich die Leistung einer einzelnen Agentenschleife durch aufgeblähten Kontext messbar verschlechtert oder
- mehrere Aufgaben parallel mit neuen Kontextfenstern bearbeitet werden müssen, die nach Abschluss der Aufgabe verworfen werden können oder
- ein einzelner Agent Schwierigkeiten bei der Wahl geeigneter Tools hat oder sich widersprüchliche Anweisungen im Systemprompt befinden.
Aber zu oft sehen wir, dass Unternehmen jedem Team oder jeder Problemart einen eigenen Subagenten zuweisen, wobei die Agentenarchitektur zu einer Kopie ihres Organigramms wird (Conways Gesetz in Aktion).
In diesem Beitrag erläutern wir, wann Sie in Erwägung ziehen sollten, Subagenten in Ihre Hauptagentenschleife zu integrieren – mit Best Practices, die wir bei der Entwicklung von Agenten in großen Unternehmen gewonnen haben.
Fehlermodi bei der Agentenentwicklung in großen Unternehmen
Unternehmen möchten oft einen Agenten entwickeln, der mehrere Produkte und Funktionen in einer einzigen Kundenschnittstelle vereint.
In der Regel liegt jede Funktion in der Hand eines separaten Teams. Daher lassen Unternehmen jedes einzelne Team zunächst seinen eigenen Agenten entwickeln, bevor ein zentrales Plattformteam darüber einen Orchestrator aufsetzt. Dadurch können verschiedene Strukturen entstehen, darunter eine Orchestrator-Subagent-Struktur oder ein einzelner Agent, bei dem bestimmte Agenten als MCP-Tools bereitgestellt werden.
Es scheint die einfachste Lösung zu sein, führt jedoch unmittelbar zu mehr Komplexität in folgenden Bereichen:
- Kontextmanagement: Sie müssen entscheiden, welcher Kontext zwischen den Agenten ausgetauscht wird, und verlieren oft Details beim Hin und Her.
- Wildwuchs an Subagenten: Jedes Team stellt seinen eigenen Subagenten bereit, sodass Unternehmen am Ende Hunderte von sich überschneidenden Subagenten ohne durchgesetzte Standards und ohne klare Verantwortliche haben.
- Der Frankenprompt: Jedes Team fügt dem Systemprompt einen Satz hinzu, was zu widersprüchlichen Regeln und einer inkonsistenten Tonalität führt.
- Ungeprüfte, zu stark lokalisierte Evaluierungen: Jeder fügt eigene Evaluierungen hinzu, die übermäßig auf die eigene Teilaufgabe optimiert sind. Niemand ist für das Ganze verantwortlich oder pflegt es, und die Führungsebene trifft Entscheidungen auf Grundlage verwässerter, übermäßig lokalisierter Ergebnisse.
- Latenz: Die komplexe Architektur mit mehreren Agenten erhöht die Latenz. Ein Kunde, der seinen Multiagenten-Harness mit einer Einzelagentenschleife verglich, stellte bei Letzterer eine etwa doppelt so schnelle Laufzeit fest.
Rückgriff auf eine Agentenschleife mit progressiver Offenlegung
Das oben beschriebene Orchestrator-Subagent-Design ist ein vernünftiger Ansatz zur Koordination von teamübergreifend entwickelten Spezialisten, aber oft kann ein effektiverer Ansatz darin bestehen, Kontext über Skills offenzulegen und Tools über die Toolsuche schrittweise offenzulegen. Mit anderen Worten: Der Agent sieht kurze Beschreibungen der Skills und Tools, die nur bei Bedarf vollständig geladen werden.
Es gibt drei Gründe, warum dieser Ansatz sinnvoll sein kann:
- Der gemeinsame Kontext führt zu besseren Antworten: Bei zeitintensiveren Agenten möchten wir, dass sich der Kontext mehrerer verschiedener Aufgaben im Hauptkontextfenster befindet. Ein Agent, der die Ergebnisse aller vorherigen Schritte gesehen hat, kann sie miteinander verknüpfen, was zu umfassenderen Ergebnissen und besseren Erkenntnissen führt als eine Reihe von Zusammenfassungen, die von Subagenten zurückgegeben werden. Es bedeutet auch weniger Kontextfenster und weniger verlustbehaftete Übergaben.
- Progressive Offenlegung verhindert eine Aufblähung des Kontexts: Diese Technik ermöglicht es Teams, einzelne Agenten zu entwickeln, die eine Vielzahl von Aufgaben erledigen können, ohne dass der gesamte Kontext sofort in einen langen Systemprompt geladen werden muss. Damit ist der Hauptgrund, warum Teams die Arbeit bisher auf verschiedene Subagenten aufgeteilt haben, beseitigt. Tatsächlich haben wir den Systemprompt von Claude Code für fortgeschrittenere Modelle um über 80 % reduziert, was auch Kürzungen im Zusammenhang mit der progressiven Offenlegung von Skills und Tools beinhaltete.
- Modelle sind leistungsfähiger: Ab Opus 4.5 können Modelle in einer einzigen Schleife weitaus mehr Aufgaben erledigen, als die meisten Teams erwartet hatten. Bei Opus 5.5 und Fable 5.1 können Sie das Denken nicht deaktivieren, und neuere Modelle beschreiben zunehmend ihren Fortschritt und überprüfen ihre Arbeit fortlaufend, was einige Harness-Elemente überflüssig macht. Mit jedem neuen Modell können Sie einen größeren Teil der Entscheidungsfindung aus dem Harness in das Modell selbst verlagern. Eine einfachere Schleife lässt sich zudem leichter auf das nächste Modell migrieren. Bei Migrationen, bei denen wir Kunden unterstützt haben, waren es oft starre Strukturen mit mehreren Agenten, die das neue Modell daran gehindert haben, mehr von der Arbeit zu übernehmen.
Das Design einer einzelnen Agentenschleife erfordert Disziplin: einen sorgfältig verwalteten Systemprompt, Skill- und Toolbeschreibungen, die zum richtigen Zeitpunkt ausgelöst werden, sowie den bewussten Umgang mit Kontextfenstern, Gedächtnis und Notizen. In den folgenden Abschnitten geht dieser Artikel näher auf einzubeziehenden Überlegungen bei Migration und Design ein.
Ein zentrales Team sollte für die End-to-End-Qualität sowie den Systemprompt verantwortlich sein und jedes neue Tool sowie jede Evaluierung überprüfen, bevor diese bereitgestellt werden. Das zentrale Team klein zu halten, trägt zu schnellen Iterationen bei und senkt die Koordinationskosten in einem großen Unternehmen.
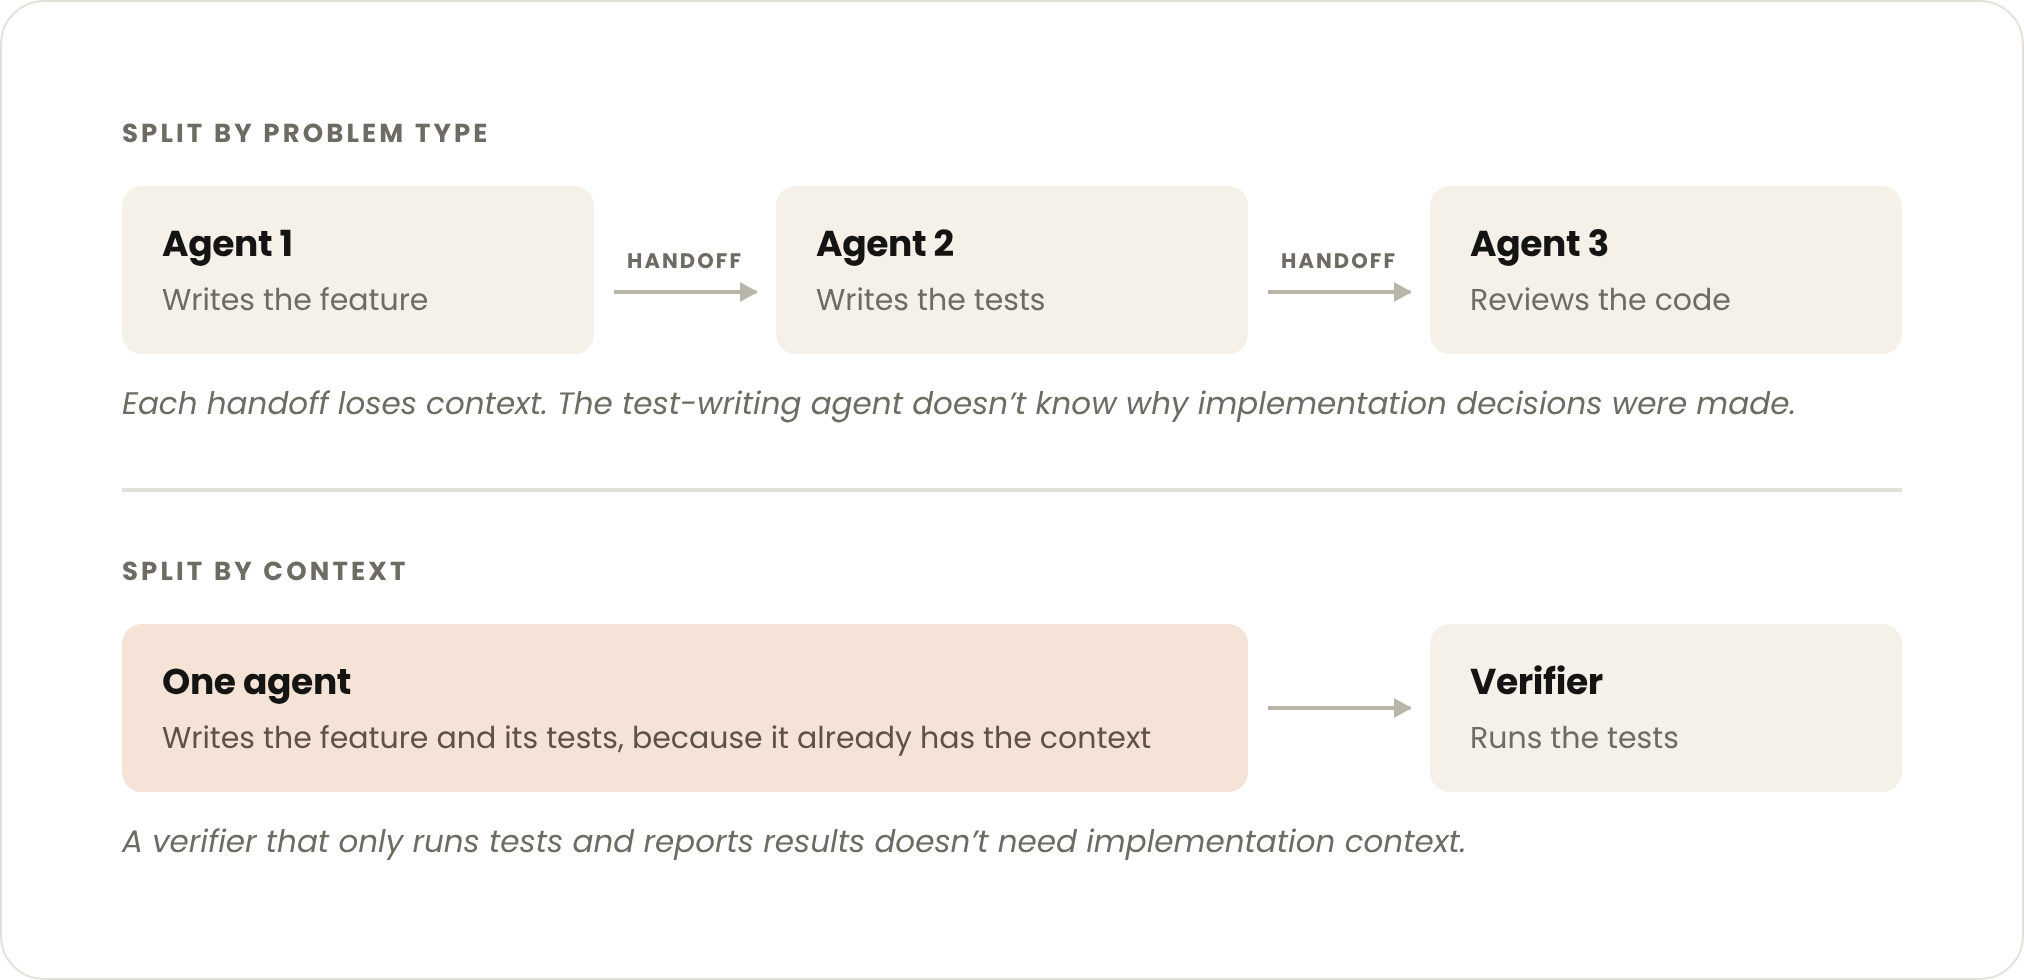
Wenn Sie sich für den Multiagentenansatz entscheiden, beginnen Sie mit dem einfachsten Muster (Generator-Verifier, Orchestrator-Subagent oder ein anderes), das funktionieren könnte. Zerlegen Sie Grenzen effektiv durch Unterteilung nach Kontext: Geben Sie jedem Subagenten eine Aufgabe, die wenig vom Rest des Systems benötigt, und lassen Sie ihn ein kompaktes Ergebnis zurückgeben (gute Kandidaten sind unabhängige Recherchepfade, separate Komponenten mit sauberen Schnittstellen oder Black-Box-Verifizierung). Wenn Agenten nach Problemtyp eingeteilt werden, spielen sie ein „stille Post“, bei dem sie Informationen hin- und herverschieben, wobei jede Übergabe die Genauigkeit verschlechtert.
So integrieren Sie Subagenten in die Schleife des Hauptagenten
Viele Teams haben bereits einen Orchestrator und eine Reihe spezialisierter Agenten im Produktivbetrieb. Wir empfehlen, auf das folgende Design mit einer einzelnen Schleife hinzuarbeiten:
- Ein Modell und ein Kontextfenster, die eine offene Toolschleife ausführen, wobei Grenzen (Runden- und Kostenbudgets, Schreibgatter) im Harness festgelegt sind.
- In jeder Runde gibt das Modell einen Batch von Toolaufrufen aus. Das Harness führt sie parallel aus und gibt die Rohergebnisse an dasselbe Modell zurück, das über den nächsten Schritt entscheidet: einen weiteren Batch, eine Frage an den Nutzer oder eine Antwort.
- Die Schleife endet, wenn das Modell antwortet oder ein Budget erreicht wird. Eine Ziel- oder Verifizierungsprüfung kann optional nach der Antwort ausgeführt werden.
- Das Modell schreibt seinen Plan in der ersten Runde in den Kontext und überarbeitet ihn, sobald Ergebnisse eingehen. Dies ist der wichtigste Unterschied zum Setup mit Orchestrator und spezialisierten Agenten: Das Modell, das den Plan aufstellt, ist auch dasjenige, das ihn ausführt, sodass es den Plan während des laufenden Vorgangs ändern kann.
- Der Kontext wird immer noch geladen und vom Agenten selbst verwaltet:
- Ein Codeschritt, der den Plan anhand eines Regelkatalogs neu schreibt, ist nicht mehr erforderlich, da das Modell über jeden Schritt entscheidet.
- Bestell- und Domänenvorgänge werden in Skills. verschoben.
- Harte Grenzen (Validierung, Freigabeprozesse) und alles andere, was während eines Gesprächs auftaucht (z. B. Speicherzugriffe), werden in die Tools verlagert.
- Code kann weiterhin verwendet werden, um alles Günstige und fast immer Relevante (z. B. einen Schritt zur Auflösung von Entitäten) zu laden sowie um alle mechanischen Teile (Payload-Konstruktion, Stream-Parsing, Fortsetzung einer Klärung) innerhalb von Tools abzuwickeln, die von der Schleife aufgerufen werden.
Dieses Einzelschleifendesign unterstützt auch den Endzustand, auf den viele Teams hinarbeiten (ein Agent, der die übergeordneten Ziele eines Nutzers versteht und in dessen Namen handelt), da es alles, was der Agent gelernt hat, in einem Kontext zusammenhält.
Die folgenden Vorschläge zeigen, wie ein Team schrittweise von einem Multiagentensystem zu einer Einzelagentenschleife gelangen könnte und wie mehrere Teams dabei weiterhin zu diesem Agenten beitragen können.
Bewertungen der Aufgabenerfüllung
Der erste Schritt besteht darin, einen Evaluierungssatz zu erstellen, mit dem Sie feststellen können, ob Sie einen Subagenten in die Schleife des Hauptagenten integrieren sollten. Die Evaluierungsstruktur, die sich bewährt hat, besteht aus einem gemeinsamen End-to-End-Satz, den ein zentrales Team verantwortet, sowie kleineren Evaluierungssätzen, die das jeweils verantwortliche Team mit jedem Skill bereitstellt. Bereits eine Reihe von zehn goldenen Beispielen reicht aus, um loszulegen.
Die Bewertung der finalen Nachricht des Agenten anhand eines Bewertungsrasters ist ein guter Ausgangspunkt, um die Antwortqualität nachzuverfolgen. Solange Sie noch einen Orchestrator haben, sollten Sie auch die Genauigkeit des Routings nachverfolgen (wurde der richtige Subagent ausgewählt?). Sobald ein Subagent eingebunden ist, überprüfen Sie stattdessen, ob der Agent den richtigen Skill geladen bzw. das richtige Tool aufgerufen hat. Es ist hilfreich, im Laufe der Zeit auf Evaluierungen bei Aufgabenerfüllung hinzuarbeiten, da diese beim Vergleich von Architekturen am wichtigsten sind.
Dies kann in Umgebungen komplex sein, in denen sich interne Systeme nur schwer replizieren lassen und die Nutzerinteraktion nur schwer zu simulieren ist. Ein Ansatz, der sich bei uns intern bewährt hat, besteht darin, Zeitstempel für wichtige Ereignisse aufzuzeichnen, damit sie später erneut abgespielt und als gezielte Evaluierungen ausgeführt werden können.
Reduzierung der Anzahl von Subagenten im Laufe der Zeit
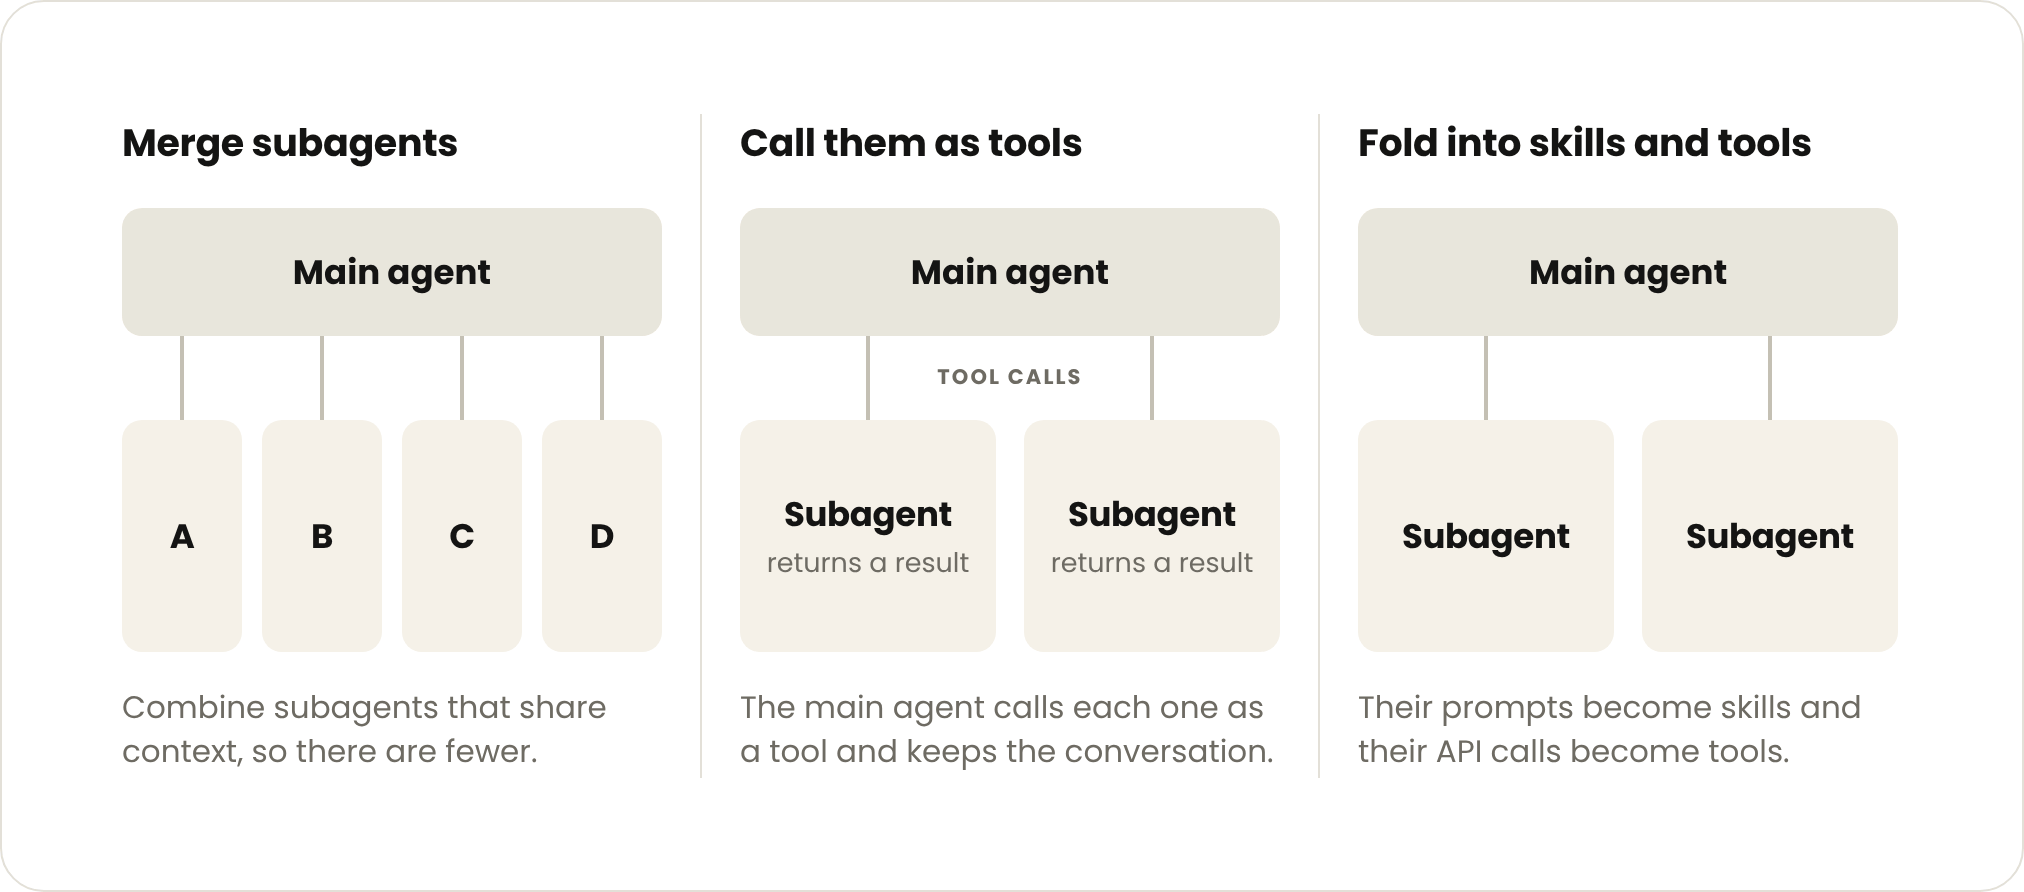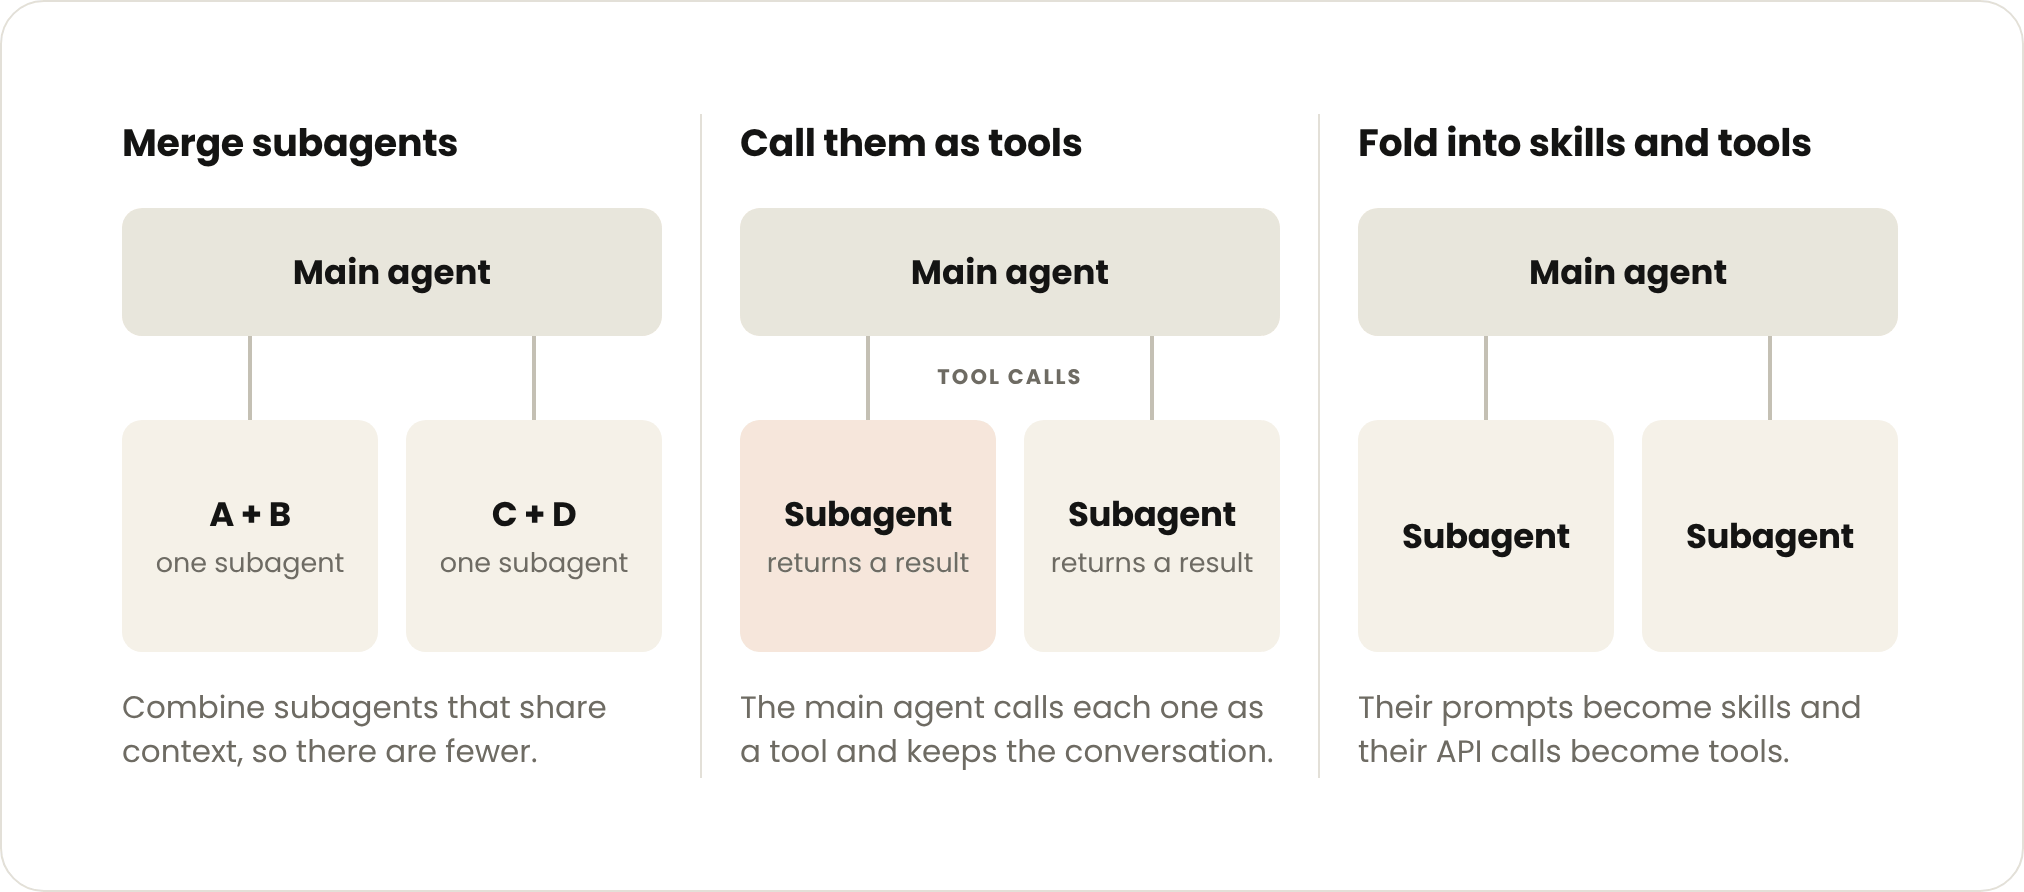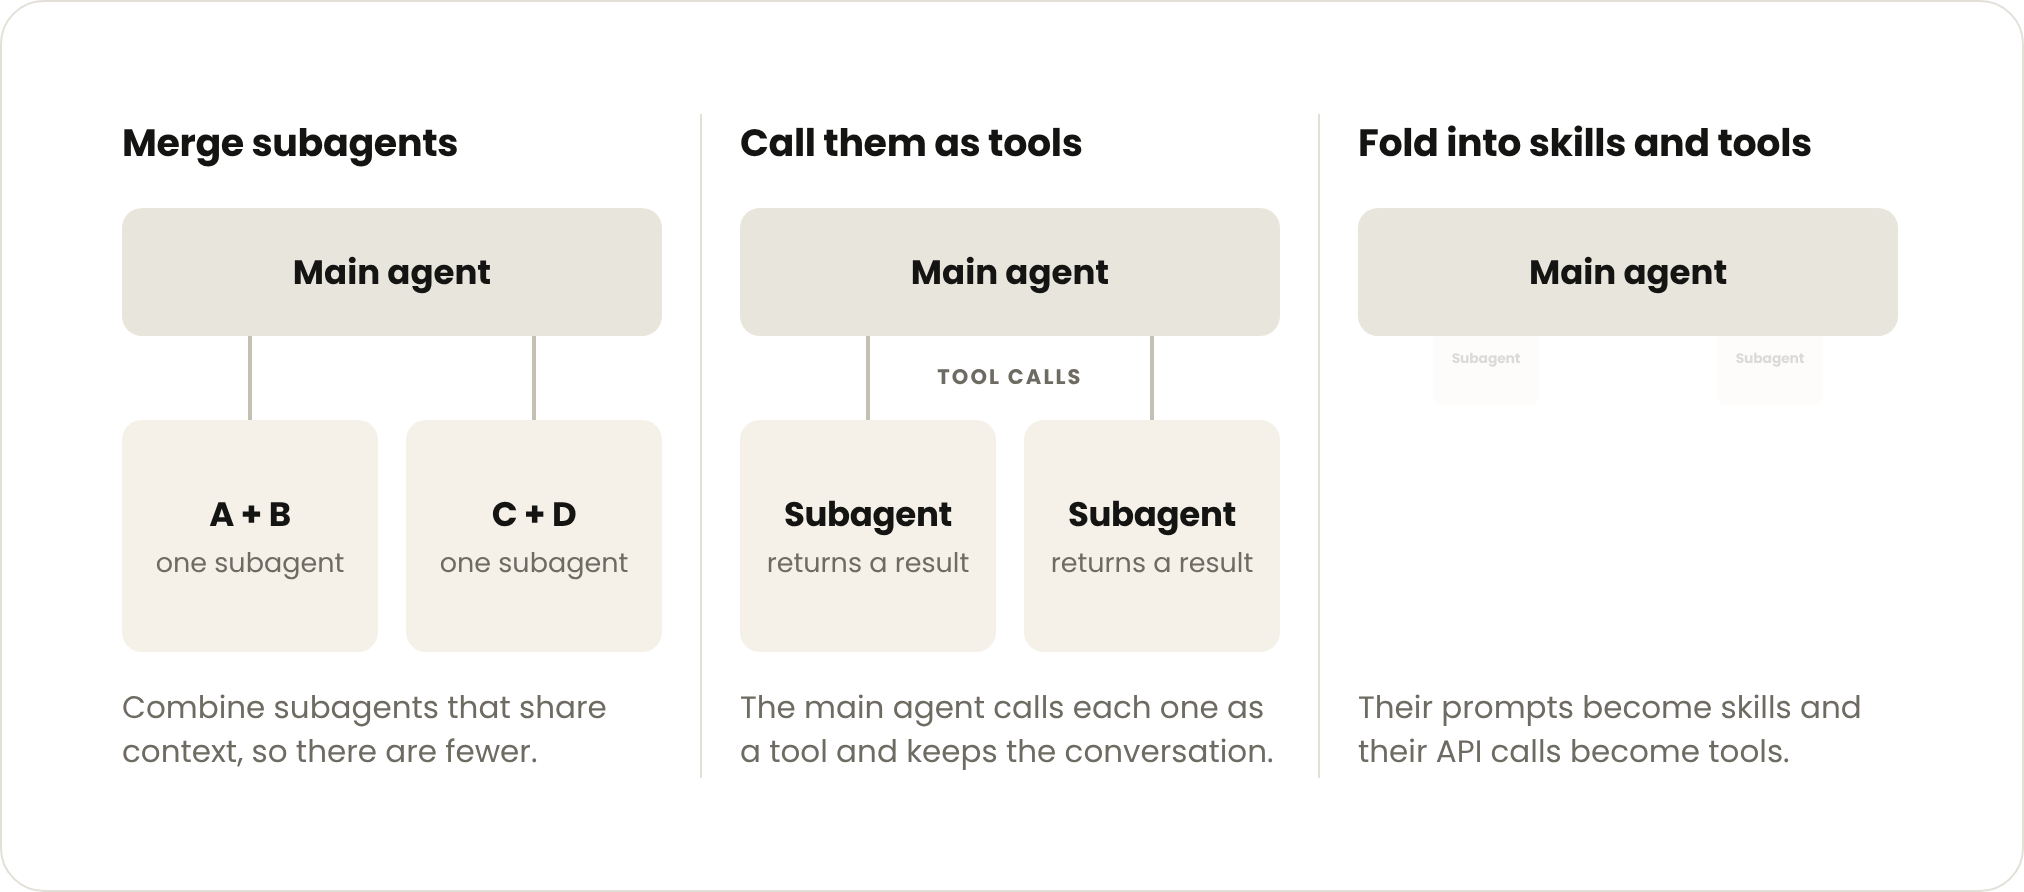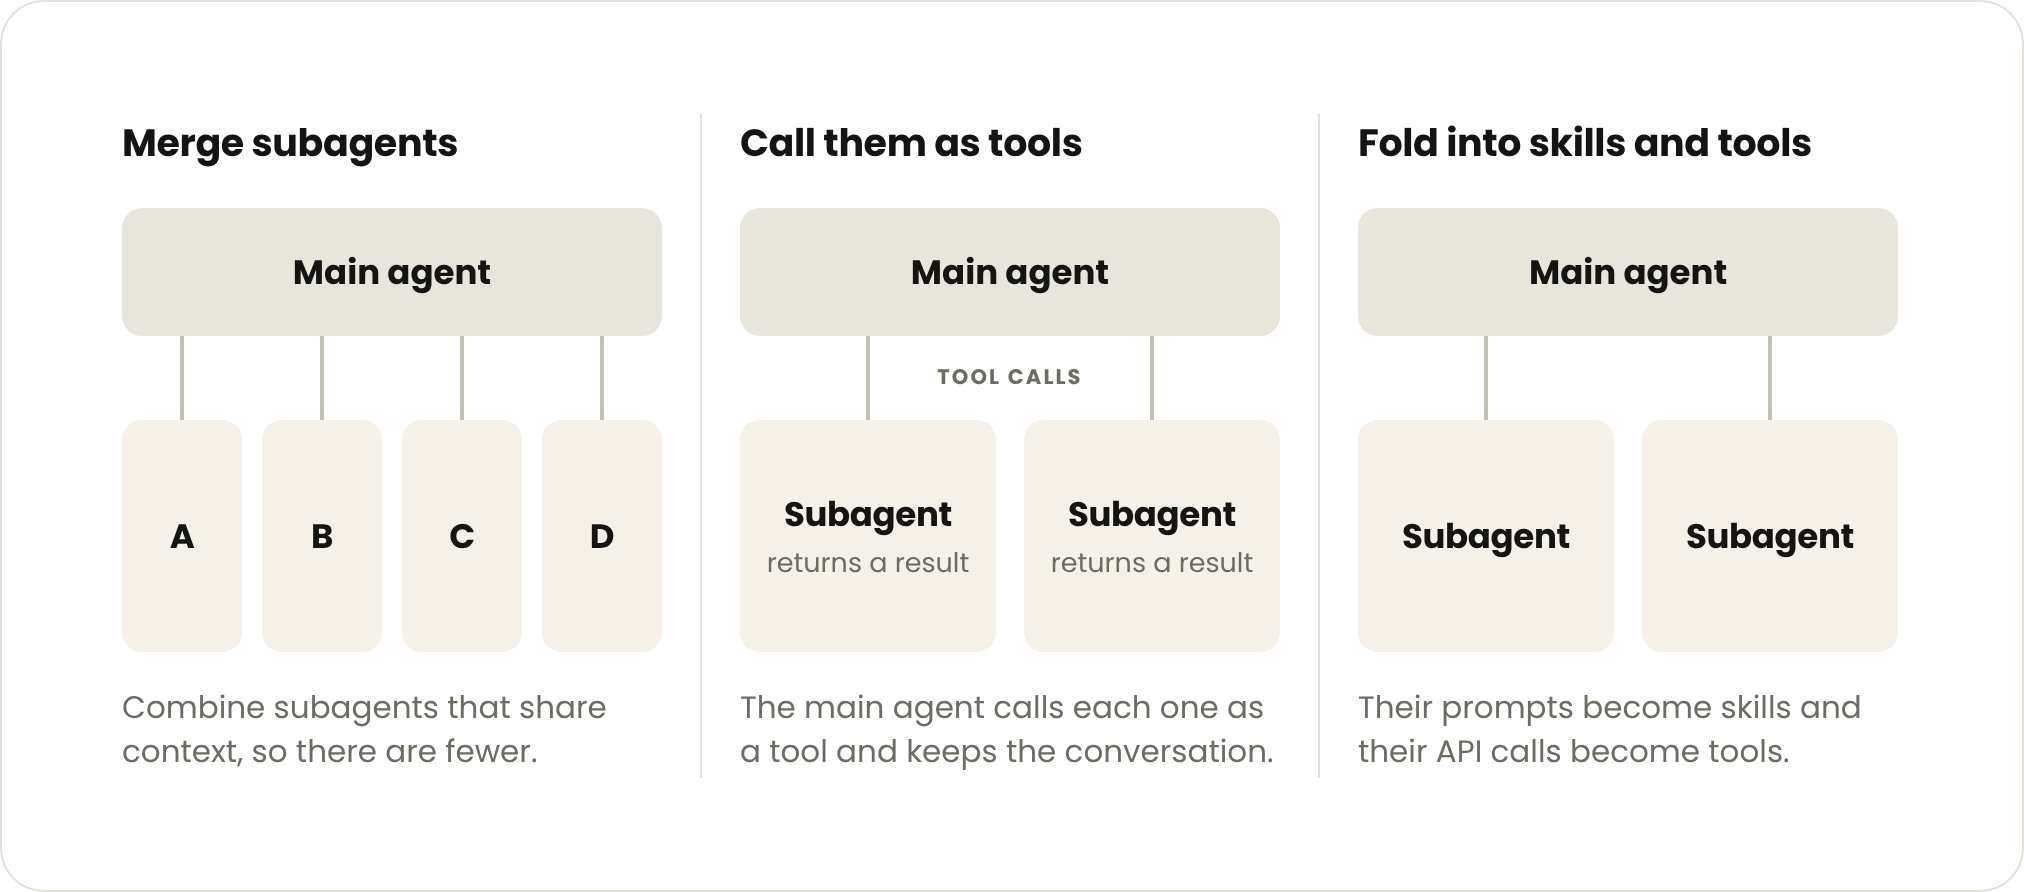
Die Entwicklung hin zu einer Einzelagentenschleife bedeutet, die Subagenten in Tools und Skills zu integrieren. Dazu können Sie Domänensubagenten zusammenführen, als Tools aufrufen oder durch Skills und Tools ersetzen.
Kombination von Domänenagenten
Erstellen Sie vor der ersten Zusammenführung eine kleine End-to-End-Evaluierung. Integrieren Sie die Subagenten dann anhand des gemeinsamen Kontexts, beginnend mit den am häufigsten verwendeten Subagenten.
Führen Sie Spezialisten zusammen, die auf den Ausgaben der jeweils anderen aufbauen, auf dieselben Daten zugreifen oder häufig gemeinsam aufgerufen werden. Wenn beispielsweise ein erheblicher Teil des Datenverkehrs in der Produktion aus einem Spezialisten besteht, auf den ein zweiter folgt, handelt es sich um ein eng gekoppeltes Paar, was es zu einem Kandidaten für die Zusammenführung zu einem Domänenagenten macht.
Als Tools aufgerufene Subagenten
Wenn eine der drei oben genannten Bedingungen zutrifft und Sie einen Subagenten beibehalten, kann es effektiv sein, wenn der Hauptagent Subagenten als Tools aufruft, damit er selbst das Gespräch mit dem Nutzer fortsetzen kann.
Eine vollständige Übergabe, bei der der Subagent das Gespräch übernimmt, empfehlen wir nur, wenn dieser direkt mit dem Nutzer sprechen muss. Alles andere kann ein Skill samt Tools in der Hauptschleife sein.
This will allow you to define a shared response schema for subagents, verify the conclusion against real data with the main agent, and trim the input to any final synthesis step. This is a good first step, as you don’t need to rewrite the subagents. It also gives you a baseline on the task-completion eval before deciding to fold any subagents into the main agent.
Einige Fehlermodi bleiben jedoch bestehen:
- Jeder Spezialist hat einen eigenen Prompt, einen eigenen Kontext, ein verantwortliches Team und eigene Evaluierungen
- Jeder Aufruf liefert weiterhin eine verlustbehaftete Zusammenfassung zurück
- Jeder Aufruf entspricht eine verschachtelten Modellschleife, was die Latenz erhöht
Subagenten über Skills und Tools in den Hauptagenten integrieren
Integrieren Sie Subagenten nacheinander in den Hauptagenten, indem Sie die Prompts jedes einzelnen Agenten in Skills und seine API-Aufrufe in MCP-Tools umwandeln. Vergleichen Sie die Evaluierungsleistung mit und ohne den Subagenten. Entscheiden Sie dann, welche Sie behalten möchten.
Betrachten Sie beim Vergleich nicht nur das Endergebnis, sondern schauen Sie sich auch an, welche Aufgaben sich umgekehrt haben. Als wir dies an einem beispielhaften Supportagenten getestet haben, senkte die Integration eines Subagenten in einen anderen zwar die Latenz, führte aber auch dazu, dass ein zuvor erfolgreicher Prozess fehlschlug. Der Hauptagent bediente das Tool zur Bestellabfrage und antwortete eigenständig, ohne den Versandspezialisten nach dem Lieferdatum zu fragen.
Stellen Sie vor jeder Änderung sicher, dass Ihre Evaluierung eine Aufgabe für jede Kette von Agenten enthält, die in der Produktion zusammen ausgeführt werden, sowie für jede Regel, gegen die der Agent nicht verstoßen darf. Führen Sie außerdem jede Aufgabe mehrmals aus, da ein Fehler wie dieser nur bei einem von zwei Durchläufen aufgetreten ist.
Wie mehrere Teams zu einem einzigen Agenten beitragen können
Domänenspezifisches Reasoning kann aus Wissensdatenbanken, Skills und MCP-Tools abgerufen werden. Einzelne Teams können ihre Verantwortung von Agenten auf Skills und Tools verlagern, wobei ein kleines, zentrales Team die Verantwortung für den Systemprompt und die End-to-End-Qualität behält. Dazu gehört die Überprüfung neuer Skills, Tools und Evaluierungen vor deren Veröffentlichung.
MCP-Tools
Tools sind die richtige Wahl, wenn der Agent eine Aktion ausführen, Live-Daten aus einem System lesen oder ein Ergebnis in einem festen Format zurückgeben muss. Sie können Tools auch verwenden, um Subagenten während der Migration weiterhin aufzurufen. Wir empfehlen, Tools nach Nutzerabsicht zu gruppieren (nicht ein Tool pro API), denn sobald Sie 30 bis 50 Tooldefinitionen im Systemprompt überschreiten, verschlechtert sich tendenziell die Toolauswahl.
Verwenden Sie die Toolsuche mit verzögertem Laden, begrenzen Sie strikte Voraussetzungen und verlagern Sie alle erforderlichen Voraussetzungen in die Tools. Wenn Y beispielsweise die Ausgabe von X benötigt, prüft das Tool von Y, ob sie vorliegt, und gibt eine Anweisung zurück, auf die das Modell reagieren kann. Berechtigungen pro Nutzer funktionieren auf die gleiche Weise. Jedes Tool überprüft, was der aufrufende Nutzer sehen oder tun darf, und gibt eine einfache Ablehnung zurück, die das Modell lesen kann, sodass eine Schleife Nutzer mit unterschiedlichen Zugriffsrechten bedienen kann, ohne dass ein separater Agent pro Berechtigungsstufe nötig ist.
Skills
Skills sind die richtige Wahl, wenn der Agent wissen muss, wie ein Team arbeitet – etwa die Schritte, Regeln und Ermessensentscheidungen, die früher im Prompt eines spezialisierten Subagenten festgehalten waren.
Unser Ansatz, Skillbibliotheken auszubauen, besteht darin, die Wartungsarbeit wieder den Personen zu übertragen, die die Skills schreiben. Claude kann mit Skills, die andere Skills erstellen, testen und bereinigen können, die Hauptarbeit übernehmen.
Um einen Wildwuchs von Skills zu verhindern, können Sie DRIs pro Team die Verantwortung für ihre Skills übertragen, die dafür sorgen, dass diese gut gestaltet, klar voneinander abgegrenzt und mit geeigneten Evaluierungen ausgeliefert werden.
- Mit /skill-creator können Sie neue Skills erstellen, die von Anfang an gut strukturiert sind, und bestehende Skills überprüfen, um sie zurechtzustutzen, zu deduplizieren und neu zu strukturieren.
- Mit /skill-doctor können Sie sehen, was jeder Skill in Ihrer Bibliothek kostet sowie wie oft er tatsächlich verwendet wird, und nicht benötigte Skills löschen.
Wissensdatenbanken
Wissensdatenbanken sind die richtige Wahl für Referenzmaterial, das der Agent nur gelegentlich benötigt. Fakten und Referenzmaterial (Richtlinien, Kennzahlendefinitionen, Produktspezifikationen) können über ein vom Modell ausfgerufenes Such- oder Nachschlagetool abgerufen werden oder als Referenzdateien innerhalb eines Skills bereitgestellt werden. Vermeiden Sie es, diesen Kontext durch Code abrufen und in Prompts einfügen zu lassen.
Tools zur Beschleunigung dieser Arbeit
Wir haben kürzlich eine Reihe von Claude API-Skills veröffentlicht, die bei den meisten der oben genannten Arbeiten helfen können. Unser Migrationskit verkettet diese Skills in einem geführten Workflow zur Bewertung und Überführung von Multiagentensystemen in eine einzige Agentenschleife. Es enthält eine Demo, die Sie testen können, bevor Sie das Kit für Ihr echtes System übernehmen:
- /claude-api build-eval: Kann dabei helfen, einen ersten End-to-End-Satz zu erstellen, der dem zentralen Team gehört, oder kleine Evaluierungen, die jedes Team mit seinem Skill bereitstellt
- /claude-api prompt-audit: Kann Anweisungen, die für ältere Modelle geschrieben wurden, in Ihren Prompts, Skills und Toolbeschreibungen markieren und Korrekturen als Diff vorschlagen. Sie können dies für Ihre Systemprompts ausführen, um alle Regeln zu finden, die für ein früheres Modell hinzugefügt wurden und den Agenten jetzt langsamer oder starrer machen. Die DRI jedes Teams kann es auch für die eigenen Skills und Toolbeschreibungen ausführen.
- /claude-api hillclimb: Kann eine App anhand einer vorhandenen Evaluierung iterativ verbessern. Dies kann für den Vergleich „integriert vs. beibehalten“ verwendet werden (nachdem Sie einen Subagenten in einen Skill samt Tools integriert haben, lassen Sie das Tool die Skill- und Toolbeschreibungen iterieren und prüfen Sie, ob die integrierte Version mit dem Subagenten gleichzieht oder ihn übertrifft), ebenso wie für Ihren Systemprompt.
- /claude-api cost-optimize: Erstellt Profile für Ihre Aufrufe und schlägt Einsparungen durch Optionen wie Prompt-Caching, das Kürzen nicht benötigter Eingabe- und Ausgabetokens, Aufwand und Modellauswahl vor – eine Änderung nach der anderen. Dies kann zur Senkung von Kosten und Latenz bei einem bestimmten Design beitragen.
Mit der Weiterentwicklung von Modellen entwickeln sich sowohl unser Verständnis für deren optimalen Einsatz als auch unsere Leitlinien für Best Practices weiter. Dadurch ist jede einzelne Architektur weniger wichtig als das Prinzip, das dahintersteht: messen, jeweils nur eine Sache ändern und beibehalten, was sich bewährt.
Dies ist einer dieser Fälle. Wenn Modelle leistungsfähiger werden und Agenten länger laufen, können mehr Ihrer Subagenten als Skills und Tools fungieren. Sie müssen diesen Wechsel jedoch nicht in einem Schritt vollziehen. Erstellen Sie eine kleine End-to-End-Evaluierung, binden Sie einen Subagenten ein und behalten Sie ihn nur dann als Subagenten bei, wenn die eingebundene Version schlechter abschneidet – und wiederholen Sie dann das Ganze.