Publicado originalmente el 23 de febrero de 2026.
Las personas están integrando herramientas de IA en sus rutinas diarias a un ritmo que habría sido difícil de predecir incluso hace un año. Pero la adopción por sí sola no nos dice mucho sobre el impacto de estas herramientas. Una pregunta adicional, igualmente importante, es: a medida que la IA se convierte en parte de la vida cotidiana, ¿están las personas desarrollando las habilidades para usarla bien?
Informes de Educación de Anthropic anteriores han estudiado cómo los estudiantes universitarios(se abre en una pestaña nueva) y los educadores(se abre en una pestaña nueva) usan Claude. Descubrimos que los estudiantes lo usan para crear informes y analizar resultados de laboratorio; los educadores lo usan para elaborar materiales de clase y automatizar trabajo rutinario. Pero sabemos que cualquier persona que use IA probablemente mejore en lo que hace. Quisimos explorar esto más a fondo, y entender cómo las personas que usan IA desarrollan "fluidez" con esta tecnología con el tiempo.
En este informe, comenzamos a responder esa pregunta. Rastreamos la presencia o ausencia de una taxonomía de comportamientos que consideramos representan la fluidez en IA a través de una gran muestra de conversaciones anonimizadas.
En línea con nuestro reciente Índice Económico(se abre en una pestaña nueva), encontramos que la expresión más común de fluidez en IA es aumentativa: tratar a la IA como un compañero de pensamiento, en lugar de delegarle el trabajo por completo. De hecho, estas conversaciones exhiben más del doble de comportamientos de fluidez en IA que los chats rápidos de ida y vuelta.
Pero también encontramos que cuando la IA produce artefactos —incluyendo aplicaciones, código, documentos o herramientas interactivas— los usuarios tienen menos probabilidades de cuestionar su razonamiento (-3.1 puntos porcentuales) o identificar contexto faltante (-5.2pp). Esto concuerda con patrones relacionados que observamos en nuestro estudio reciente sobre habilidades de programación(se abre en una pestaña nueva).
Estos hallazgos iniciales nos presentan una línea base que podemos usar para estudiar el desarrollo de la fluidez en IA a lo largo del tiempo.
Midiendo la fluidez en IA
Para cuantificar la fluidez en IA, usamos el Marco de Fluidez en IA 4D(se abre en una pestaña nueva), desarrollado por los profesores Rick Dakan y Joseph Feller en colaboración con Anthropic. Este marco nos ayuda a definir 24 comportamientos específicos que consideramos ejemplifican una colaboración humano-IA segura y efectiva.
De estos 24 comportamientos, 11 (enumerados en el gráfico a continuación) son directamente observables cuando los humanos interactúan con Claude en Claude.ai o Claude Code. Los otros 13 (incluyendo cosas como ser honesto sobre el papel de la IA en el trabajo, o considerar las consecuencias de compartir resultados generados por IA) ocurren fuera de la interfaz de chat de Claude.ai, por lo que son mucho más difíciles de rastrear para nosotros. Estos comportamientos no observables son posiblemente algunas de las dimensiones más consecuentes de la fluidez en IA, así que en trabajos futuros planeamos usar métodos cualitativos para evaluarlos.
Para este estudio, nos enfocamos en los 11 comportamientos directamente observables. Usamos nuestra herramienta de análisis que preserva la privacidad(se abre en una pestaña nueva) para estudiar 9,830 conversaciones que incluyeron varios intercambios de ida y vuelta con Claude en Claude.ai durante una ventana de 7 días en enero de 2026.1 Luego medimos la presencia o ausencia de los 11 comportamientos; cada conversación podía mostrar evidencia de múltiples comportamientos. Evaluamos la confiabilidad de nuestra muestra verificando si nuestros resultados eran consistentes en cada día de la semana, y en los diferentes idiomas de nuestra muestra (encontramos que lo eran).2 Esto, finalmente, nos dio el Índice de Fluidez en IA: una medición de línea base de cómo las personas colaboran con la IA hoy, y una base para rastrear cómo esos comportamientos evolucionan con el tiempo a medida que los modelos cambian.
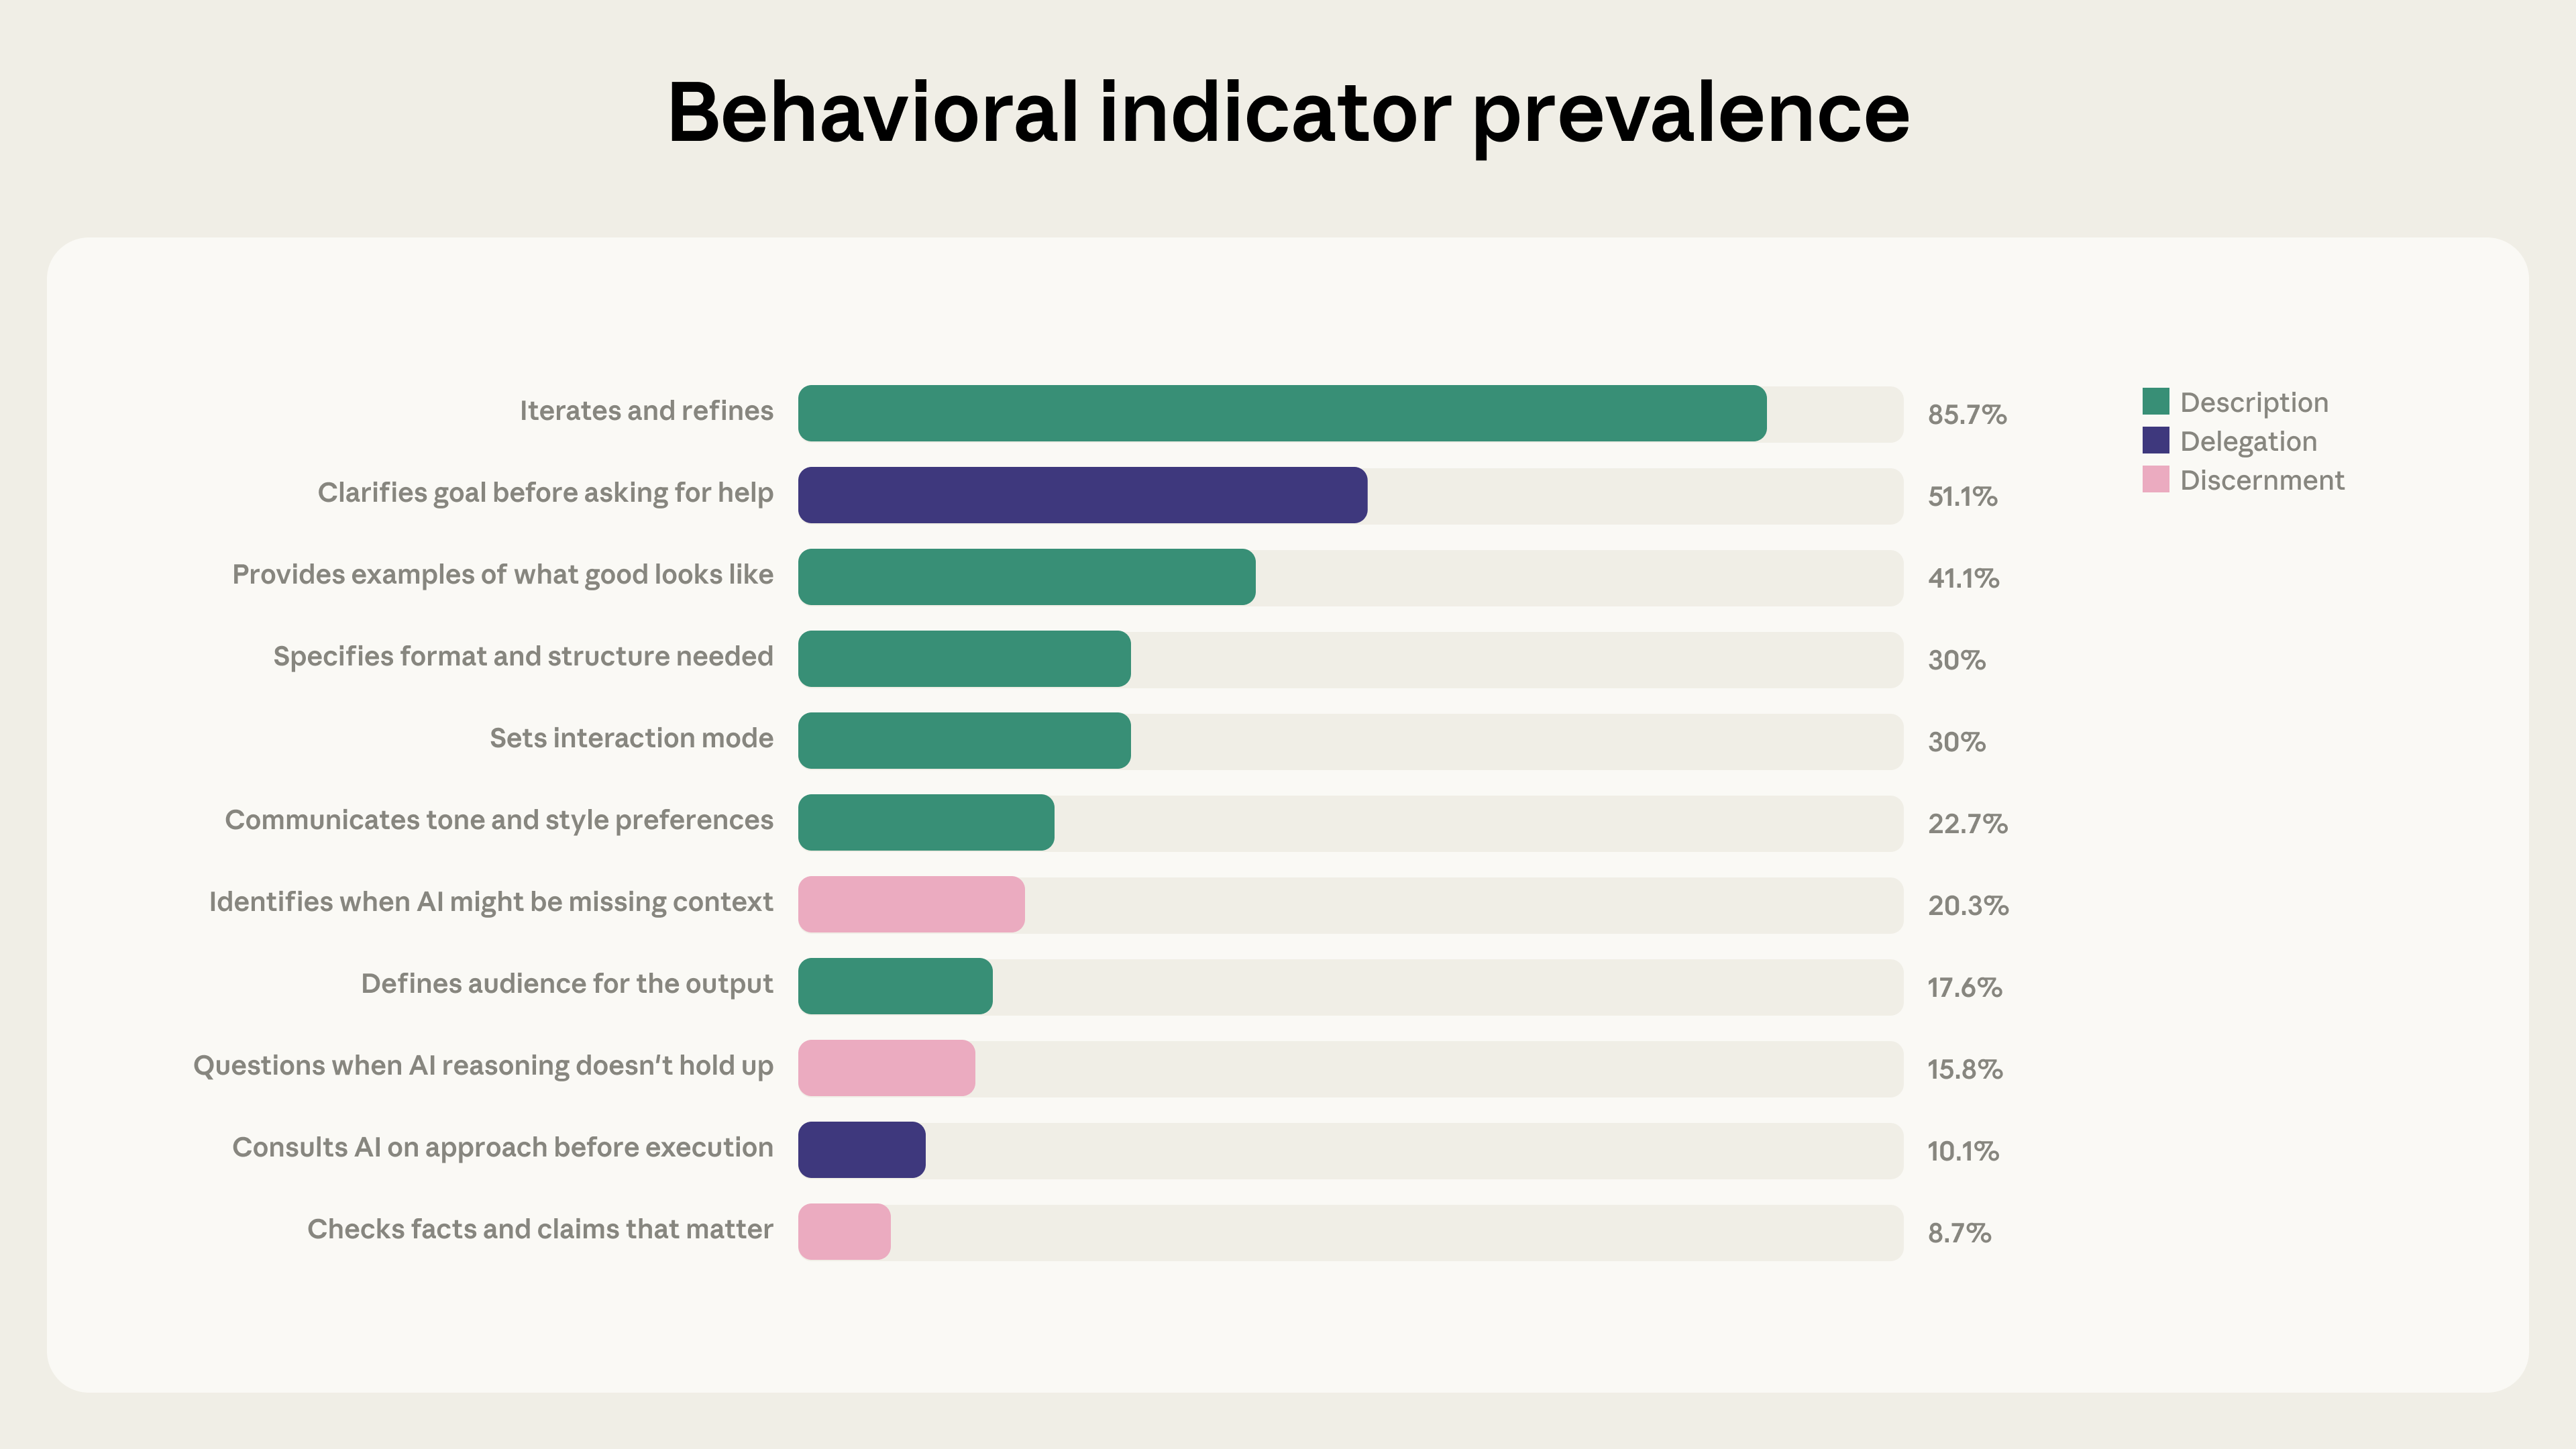
Prevalencia de cada indicador de comportamiento de fluidez en IA en 9,830 conversaciones de Claude.ai, clasificadas de más a menos comunes y codificadas por color según la competencia.
Resultados
Con nuestro primer estudio, hemos encontrado dos patrones principales en el uso de Claude: una fuerte relación entre la fluidez en IA y la iteración y el refinamiento a través de conversaciones más largas con Claude, y cambios en los comportamientos de fluidez de los usuarios al programar o construir otros resultados.
La fluidez está fuertemente asociada con conversaciones que exhiben iteración y refinamiento
Uno de los patrones más fuertes en los datos es la relación entre la iteración y el refinamiento y todos los demás comportamientos de fluidez en IA. El 85.7% de las conversaciones en nuestra muestra exhibieron iteración y refinamiento: construir sobre intercambios previos para refinar el trabajo del usuario, en lugar de aceptar la primera respuesta y pasar a una nueva tarea. Estas conversaciones mostraron tasas sustancialmente más altas de otros comportamientos de fluidez, como muestra el gráfico a continuación:
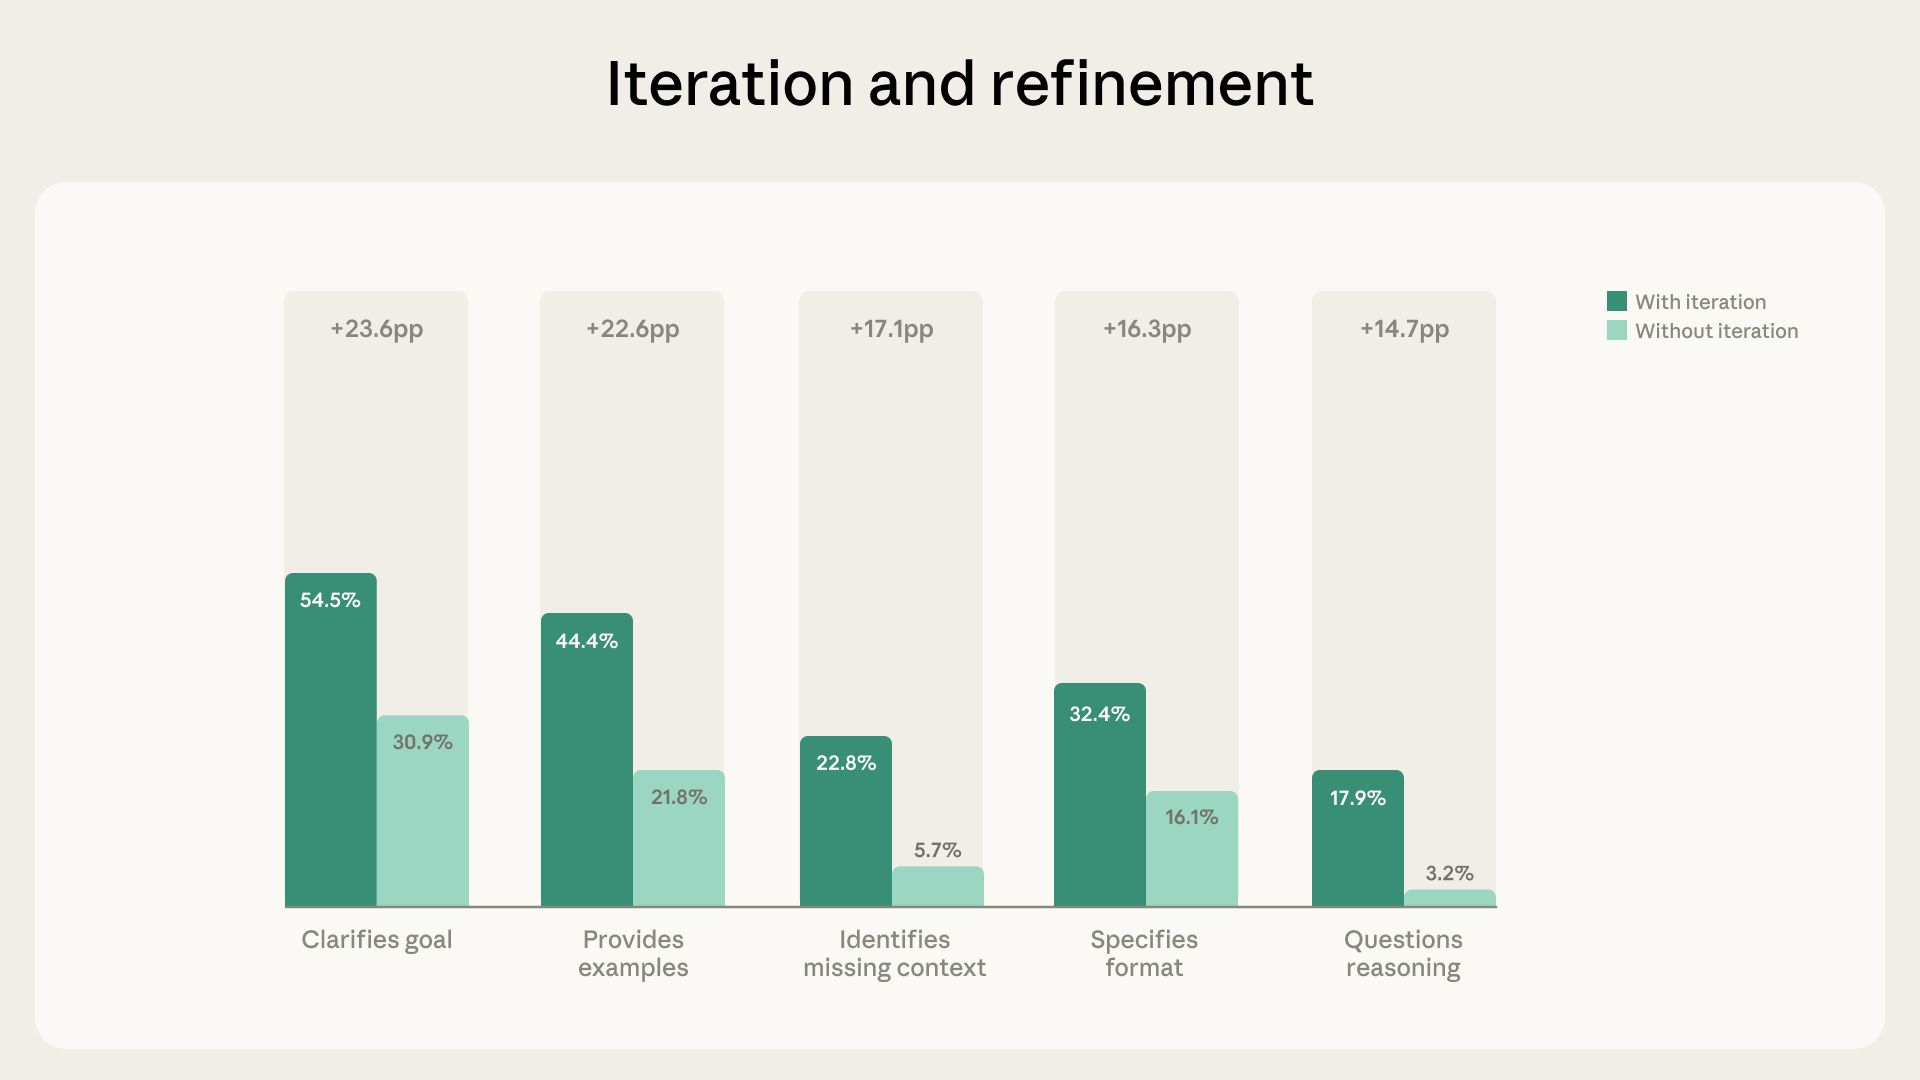
Prevalencia de indicadores de comportamiento en conversaciones donde el usuario itera y refina (n=8,424) versus conversaciones sin iteración y refinamiento (n=1,406). Todos los comportamientos son sustancialmente más prevalentes en conversaciones con iteración y refinamiento.
En promedio, las conversaciones con iteración y refinamiento exhiben 2.67 comportamientos de fluidez adicionales, aproximadamente el doble de la tasa no iterativa de 1.33. Esto es especialmente pronunciado para los comportamientos de fluidez relacionados con la evaluación de los resultados de Claude. Las conversaciones con iteración y refinamiento tienen 5.6 veces más probabilidades de involucrar a usuarios que cuestionan el razonamiento de Claude, y 4 veces más probabilidades de que identifiquen contexto faltante.
Al crear resultados, los usuarios se vuelven más directivos pero menos evaluativos
El 12.3% de las conversaciones en nuestra muestra involucraron artefactos, incluyendo código, documentos, herramientas interactivas y otros resultados. En estas conversaciones, las personas colaboraron con la IA de manera bastante diferente.
Específicamente, encontramos tasas sustancialmente más altas de comportamientos que caen dentro de los temas más amplios de "descripción" y "delegación". Por ejemplo, estas conversaciones tienen más probabilidades de ver a los usuarios aclarar su objetivo (+14.7pp), especificar un formato (+14.5pp), proporcionar ejemplos (+13.4pp) e iterar (+9.7pp) en comparación con las conversaciones sin artefactos. En otras palabras, hacen más para dirigir a la IA desde el inicio de su trabajo.
Pero esta directividad no corresponde con mayores niveles de evaluación o discernimiento. De hecho, es lo contrario: en conversaciones donde se crean artefactos, los usuarios tienen menos probabilidades de identificar contexto faltante (-5.2pp), verificar hechos (-3.7pp), o cuestionar el razonamiento del modelo pidiéndole que explique su lógica (-3.1pp). Nuestro Índice Económico(se abre en una pestaña nueva) encuentra que —sin sorpresa— las tareas más complejas son donde Claude tiene más dificultades, por lo que esto parece particularmente notable.
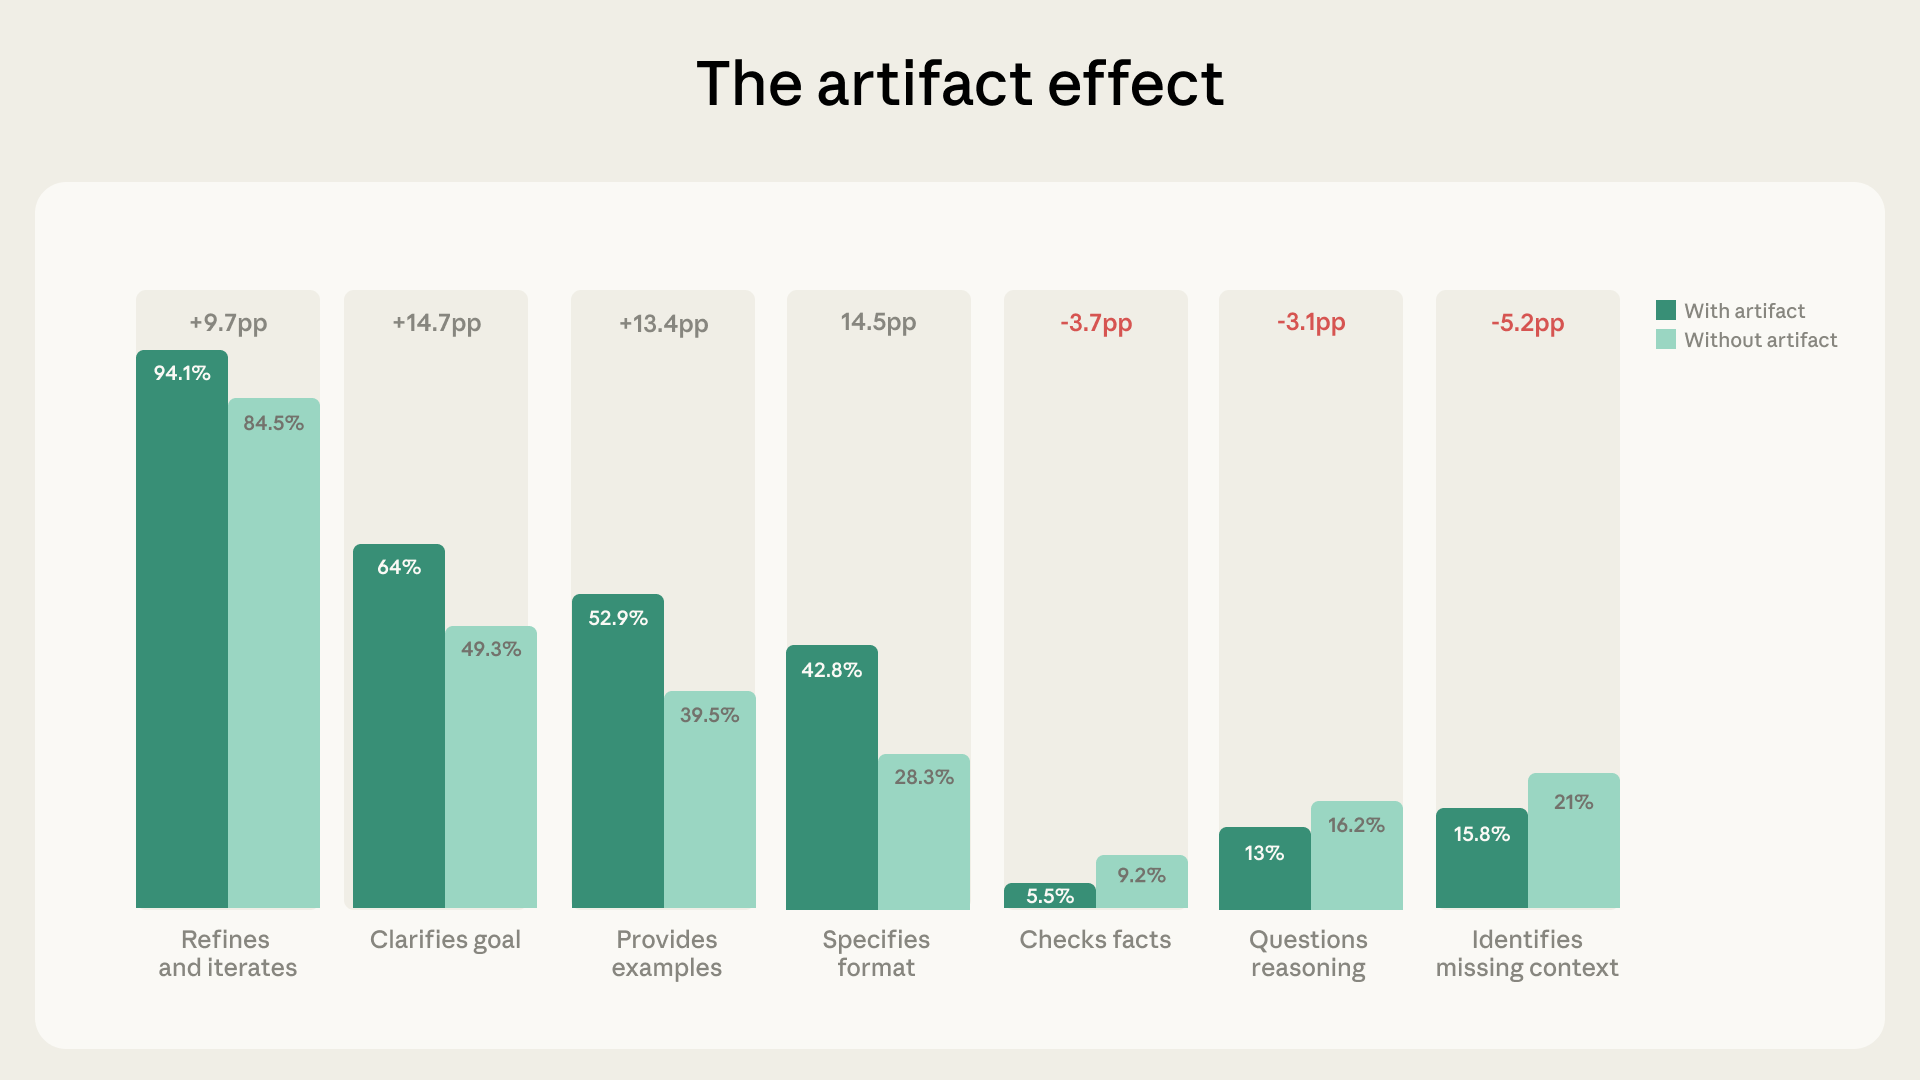
Prevalencia de indicadores de comportamiento en conversaciones con artefactos (n=1,209) versus sin artefactos (n=8,621). Los comportamientos de descripción y delegación aumentan en las conversaciones con artefactos, mientras que los tres comportamientos de discernimiento disminuyen.
Hay varias explicaciones posibles para este patrón. Podría ser que Claude esté creando resultados pulidos y de aspecto funcional, para los cuales no parece necesario cuestionar más las cosas: si el trabajo se ve terminado, los usuarios podrían tratarlo como tal. Pero también es posible que las conversaciones con artefactos involucren tareas donde la precisión factual importa menos que la estética o la funcionalidad (diseñar una interfaz de usuario, por ejemplo, versus escribir un análisis legal). O los usuarios podrían estar evaluando los artefactos a través de canales que no podemos observar —ejecutando código, probando una aplicación en otro lugar, compartiendo un borrador con un colega— en lugar de expresar su evaluación dentro de esa misma conversación inicial.
Sea cual sea la explicación, el patrón merece atención. A medida que los modelos de IA se vuelven cada vez más capaces de producir resultados de aspecto pulido, la capacidad de evaluar críticamente esos resultados, ya sea en conversación directa o por otros medios, se volverá más valiosa, no menos.
Desarrollando tu propia fluidez en IA
Como con todas las habilidades, la fluidez en IA es una cuestión de grado; para la mayoría de nosotros, es posible desarrollar nuestras técnicas mucho más. Basándonos en los patrones de nuestros datos, hay tres áreas donde hemos encontrado que muchos usuarios podrían mejorar sus habilidades:
Mantenerse en la conversación. La iteración y el refinamiento son el correlato individual más fuerte de todos los demás comportamientos de fluidez en nuestros datos. Así que, cuando recibas una respuesta inicial, vale la pena tratarla solo como un punto de partida: haz preguntas de seguimiento, cuestiona cualquier parte que no se sienta correcta, y refina lo que estás buscando.
Cuestionar los resultados pulidos. Cuando los modelos de IA producen algo que se ve bien, es el momento perfecto para detenerse y preguntar: ¿es esto preciso? ¿Falta algo? ¿Este razonamiento se sostiene? Como discutimos anteriormente, nuestros datos muestran que los resultados pulidos coinciden con tasas más bajas de evaluación crítica, aunque los usuarios se esfuercen más en dirigir el trabajo de Claude desde el inicio.
Establecer los términos de la colaboración. Solo en el 30% de las conversaciones los usuarios le dicen a Claude cómo les gustaría que interactuara con ellos. Intenta ser explícito agregando instrucciones como: "Cuestiona mis suposiciones si están equivocadas", "Guíame a través de tu razonamiento antes de darme la respuesta", o "Dime de qué no estás seguro". Establecer estas expectativas desde el principio puede cambiar la dinámica del resto de la conversación.
Limitaciones
Esta investigación viene con advertencias importantes:
- Limitaciones de la muestra: Nuestra muestra refleja a usuarios de Claude.ai que participaron en conversaciones de múltiples turnos durante una sola semana en enero de 2026. Dado que creemos que esto todavía está relativamente temprano en la difusión de las herramientas de IA, estos usuarios probablemente se inclinan hacia adoptantes tempranos que ya se sienten cómodos con la IA, es decir, que pueden no representar a la población más amplia. Nuestra muestra debe entenderse como una línea base para esta población, no como un punto de referencia universal. Debido a que los datos provienen de una sola semana, tampoco es capaz de capturar efectos estacionales o longitudinales. Y debido a que se centra en Claude.ai(se abre en una pestaña nueva), no capturamos cómo los usuarios interactúan con otras plataformas de IA.
- Cobertura parcial del marco: En este estudio, solo evaluamos los 11 de los 24 indicadores de comportamiento que son directamente observables en conversaciones en Claude.ai. Todos los comportamientos relacionados con el uso responsable y ético de los resultados de IA ocurren fuera de estas conversaciones, y no son capturados.
- Clasificación binaria: Para cada conversación en nuestra muestra, clasificamos cada comportamiento como presente o ausente. Pero esto probablemente pasa por alto matices significativos, como demostraciones discutibles o parciales de comportamientos, o señales superpuestas entre ellos.
- Comportamientos implícitos: Los usuarios podrían demostrar comportamientos de fluidez mentalmente (como verificar las afirmaciones de Claude contra su propio conocimiento) sin expresar estos comportamientos en la conversación. Esto parece especialmente relevante para nuestros datos sobre artefactos: los usuarios podrían estar evaluando los resultados de Claude a través de pruebas y uso práctico, en lugar de a través de comportamientos visibles en la conversación.
- Hallazgos correlacionales: Las relaciones que identificamos son correlacionales. No sabemos si un comportamiento causa otro, o si ambos reflejan algún factor subyacente común, como la complejidad de la tarea o las preferencias del usuario.
Mirando hacia adelante
Este estudio nos ofrece una línea base que podemos usar para evaluar cómo está cambiando la fluidez en IA con el tiempo. A medida que las capacidades de la IA evolucionan y la adopción aumenta, buscamos aprender si los usuarios están desarrollando comportamientos más sofisticados, qué habilidades están surgiendo naturalmente con la experiencia, y cuáles requerirán un desarrollo más intencional.
En trabajos futuros, planeamos extender nuestro análisis en varias direcciones. Primero, planeamos realizar "análisis de cohortes", comparando usuarios nuevos con usuarios experimentados para entender cómo la familiaridad con la IA se correlaciona con el desarrollo de la fluidez. Segundo, planeamos usar métodos de investigación cualitativa para evaluar los comportamientos que no son directamente observables en las conversaciones de Claude.ai. Y tercero, buscamos explorar las preguntas causales que este trabajo plantea, como si fomentar conversaciones iterativas conduce a una mayor evaluación crítica, o si hay otras intervenciones que podrían fomentar esto de manera más efectiva.
Además, nos gustaría explorar los comportamientos de fluidez en IA en Claude Code, una plataforma usada principalmente por desarrolladores de software. En preparación para este estudio, realizamos un análisis inicial que encontró consistencia entre las conversaciones de Claude Code y las de Claude.ai(se abre en una pestaña nueva). Pero esto sigue siendo preliminar, y la base de usuarios y funcionalidad muy diferentes de Claude Code implica que se necesita una investigación más sustancial.
Esperamos que la naturaleza de la fluidez en IA se desarrolle y evolucione sustancialmente con el tiempo. Con esta y futuras investigaciones, buscamos hacer que ese desarrollo sea visible, medible y procesable.
Bibtex
Si deseas citar esta publicación, puedes usar la siguiente clave Bibtex:
@online{swanson2026aifluency,
author = {Kristen Swanson and Drew Bent and Zoe Ludwig and Rick Dakan and Joe Feller},
title = {Anthropic Education Report: The AI Fluency Index},
date = {2026-02-23},
year = {2026},
url = {https://academy.claude.com/tutorials/the-ai-fluency-index},
}
Agradecimientos
Kristen Swanson diseñó la investigación, lideró el análisis y escribió este informe. Zoe Ludwig y Drew Bent contribuyeron a la alineación del marco, la mensajería y la revisión. El Marco 4D para la Fluidez en IA fue desarrollado por Rick Dakan y Joe Feller. Zack Lee brindó soporte técnico. Hanah Ho ayudó a visualizar los datos. Keir Bradwell, Rebecca Hiscott, Ryan Donegan y Sarah Pollack brindaron revisión y orientación de comunicaciones.
Notas al pie
- Al investigar cómo las personas usan los modelos de IA, proteger la privacidad del usuario es primordial. Para este proyecto, usamos nuestra herramienta de análisis que preserva la privacidad(se abre en una pestaña nueva), que permite el descubrimiento ascendente de patrones de uso de IA destilando las conversaciones de los usuarios en resúmenes de uso de alto nivel, como "solucionar problemas de código" o "explicar conceptos económicos". Para este análisis, ejecutamos 11 clasificadores binarios separados (uno por indicador de comportamiento) usando Claude Sonnet 4 para la clasificación de comportamiento y Claude Haiku 3.5 para la detección de idioma. Esto significa que una sola conversación podía indicar múltiples indicadores de comportamiento de fluidez en IA. Las conversaciones se filtraron para incluir intercambios sustanciales con múltiples idas y vueltas usando un filtro que excluyó saludos, intercambios de una sola palabra, mensajes de prueba y charla pura. La revisión manual de 200 chats que fueron filtrados indicó que los chats de esta naturaleza no calificaban para ningún indicador de Fluidez en IA, por lo que confiamos en que el filtro no influyó en las clasificaciones relativas de los comportamientos de fluidez en IA observados en el estudio. No aparece información de identificación personal en el análisis.
- Los indicadores de comportamiento se calcularon a través de una muestra de una semana (20–26 de enero de 2026) y se mantuvieron estables día a día, con la mayoría de los comportamientos variando solo entre 1 y 5 puntos porcentuales. Las tasas del sábado fueron ligeramente más bajas para algunos comportamientos (por ejemplo, la iteración y el refinamiento fue del 81.4% para el sábado en comparación con un pico de día laborable del 87.9%), lo que sugiere diferencias modestas entre el uso casual y el uso con propósito, pero ningún día mostró una desviación estructural significativa. Las tasas también fueron consistentes en seis idiomas (inglés, francés, español, chino, japonés y alemán), con la mayoría de los comportamientos variando en 3 puntos porcentuales o menos entre los grupos de idiomas. En conjunto, estos hallazgos sugieren que los patrones de comportamiento capturados aquí reflejan hábitos consistentes en cómo las personas interactúan con la IA, en lugar de ser artefactos del momento, el día de la semana, o el contexto lingüístico y cultural.