Para muchos, aprender a usar la IA comienza con aprender la herramienta en sí. Las personas a menudo empiezan con preguntas como: ¿Cómo describo lo que necesito a Claude? ¿Cómo le doy a Claude de forma segura los archivos y datos que necesita para hacer un buen trabajo? Pero a medida que Claude se usa para tareas más grandes y complejas, surge una pregunta más difícil: ¿cómo sé si Claude tiene razón?
El discernimiento, o la precisión y relevancia de los resultados de la IA, es uno de los aspectos más críticos de la fluidez en IA. Sin embargo, es más difícil de estudiar directamente porque puede ocurrir más allá de los límites de una herramienta de IA.
Así que, con la ayuda de Anthropic Interviewer(se abre en una pestaña nueva), preguntamos a 129 participantes de Claude Academy: ¿cómo se ve el discernimiento cuando trabajas con Claude? Las personas compartieron sus historias sobre trabajos recientes que hicieron con Claude, incluyendo cómo verificaron la calidad y precisión de Claude.1
Aprendimos mucho, pero surgieron tres grandes temas. Primero, "verificar el trabajo de Claude" la mayoría de las veces significaba verificación contra algo externo a la conversación: fuentes, documentos, pruebas, otras personas u otra IA. Segundo, la mayor barrera para el discernimiento no fue la presión del tiempo, sino la falta de experiencia en el dominio. Y, tercero, cuando los errores de Claude se detectaban demasiado tarde, a menudo impulsaba a las personas a adoptar comportamientos de discernimiento nuevos y creativos.
Estas historias nos ayudan a comprender los hábitos que los usuarios avanzados han desarrollado para que podamos construir nuestros propios conjuntos de herramientas de discernimiento. La mayoría de los encuestados en este estudio usan Claude a diario durante seis meses o más.2 Esto está muy por encima de la población general, lo cual es útil para catalogar buenas prácticas y una limitación para cualquier otra cosa. No hacemos afirmaciones de prevalencia más allá de esta muestra.
Perspectivas clave
En todas las entrevistas, encontramos tres patrones notables:
- Verificar los resultados de Claude generalmente implica validación contra fuentes externas
- La experiencia es la mayor barrera para el discernimiento
- Los errores que pasan desapercibidos pueden impulsar la adopción de comportamientos de discernimiento nuevos y creativos
Verificar el trabajo de Claude contra una fuente externa de verdad fue la práctica de discernimiento más comúnmente reportada
Esperábamos que "verificar el trabajo de Claude" se describiera principalmente como una lectura completa en busca de errores obvios. Sin embargo, el 51% de los participantes que entrevistamos describieron verificar el resultado de Claude contra algo externo: documentos fuente, documentación oficial, sus propios datos, otra persona, o incluso otra IA. El 10% de los verificadores fue aún más lejos, combinando varias verificaciones independientes. Una lectura completa sin ninguna validación externa fue la práctica minoritaria, especialmente si la tarea era técnica.
Lo que significaba "fuente externa de verdad" dependía del trabajo. Cuando la tarea involucraba código, generalmente se usaban pruebas. Las tareas de investigación y análisis se apoyaban en verificaciones cruzadas contra fuentes y segundas opiniones. 10 relatos describieron el uso de una segunda IA para verificar el trabajo de la primera en tareas de trabajo de conocimiento matizadas. Las tareas de escritura se apoyaban en el conocimiento del dominio y una lectura cuidadosa por parte de un colega para verificar que encajara. Diferentes trabajos requerían diferentes métodos.
La experiencia fue la mayor barrera para el discernimiento
La IA empodera a las personas para expandir sus capacidades, lo que significa que a menudo realizan trabajo fuera de su área directa de experiencia. Ahí es donde estos participantes encontraron el discernimiento desafiante: es difícil juzgar una respuesta cuando no estás seguro de cómo se ve algo bueno.
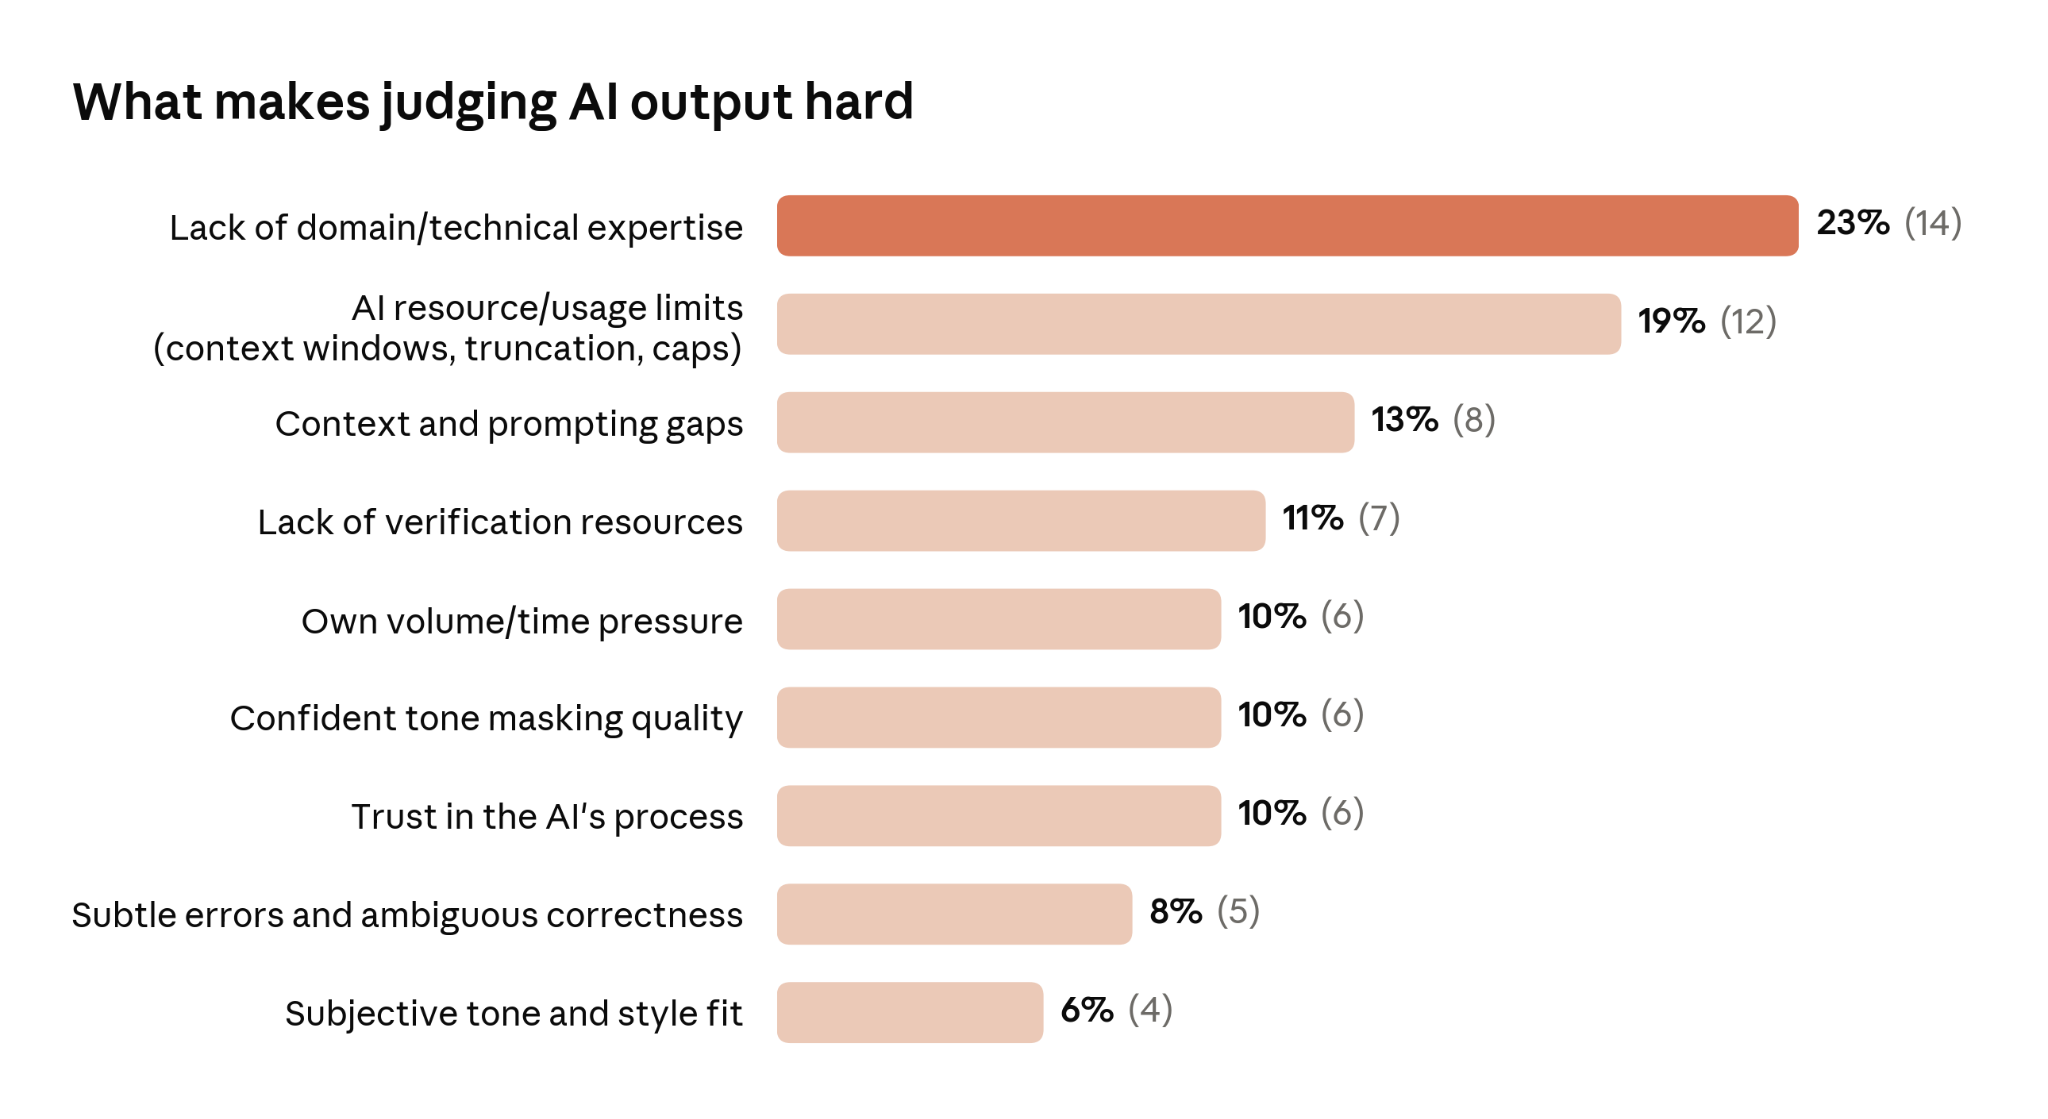
Sesenta y dos participantes nombraron una barrera para el discernimiento. La falta de experiencia en la materia encabezó la lista. Algunos participantes no técnicos describieron a Claude guiándolos a través de soluciones que involucraban desarrollo de software, donde no podían distinguir buenas decisiones de código o arquitectura de las malas. Un aprendiz incluso recurrió a videos de jardinería en línea para acumular el conocimiento del dominio justo necesario para evaluar las recomendaciones de Claude.
Habíamos esperado que la presión del tiempo encabezara esta lista. Para este grupo, el cuello de botella era tener suficiente experiencia en la materia para evaluar la calidad del resultado.
Dejar pasar un error cambió la forma en que las personas trabajan
En todas las entrevistas, hubo 18 relatos significativos de haber pasado por alto un error que Claude había cometido. La mitad de las personas que compartieron una historia así también nos dijeron que cambió la forma en que trabajan hoy. Ver el error les enseñó cómo buscar futuros errores.
Algunas de las nuevas prácticas que estos participantes adoptaron incluyeron:
- Exigir que Claude cite primero su texto fuente, antes de ofrecer una recomendación o análisis
- Crear puntos de aprobación en cada paso de una tarea de varios pasos, en lugar de revisar solo al final
- Usar múltiples agentes de IA a la vez: uno produce el trabajo, otros verifican diferentes partes de él
Para estos participantes, no "verificaron su trabajo con más esfuerzo" ni se convirtieron en expertos en un nuevo campo de la noche a la mañana. En cambio, reestructuraron sus flujos de trabajo y refinaron su conjunto de herramientas de discernimiento.
Construyendo tu conjunto de herramientas de discernimiento
Los discernidores más seguros en este estudio tenían algo en común: un buen conjunto de herramientas. A medida que comienzas a usar la IA para tareas más difíciles y complejas, recomendamos encarecidamente identificar un conjunto de prácticas y flujos de trabajo que puedas usar para validar el trabajo de Claude. Aquí tienes cinco herramientas para comenzar.
- Crea pruebas para validar los productos de trabajo que creas con más frecuencia. Si no eres desarrollador de software, probablemente no tengas "pruebas" para cada pieza de trabajo que haces. Pero la idea se traslada a cualquier campo. Si eres redactor de contenido, crea rúbricas para la voz, el tono y el formato. Si eres abogado, define políticas y reglas que puedas usar para verificar el lenguaje de contrato generado. Prueba esta indicación para iterar con Claude y crear tu propia "prueba" de validación como una habilidad reutilizable que se pueda compartir con colegas:
Quiero crear una verificación reutilizable para un tipo de trabajo que produzco, para poder detectar problemas antes de que salga. Piénsalo como mi propia lista de verificación de control de calidad.
Antes de escribir nada, hazme cuatro o cinco preguntas breves en una sola ronda: qué es el producto de trabajo y quién lo lee; qué hace una versión excelente que una versión aceptable no hace; cómo suelen salir mal estas cosas, incluyendo comentarios que he recibido o errores que detecté tarde; y qué es lo que más me avergonzaría hacer mal. Si te doy un ejemplo de uno bueno, léelo antes de redactar.
Luego convierte mis respuestas en una verificación de cinco a ocho preguntas que pueda hacer sobre cualquier borrador futuro, ya sea que yo lo haya escrito, tú lo hayas escrito, o lo hayamos escrito juntos. Pon la pregunta más importante primero. Haz que cada pregunta sea específica para mi trabajo en lugar de consejos generales de escritura, y asegúrate de que la verificación me ayude a detectar hechos o números incorrectos, razonamientos o afirmaciones que no podría defender si me las cuestionaran, contexto que el lector necesita y que no está en la página, y un tono que no conectará con esta audiencia. No agregues números, umbrales o reglas que no te haya dado.
Entrega la verificación como una habilidad, no como texto en el chat. La habilidad debe aceptar un borrador como texto pegado, un archivo o un enlace a un documento, ejecutar cada pregunta en orden, y citar las líneas exactas del borrador que deciden cada una.
El resultado de la habilidad debe ser una tarjeta de puntuación visual publicada como un artefacto, no un informe de texto: un veredicto en la parte superior que nombre la corrección más importante, una franja de una fila que muestre el estado de cada pregunta de un vistazo (aprobado, reprobado, marcado), y luego una fila por pregunta con el estado, la línea citada y una corrección concreta. La respuesta del chat después de una ejecución debe ser de dos líneas, el veredicto y los conteos. Muéstrame la habilidad para revisarla, luego ejecútala una vez con mi ejemplo para que pueda ver la tarjeta de puntuación.
- Deja que Claude te ayude a identificar oportunidades de discernimiento antes de salir del chat. Anthropic ha publicado una habilidad de discernimiento que detecta tareas complejas e impulsa a Claude a ofrecer sugerencias para una validación adicional. Después de probar esta habilidad con algunas empresas, la evidencia direccional sugiere que insertar pausas en tu flujo de trabajo aumenta el discernimiento. Aquí tienes un ejemplo de lo que la habilidad puso en el chat después de que el usuario pidiera un informe sobre los trabajadores en la ciudad de Filadelfia:
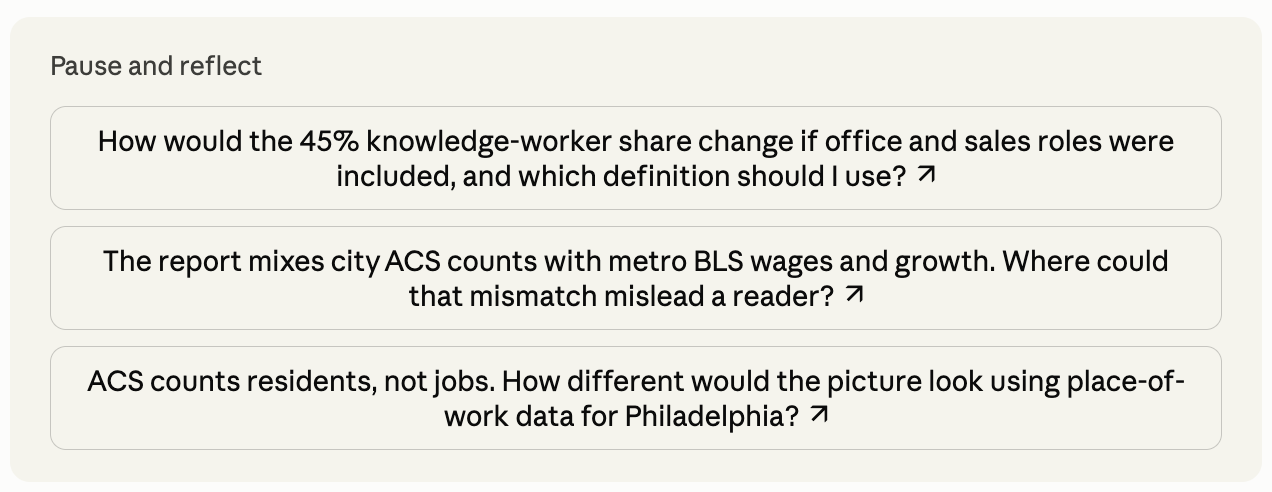
(Un ejemplo de la habilidad discernment-nudge activándose después de completar un informe sobre los trabajadores en la ciudad de Filadelfia)
Puedes instalar la habilidad discernment-nudge pidiéndoselo a Claude aquí:
Por favor, instala este archivo .md como una habilidad:
- Usa revisión adversarial en Claude Code. Claude Code ofrece un paso de revisión adversarial integrada(se abre en una pestaña nueva). Esto significa que Claude puede crear un nuevo subagente para revisar tu código o producto de trabajo desde una nueva perspectiva. Usar un agente que no ha estado involucrado en la construcción del resultado significa que es más probable que detecte errores o suposiciones peligrosas.
Usa un subagente para revisar el diff del limitador de velocidad contra PLAN.md. Verifica que cada requisito esté implementado, que los casos límite listados tengan pruebas, y que nada fuera del alcance de la tarea haya cambiado. Reporta brechas, no preferencias de estilo.
- Construye un panel de expertos. La mayor barrera nombrada para el discernimiento fue la falta de experiencia en el tema en cuestión. Identificar personas a las que puedas llamar para una verificación secundaria amplía tus opciones. Saber a quién llamarías para una segunda lectura en los dominios fuera de tu experiencia, y contactarlos antes de publicar. Luego, por supuesto, devuelve el favor. Cuando un colega te trae algo en tu área de experiencia, tus cinco minutos son lo que hace posible su discernimiento.
Prueba esta indicación para iterar con Claude sobre quién podría ayudarte a discernir tus resultados, basándote en tus intercambios de correo electrónico recientes:
Quiero configurar una verificación de "llamar a un amigo". Antes de confiar en una pieza de trabajo, me ayudarás a encontrar a las personas adecuadas en mi propia red para juzgarla. Guíame por esto un paso a la vez, y espera mi respuesta antes de continuar.
Paso 1: Verifica si mi correo electrónico está conectado. Si no lo está, dame instrucciones paso a paso para conectarlo, luego espera hasta que te diga que está hecho. No adivines nombres.
Paso 2: Pídeme la pieza de trabajo. Puedo subirla, pegar el texto, o pegar un enlace a ella. Si digo que vino de un chat anterior contigo, busca en mis chats pasados; si no puedes, dime cómo activar "Buscar y referenciar chats" en mi configuración, o pídeme que la pegue en su lugar.
Paso 3: Dime en una línea de qué se trata y qué tipo de experiencia se necesitaría para juzgar si es buena.
Paso 4: Busca en mi correo electrónico personas con esa experiencia: personas con las que he intercambiado mensajes sobre este tema, personas que reciben copia de ello, personas que han respondido mis preguntas al respecto, o quienes son dueños de la decisión que esto alimenta.
Paso 5: Sugiere de 2 a 4 personas. Para cada una, da una razón de una línea basada en lo que encontraste en mi correo electrónico, y un mensaje corto que podría enviar pidiéndoles que lo revisen.
Prefiere a personas que conozcan el tema y que cuestionen las cosas, sobre personas a las que simplemente les escribo mucho. No contactes a nadie por mí, y no cites mis correos electrónicos en las notas sugeridas; yo mismo me pondré en contacto.
- Pídele a Claude fundamentación en fuentes. Verificar el trabajo de Claude contra una fuente externa fue una práctica recurrente. Puedes hacer que Claude te facilite este trabajo haciendo que cite las fuentes de cada afirmación en la respuesta. Con esas fuentes en mano, puedes verificar rápidamente qué se sostiene y qué podría requerir investigación adicional de tu parte.
Prueba esta indicación en tu conversación después de haber generado un resultado con Claude:
Para cada afirmación factual en tu respuesta, dime de dónde proviene. Cita el pasaje exacto de la fuente e incluye el enlace o número de página. Si una afirmación proviene de tu conocimiento general, etiquétala como "sin fuente" para que sepa qué verificar primero.
Limitaciones
Estas perspectivas vienen con advertencias importantes:
- Limitaciones de la muestra: Los inscritos en Academy son participantes autoseleccionados y motivados que optaron por mejorar en el trabajo con IA; sus prácticas probablemente se sitúan por encima de una línea base de la población general. La muestra (129 entrevistas, 94 completas) se inclina hacia lo experimentado y técnico, por lo que los desafíos de discernimiento de los usuarios más nuevos están subrepresentados. Estos relatos deben entenderse como un catálogo de prácticas en esta población, no como un punto de referencia universal, y no hacemos afirmaciones de prevalencia sobre los usuarios de IA en general.
- Autoinforme: Todos los datos son autoinformados. Priorizamos los relatos de "guíame por ello" sobre trabajo real y tratamos las calificaciones estructuradas como contexto descriptivo. El recuerdo de "una vez que algo se pasó por alto" está sujeto a sesgo de disponibilidad: es probable que los fallos dramáticos estén sobrerrepresentados frente a los más olvidables.
- Limitaciones de codificación: La codificación temática fue asistida por LLM. Mitigamos esto con listas exactas de transcripciones por tema conservadas para auditoría, validación cruzada determinista (basada en reglas) del módulo estructurado, una revisión humana de al menos el 10% de cada tema, y una recodificación completa de cada dimensión afectada después de la revisión de la rúbrica.
Mirando hacia adelante
Este estudio capturó historias y temas de usuarios avanzados motivados sobre cómo verifican el trabajo de Claude. Nuestra intención era ampliar nuestra comprensión de cómo se desarrolla el discernimiento y qué tácticas funcionan bien en la práctica.
En trabajos futuros, planeamos extender esto a través de estudios de intervención que midan el impacto de la habilidad de discernimiento en las organizaciones y hacer crecer la idea de "pruebas para tu campo" en una biblioteca compartida y específica por rol de verificaciones que todos puedan adoptar y a la que puedan contribuir.
Esperamos que el discernimiento evolucione a medida que los modelos produzcan resultados cada vez más pulidos. Con este y futuros estudios, buscamos hacer visible esa evolución y proporcionar herramientas educativas para que todos las usen.
Bibtex
Si deseas citar esta publicación, puedes usar la siguiente clave Bibtex:
@online{swanson2026aidiscernment,
author = {Kristen Swanson and Maggie Vo and Zoe Ludwig and Jeff Olson and Matt Gallivan and Erik Olesund and Rick Dakan and Joe Feller},
title = {Anthropic Education Report: How people check Claude's work},
date = {2026-09-10},
year = {2026},
url = {https://academy.claude.com/tutorials/discernment-toolkit},
}
Agradecimientos
Kristen Swanson diseñó la investigación, lideró el análisis y escribió este informe con comentarios de Matt Gallivan, Jeff Olson y Erik Olesund. Maggie Vo y Zoe Ludwig contribuyeron a la alineación del marco, la mensajería y la revisión. El Marco 4D para la Fluidez en IA fue desarrollado por Rick Dakan y Joe Feller en colaboración con Anthropic. Mo Julapalli y Ankit Siva proporcionaron soporte técnico. Ryan Donegan y Molly Vorwerck proporcionaron revisión y orientación de comunicaciones.
Notas al pie
- Al investigar cómo las personas describen su uso de la IA, proteger la privacidad de los participantes es primordial. Las entrevistas fueron realizadas por Anthropic Interviewer(se abre en una pestaña nueva), un entrevistador cualitativo impulsado por Claude, bajo su flujo de consentimiento estándar; las respuestas no se vincularon a la cuenta de Claude Academy de un usuario, el progreso del curso, o los datos de conversación de Claude.ai. No aparece información de identificación personal en este análisis. Todos los que se registraron para un curso de Fluidez en IA en Claude Academy durante la ventana de reclutamiento recibieron una nota en su correo electrónico de registro ofreciendo una conversación de investigación opcional. La participación no fue remunerada y fue independiente de la inscripción al curso. De los 129 participantes que comenzaron una entrevista, 94 la completaron totalmente, incluyendo el módulo de encuesta. Los relatos abiertos se analizaron a partir de las 129 transcripciones, ya que las entrevistas parciales frecuentemente contenían una historia de trabajo significativa, mientras que las cifras de la encuesta se basan en el subconjunto que llegó a la encuesta (n=95–98 según el ítem). La codificación temática se realizó de la siguiente manera: un LLM codificó todo el corpus contra las preguntas de investigación, con la lista exacta de transcripciones detrás de cada tema conservada para auditoría. El módulo de encuesta se analizó de forma determinista. Luego, un evaluador humano revisó al menos el 10% de cada tema para identificar inconsistencias de codificación. La rúbrica de codificación se editó en base a esa revisión y cada dimensión afectada se recodificó por completo contra la rúbrica revisada. Todos los nuevos conjuntos de datos codificados fueron nuevamente revisados y analizados por un humano. Este artículo fue escrito completamente por un humano y revisado con la ayuda de IA.
- Del módulo de encuesta (n=95): 63 de 95 encuestados reportaron uso diario, y 62 de 95 reportaron seis o más meses de experiencia con herramientas de IA. La confianza autoevaluada de los encuestados fue más alta para saber cuándo verificar (media de 3.9 en una escala de 5 puntos) y más baja para juzgar la completitud (3.5), con el juicio de corrección en el medio (3.7). Esto es consistente con los hallazgos sobre las barreras de discernimiento: los participantes en general saben que se requiere verificación y la parte difícil es hacerlo fuera de su experiencia.